Содержание
Отчёт «Статистика сканирования» у сайта на сотни тысяч URL показывает: две трети обхода Google — «Загрузка объектов страницы». Стандартный вывод: CSS, JavaScript и картинки отнимают у HTML половину бюджета. Я сверил отчёт с серверными логами этого сайта, 5,4 миллиона строк за 33 дня. В логах CSS, JavaScript и картинки дают меньше процента запросов, а три четверти запросов Googlebot — POST к служебным AJAX-обработчикам. Вероятно, отчёт относит часть этих POST к «Загрузке объектов страницы»; прямой проверки нет, но на своём сайте её можно сделать за вечер: нужны только логи.
Краулинговый бюджет — число URL сайта, которые поисковый робот может и хочет обойти. У Google он складывается из лимита скорости обхода (crawl capacity limit: сколько запросов робот делает к хосту, не перегружая сервер) и спроса на обход (crawl demand: насколько поисковику нужны эти адреса). Бюджет считается на хост, поэтому у поддомена он свой. Яндекс такую модель не публикует: в справке Вебмастера говорится о скорости обхода.
Тема в первую очередь для больших сайтов: Google называет её актуальной от миллиона URL с обновлением примерно раз в неделю. На просмотренных страницах документации метод POST в связи с обходом не упомянут, хотя в логах каталога это три четверти запросов Googlebot. Ниже разобраны логи каталога на сотни тысяч URL, неделя логов портала недвижимости с несколькими миллионами URL и отчёт по классифайду с сотнями миллионов URL в sitemap.
Масштаб выборки
На таком масштабе ошибка в подсчёте стоит дорого. Подделки Googlebot искажают выборку (раздел 3), доля шаблона скрывает число запросов на адрес (раздел 5), а «нулевая отдача» годится для отбора страниц, но не для вывода (дело 2). После разделов стоят блоки «Что делать»: практику можно читать отдельно.
Основа — логи одного крупного B2B-каталога: 33 дня летом 2026 года, около 613 тысяч запросов проверенного Googlebot и 229 тысяч GET страниц основного YandexBot. К ним добавлены выгрузки Search Console и Вебмастера по другим проектам и разбор логов портала недвижимости за неделю. Всё, что сказано про логи, относится к каталогу. Цифры ниже — измерения одного сайта, а не нормы.
Пять находок и что с каждой делать
Три четверти обхода — не страницы и не статика
POST к пяти AJAX-обработчикам: 465 тысяч из 613 тысяч запросов. GET страниц — 23%, CSS, JS и картинки — 0,9%.
Часть «Googlebot» в логах — подделка
6% запросов с подписью Googlebot пришли с 8 648 адресов вне диапазонов Google. Весной пять суток подряд 99% запросов к разделу заказов были чужими.
Одна лента занимает треть обхода HTML
Лента заказов получает 29,2% GET страниц у Google и 43,1% у Яндекса. У 62% её адресов в апрельской таблице нет ни визитов, ни кликов, ни показов. Категории каталога — 4,9%.
Google и Яндекс обходят разные части раздела
Общих адресов ленты 5,12 тысячи. Редиректы и 404 дают 27% запросов Google к ленте, цепочка «верхний регистр → 301 → 404» — 23%.
Секции robots.txt не складываются
В секции Googlebot открыты все пять обработчиков, в секции * четыре из пяти. Блок для Googlebot робот читает отдельно и правила из * не применяет.
Чего в данных нет: замера «после» чистки. Гипотеза «освободим обход, и Google пойдёт на важные страницы» остаётся гипотезой.
Правила игры: что документировано у Google и у Яндекса
Прежде чем читать логи, нужна рамка. Без неё любое число про обход можно объяснить как угодно.
- Краулинговый бюджет — набор URL, которые Googlebot может и хочет обойти. Складывается из лимита обхода (сколько запросов к хосту поисковик делает, не перегружая сервер) и спроса на обход (насколько Google хочет обходить эти URL).
- Бюджет считается на хост: у поддомена он свой. Лимит общий для всех краулеров Google, спрос у каждого свой.
- Ресурсы, которые подгружает рендеринг (CSS, JavaScript, включая XHR), могут расходовать бюджет хоста: об этом сказано в «Myths and facts about crawling». На просмотренных страницах документации метод POST в связи с обходом не упомянут.
- Коды 429 и 5xx снижают лимит обхода. Ответы 4xx, кроме 429, на скорость обхода не влияют, а частота обхода новых 404 со временем снижается; запрос на каждый такой адрес всё же остаётся запросом.
- Ориентиры, после которых тема актуальна: от миллиона URL с обновлением примерно раз в неделю, от десяти тысяч URL, которые меняются ежедневно, или большая доля адресов в статусе «Обнаружена, не проиндексирована». Google называет их «rough estimate».
Яндекс
- Модели с теми же составляющими нет, и в справке Вебмастера говорится о скорости обхода, а не о бюджете. Робот сам решает, какие сайты и как часто посещать. Квота на число страниц в индексе не названа.
- Признак напрасного обхода, который называет сам Яндекс, — число загруженных страниц, сильно превышающее число страниц в поиске. Против него советуют
Disallow,Clean-paramи ответ 429. - Директиву
Crawl-delayЯндекс объявил неучитываемой 15 февраля 2018 года, с 22 февраля 2018 года она не работает. - Для лишних параметров есть
Clean-paramи с 12 декабря 2025 года «Настройка GET-параметров» в Вебмастере. Переобход конкретных страниц запрашивается в разделе «Переобход страниц» (дневной лимит), URL можно передавать через IndexNow. - Рендеринг JavaScript описан в справке отдельным разделом с пометкой «бета».
Обход не сигнал ранжирования: по документации Google он нужен, чтобы страница попала в выдачу. Поэтому цель не в том, чтобы уменьшить число запросов Googlebot. Цель в том, чтобы важные страницы обходились достаточно часто, а ненужные не получали внимания робота.
Search Console говорит одно, лог показывает другое
Отчёт «Статистика сканирования» даёт несколько разбивок: по типу файла (HTML, JavaScript, изображения, JSON) и по типу робота Googlebot (смартфоны, ПК, изображения, «Загрузка объектов страницы»). В последней разбивке больше половины запросов, и вывод напрашивается: ресурсы отнимают у HTML половину обхода.
запросов проверенного Googlebot в логах каталога — POST к пяти AJAX-обработчикамВ Search Console у того же сайта «Загрузка объектов страницы» — 67,6% за 90 дней, но это доля среди всех роботов Google, включая AdsBot и «Агент другого типа». 76% — доля среди проверенного Googlebot без Google-other (он сделал ещё 58 250 POST). Периоды и классификация разные: порядок величин сопоставим, а утверждать, что одна цифра входит в другую, нельзя.
Куда уходят запросы проверенного Googlebot
Разбивка по типу файла у этого сайта показывает HTML 68,6% за 90 дней, а в логах GET страниц всего 23% за 33 дня. Вероятное объяснение: отчёт относит ответы POST-обработчиков к HTML по типу содержимого. Прямой проверки этому в логах нет.
Поэтому вопрос «сколько обхода уходит на ресурсы» поставлен неточно. Точнее спросить так: на что Googlebot расходует запросы, сколько из них попадает на полезные страницы и можно ли перераспределить обход в пользу важных URL.
Статусы нужно считать отдельно по методам
POST растворяют проблему в общей доле: почти все 465 тысяч ответили 200, и на этом фоне проблемные ответы GET не видны. Поэтому я считаю статусы отдельно для каждого метода.
Ответы сервера по методам
GET страниц, 142 тыс. запросов
POST к обработчикам, 465 тыс. запросов
Статика, 5,57 тыс. запросов
Около 9% GET страниц не получили ответ 200. Google пишет, что 4xx (кроме 429) не влияют на скорость обхода, а частота обхода новых 404 постепенно снижается. Каждый такой ответ и каждый редирект остаётся отдельным запросом. Потерей бюджета я эти ответы не называю: они показывают, куда ходит робот.
- Не начинайте с вопроса про ресурсы. Разбейте запросы Googlebot по методу (GET и POST), типу (страница, статика, служебный вызов) и статусу.
- Статусы считайте отдельно для GET страниц. Общая доля 200 скрывает проблему, если рядом есть крупный поток POST.
- Сверьте результат с «Статистикой сканирования»: разбивка по типу файла и по назначению (обновление или обнаружение) покажет, где отчёт и лог расходятся.
Сначала отделите настоящий Googlebot от подделки
Любой подсчёт по логам начинается с проверки адресов. В логах каталога 653 тысячи запросов подписаны как Googlebot. Google описывает два способа проверки: обратный DNS с прямой проверкой и список диапазонов в JSON. Я взял список диапазонов (317 префиксов на 16 октября 2026 года) и проверил его выборочно по второму способу: 40 самых крупных и случайных адресов из «настоящих» (97% запросов) подтвердились обратным и прямым DNS, все 40.
запросов к разделу заказов с подписью Googlebot в одну из весенних волн оказались подделкойПять суток, до 95 тысяч запросов в сутки, около 389 тысяч запросов, все с адресов вне диапазонов Google. Настоящий Googlebot за те же пять суток сделал к ленте и разделу заказов 3 131 запрос, примерно как в обычные дни.
Запросы с подписью Googlebot: кто за ними стоит
Яндекс публикует метод проверки через обратный DNS с последующей прямой проверкой, списков адресов нет. Из 624 адресов, подписанных как Яндекс, обратная запись указывала на yandex.ru, yandex.net или yandex.com у 609 (97,6%); у восьми она вела на чужой хостинг, у семи записи не нашлось. Прямая проверка подтвердила все 609 адресов. Оставшиеся 15 адресов (82 запроса из 229 427) в расчёт не вошли. Доли шаблонов, коэффициент Джини и пересечение с Google остались прежними.
Список диапазонов получен в октябре и применён к апрельским логам; проверка по DNS сделана на адресах периода из основной выборки. Без проверки адресов цифры по логам могут быть сильно искажены: в этом разделе показан именно такой случай.
- Для Google — список диапазонов в JSON на дату логов или обратный DNS с прямой проверкой.
- Для Яндекса — обратный DNS и обязательно прямая проверка: одного обратного запроса мало, запись может быть подделана.
- Отчёты по обходу стройте только по проверенным адресам. Подделки считайте отдельно: это нагрузка на сервер, а не бюджет Google.
- Не берите готовые «белые списки» диапазонов из чужих файлов без сверки. Список, который я сверил с официальным JSON 19 октября, оказался разнородным: в 303 диапазонах узкого списка 119 лежали в
googlebot.json, остальные только в списках запускаемых пользователем запросов Google (user-triggered fetchers), а 51 из 170 IPv4-префиксовgooglebot.jsonв нём отсутствовала. Такая проверка назвала бы часть настоящего Googlebot подделкой. Широкие блоки Google Cloud, которые часто кладут в белый список «заодно», пропускают и чужие боты на арендованных у Google серверах: проверять адрес нужно поgooglebot.jsonили обратным DNS.
Что стоит за POST
Скорее всего, POST к служебным обработчикам — это вызовы рендеринга карточки товара. К этому выводу ведут три косвенных признака. Прямого воспроизведения рендера в логах нет, поэтому это заключение, а не доказательство, и другое объяснение такого поведения Googlebot исключить нельзя.
Все 31 060 POST за одну неделю периода пришли с рефереров на страницах сайта. В запросе к блоку комментариев идентификатор элемента совпал с идентификатором карточки из реферера: 4 175 запросов из 4 175 за ту же неделю.
Медиана — пять POST на страницу-источник за неделю. За 33 дня пять обработчиков дали 99,99% всех POST, остальные девять путей — 62 запроса. На один GET страницы выходит от 0,46 до 0,83 вызова каждого обработчика (на GET карточки товара — от 0,74 до 1,36), поэтому «ровно по одному на страницу» не получается: рендеринг, возможно, идёт не для каждой страницы.
В 89% случаев перед POST был GET этой же страницы от Googlebot в пределах десяти минут, медиана задержки 17 секунд. Для остальных 11% пары не нашлось: рендер, возможно, идёт позже окна, и это гипотеза.
Кто сколько отправляет POST
35 875 POST против 302 519 GET за неделю
33 дня
YandexRenderResourcesBot: 330 тыс. запросов, 319 тыс. из них POST; полоса — доля робота среди всех запросов с подписью Яндекс
Пути обработчиков у Яндекса определены по префиксам. Похоже, это особенность сайта, а не одного поисковика.
По справке Вебмастера, YandexRenderResourcesBot «загружает ресурсы для рендеринга страницы с JavaScript», игнорирует robots.txt, если HTML-страница, на которой эти ресурсы размещены, доступна роботу, и не обращается к ним, если эти HTML-страницы закрыты. Закрыть обработчики для него отдельным правилом нельзя, пока открыта страница.
Ответы обработчиков разные по размеру (размер по логу). Счётчик отдаёт два байта, остальные служебные вызовы до полукилобайта, блок комментариев около 33 килобайт, то есть, похоже, реальный контент страницы.
Из двух байт ответа не следует, что счётчик можно закрыть безопасно: обработчик может записывать событие на сервере. А блок комментариев, закрытый от Googlebot, может пропасть из отрендеренной страницы. Любое ограничение сначала проверьте в «Проверить URL → Просмотреть проверенную страницу»: сравните страницу до и после правки.
Куда уходит обход страниц
Среди GET страниц картина другая. 142 тысячи запросов проверенного Googlebot пришлись на 86,8 тысячи уникальных URL (регистр адреса приведён к нижнему). Шаблоны определены одинаково для обоих роботов; у Яндекса — только основной YandexBot, без рендерящего робота.
Доли GET страниц по шаблонам: Google и Яндекс
исполненные заказы
три пути каталога
Лента заказов — архив выполненных заказов с собственной страницей на каждый. В апрельской таблице (конец апреля 2026: визиты Метрики за год, клики и показы Google с 1 января по конец апреля, статус Вебмастера) у ленты около 174 тысяч адресов. У 108 069 из них (62%) нет ни визитов, ни кликов, ни показов. У 56 795 визиты есть, у 13 393 есть показы Google.
HTML-обхода Google уходит в ленту заказов; категории каталога, на которых строится коммерческая выдача, получают около 5%Доля скрывает разницу в числе URL: у ленты 19,5 тыс. обойдённых адресов и около 2,1 запроса на адрес за период, у категорий около 1 200 адресов и порядка 5–6 запросов на адрес.
Категории обходятся чаще ленты, поэтому по критерию «важное не обходится или обходится редко» ущерба им эти данные не показывают. Вывод скромнее: лента занимает треть HTML-обхода, у 62% её адресов нет ни визитов, ни кликов, ни показов, заметная часть этого обхода уходит на несуществующие адреса (раздел 6). Выиграют ли от освобождения категории, неизвестно. Нулевая отдача не означает, что у страниц нет ценности (дело 2).
Концентрация обхода: коэффициент Джини и кривая Лоренца
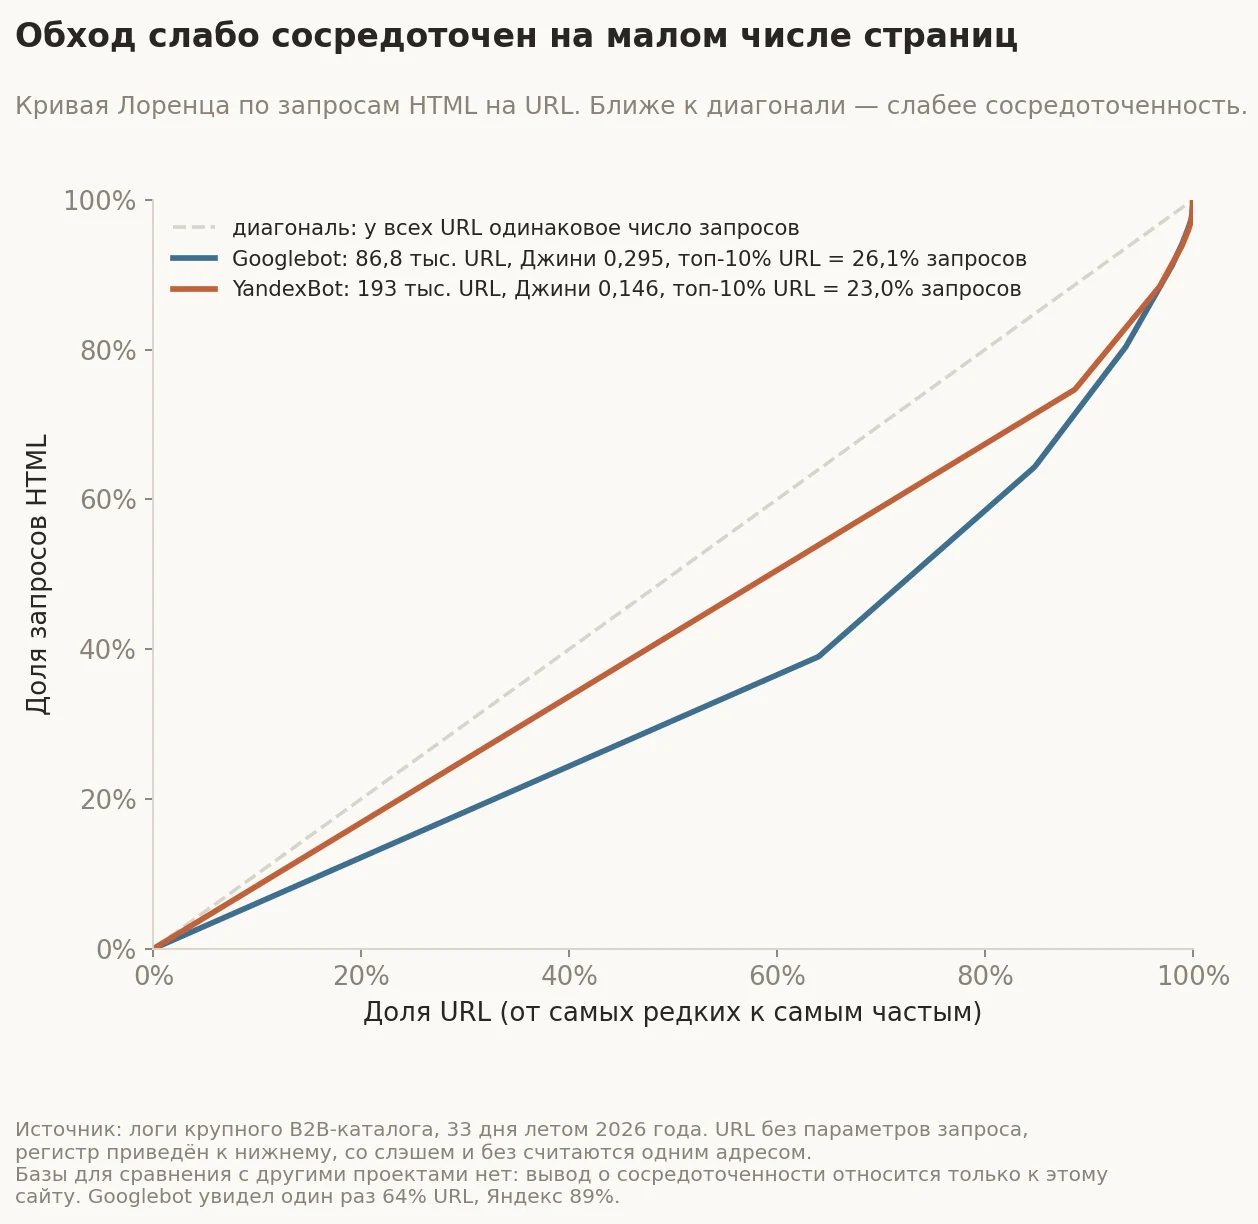
Сильной концентрации на малом числе URL нет ни у одного робота. У Google 10% самых частых URL получают 26,1% запросов (коэффициент Джини 0,295 на 86,8 тыс. URL), у Яндекса — 23,0% (0,146 на 193 тыс. URL). Googlebot увидел за период один раз 64% URL, Яндекс — 89%. Обход распределён по очень большому числу URL и по большей части разово. Окно в 33 дня могло занизить концентрацию: частые адреса за него не успевают набрать повторов.
- Сгруппируйте URL по шаблонам: первый–второй сегмент пути, глубина, наличие параметров. Для каждого шаблона посчитайте запросы, уникальные URL и запросов на URL.
- Рядом положите отдачу: органические визиты, клики и показы, число страниц в индексе.
- Шаблон с высокой долей обхода и нулевой отдачей проверяйте первым. Но «нулевая отдача» — критерий отбора, а не вывод: прежде чем что-то менять, выясните роль шаблона в обнаружении страниц.
Google и Яндекс обходят разные части ленты
Самое неожиданное в логах: два робота обходят в основном разные страницы одного шаблона. Google обошёл 19,5 тыс. адресов ленты, основной робот Яндекса — 86,4 тыс. Общих всего 5,12 тыс.: это 26% адресов Google и 6% адресов Яндекса.
Кто обошёл адреса ленты заказов
Роботов отличают не статусы, а набор адресов
Статусы по ленте тоже разные. Из запросов Google 73,5% получили 200, 13,8% — 3xx и 12,7% — 4xx. Яндекс получил 98,5% ответов 200, 0,4% — 3xx и 1,0% — 4xx. Чтобы понять, чем это объясняется, я сравнил статусы на общих адресах: у Google 97,3% ответов 200 (10 786 из 11 085), у Яндекса 99,8% (6 403 из 6 414). Почти одинаково. Разницу создают адреса «только Google» (14,4 тыс., на них 30 548 запросов): на них 64,8% ответов 200, 17,9% — 3xx и 17,3% — 4xx, все 404. Хотя бы один не-200 получили 4 069 из 14,4 тыс. таких адресов (28%), у «только Яндекс» — 700 из 81,3 тыс. (0,9%).
Вердикт сервера один и тот же. Отличается набор адресов, к которым приходит робот.
Цепочка «верхний регистр → 301 → 404»
Не-200 в ленте — не одна проблема, а четыре разных явления. Основное из них выглядит так:
- Google приходит на адрес в верхнем регистре3 301 адрес. Откуда у робота эти адреса, в логах не видно.4 776 запросов
- Сервер отвечает 301 на нижний регистрШтатный редирект на регистр. Каждый такой редирект — отдельный запрос.3 301 адрес
- Страницы по нижнему адресу уже нетАрхивная страница удалена, и сервер отвечает 404.4 775 запросов
Всего 3xx 5 754 и 404 5 285, вместе 11 039 из 41,6 тыс. запросов Google к ленте (27%). Первые две строки таблицы ниже связаны по адресу (сопоставление по ключу адреса, а не по времени запросов). Это 9 551 запрос, 23% запросов к ленте. Хотя бы один 404 получили 3 601 из 19,5 тыс. адресов ленты в списке Google (18%).
Четыре явления в не-200: таблица
| Явление | Запросов Google | Адресов | Что за ним стоит |
|---|---|---|---|
| 301 с адреса в верхнем регистре на нижний | 4 776 | 3 301 | Редирект на регистр — штатная работа сервера; цель редиректа в этих случаях отвечает 404 |
| 404 на нижнем адресе из той же пары | 4 775 | 3 301 | Страницы архива, которых больше нет |
| 404 на остальных адресах ленты | 510 | 300 | Адреса со случайными идентификаторами, без варианта в верхнем регистре |
| 3xx на адресах в нижнем регистре | 978 | 648 | Причина не установлена |
Что из этого можно предотвратить
Ответ 404 для удалённой страницы корректен, предотвращать нужно не его, а повторные обращения. Запросы первой строки уйдут, только если найти источник ссылок в верхнем регистре, а он в логах не виден. Строки два и три — 404 на удалённые страницы: их станет меньше, если Google перестанет получать такие адреса из ссылок и своей базы. Подтверждённых данными рычагов здесь нет.
Контрольная проверка 19 октября на 40 адресах с 404 и 40 с 3xx подтвердила картину: все 40 адресов с 404 отвечают 404, 34 из 40 адресов с 3xx в верхнем регистре по-прежнему отдают 301 на нижний.
Отдельный источник лишнего обхода — картинки. Запросы к картинкам по адресам внутри раздела ленты, собранным от адреса страницы, получали 301 (минимум 1 338 запросов Googlebot). Похоже, шаблон страницы строит путь к изображению без начального слэша, и каждая страница создаёт собственные «адреса картинок». Это не страницы ленты, в расчёты по страницам они не входят. И ещё один факт для диагностики: 5 753 из 5 754 запросов 3xx к страницам ленты идут на адреса, которые уже заканчиваются слэшем, поэтому причина редиректов не в добавлении слэша.
У двух роботов разный набор адресов, а не разный вердикт сервера по одним и тем же. Значительная часть не-200 у Google — несуществующие страницы архива, к которым он возвращается через варианты адреса в верхнем регистре. Откуда у Google эти адреса, в логах не видно. Гипотеза: он возвращается к адресам из своей базы. Проверить её можно сопоставлением с историей sitemap и внутренних ссылок.
- Разделите не-200 по явлениям: 301 на регистр, 404 на удалённые страницы, 3xx без понятной причины. Для каждого явления причина своя.
- Найдите источник ссылок на адреса в верхнем регистре: sitemap, внутренние ссылки, внешние ссылки, история.
- Проверьте, нужен ли редирект на регистр там, где нижней страницы нет: сервер мог бы отвечать 404 сразу.
- Рекомендация «404 или 410» относится только к действительно удалённым страницам. Для живых страниц ленты и вариантов регистра она не годится.
- Проверьте пути к картинкам в шаблоне: относительный путь без начального слэша размножает адреса.
Один день с пиком в 90 тысяч запросов
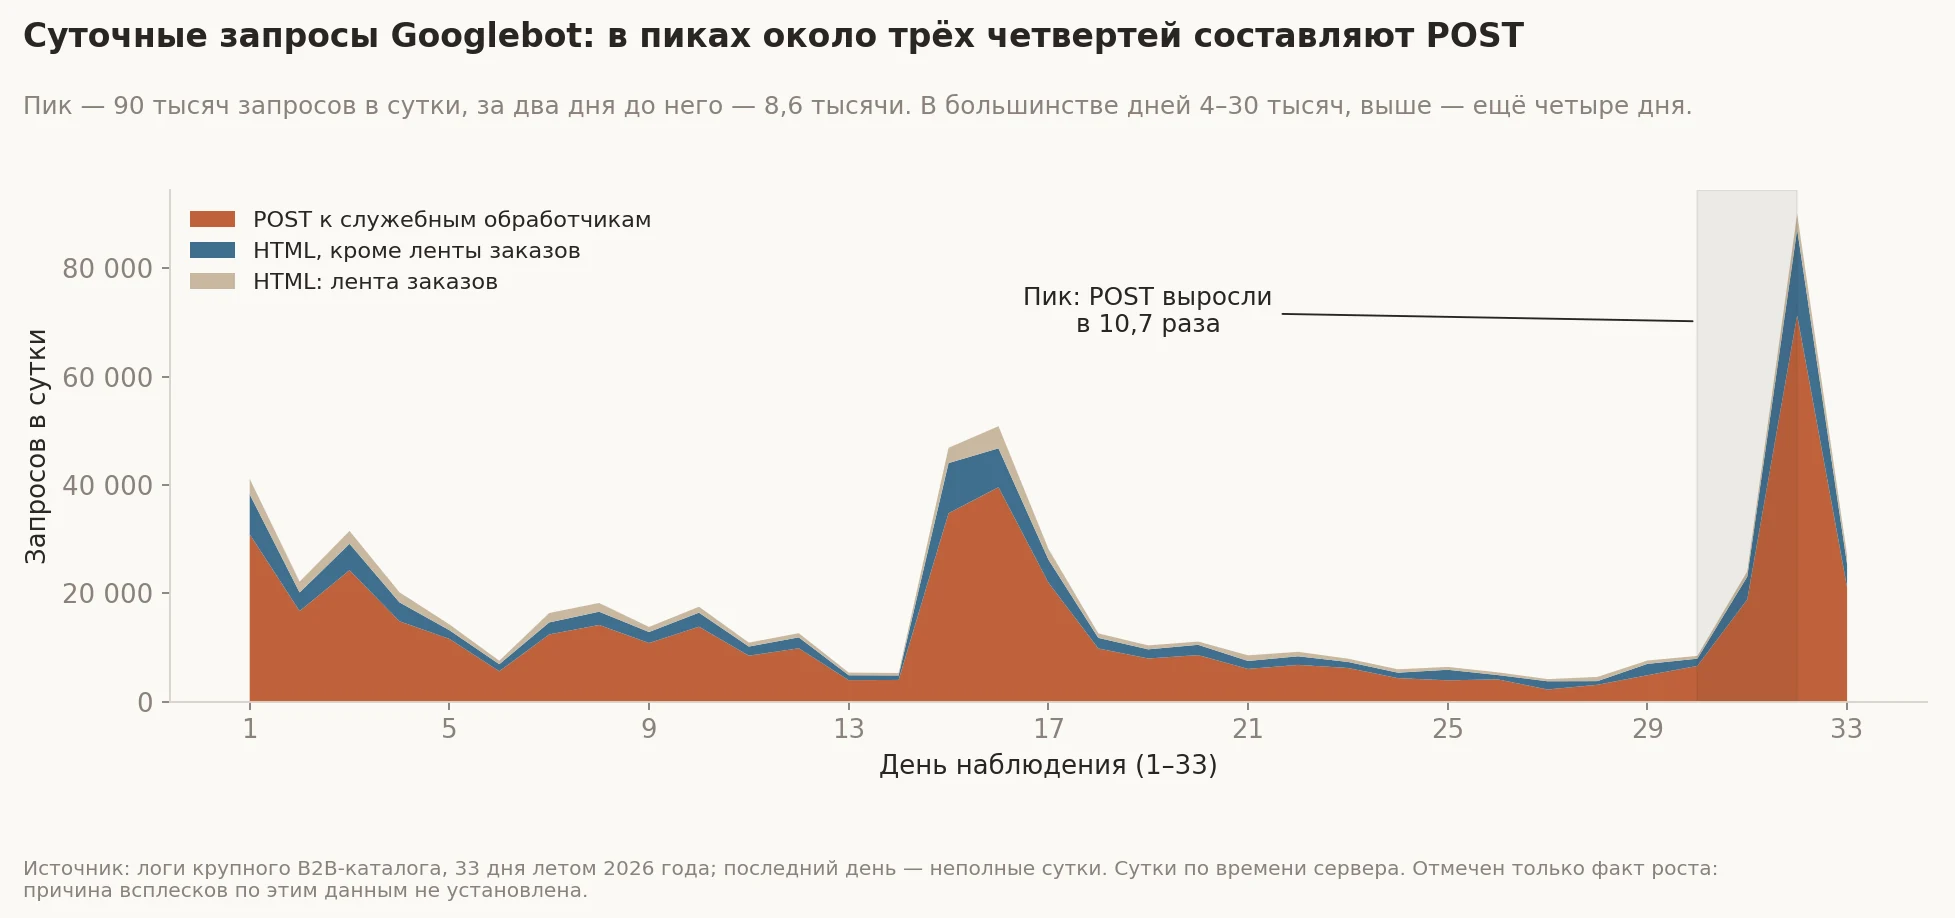
В 28 днях из 33 проверенный Googlebot делает на этом сайте от четырёх до тридцати тысяч запросов. Выше были ещё четыре дня (от 32 до 51 тысячи) и один день с пиком в 90 тысяч — в десять раз больше, чем двумя днями ранее (8,6 тысячи). В пик POST выросли в 10,7 раза (с 6 637 до 71 320), GET страниц — в десять раз (с 1 857 до 18 699). POST составляли 74–79% запросов суток. Причина всплеска по этим данным не установлена.
Суточные запросы Googlebot
Почему обработчики открыты для Googlebot
По живому robots.txt на 19 октября в секции Googlebot для пяти обработчиков нет Disallow, стоят разрешающие Allow для каталогов компонентов и шаблонов CMS. В секции * служебный каталог CMS закрыт, но три обработчика открыты правилами Allow, ещё один лежит вне этого каталога; закрыт только счётчик.
Размер файла за весь период не менялся: все 58 790 ответов 200 на /robots.txt весят 4 221 байт, как живой файл на 19 октября (совпадение размера не доказывает тождество содержимого). Открытость обработчиков это объясняет, но не всплеск одного дня.
- Нанесите на суточный график даты правок robots.txt, перелинковки, чистки sitemap и деплоев. Так всплеск можно проверить на связь с изменениями.
- Сравните живой robots.txt с тем, что вы ожидаете: какие служебные пути открыты каждому роботу отдельно.
- Если всплеск пришёл с POST к служебным обработчикам, смотрите на рендеринг, а не на страницы.
- Добавьте в формат лога время ответа (в nginx
$request_time) и считайте по дням и шаблонам время ответа и долю 304: лимит обхода зависит от скорости ответов, и по этим двум столбцам видно, снижается ли он.
Что показали другие проекты
Остальные проекты представлены агрегатами: выгрузками Search Console и Вебмастера и разбором логов за одну неделю. Независимой выборкой по логам они не являются, поэтому общих закономерностей поведения Googlebot я из них не вывожу. Они полезны как контраст.
Googlebot сделал около 2,4 миллиона запросов, около 340 тысяч в сутки. Два SVG-спрайта получили 446 и 442 тысячи запросов. Ещё 186 тысяч из 249 тысяч 301-редиректов (74,6%) пришлись на адреса карточек /offer/; по отчёту это удалённые объявления, причина редиректа в логе не записана. Запросы отнесены к Googlebot по серверной метке ip_list=googlebot.json в логе.
97,6% запросов — HTML, 75,8% — обнаружение новых URL. Всплески достигают примерно 150-кратной медианы: 80 запросов в сутки против 11 950 в пике. Признаков нехватки бюджета в выгрузке нет. Покрытие, то есть долю обнаруженных страниц, которые обошли, по этим данным не определить.
Sitemap — сотни миллионов URL. Google обработал около 1,35 миллиарда адресов, в индексе 230 миллионов. Около 86% обработанных адресов (1,166 из 1,35 миллиарда) Google нашёл вне sitemap. Одна чистка sitemap этого, вероятно, не исправит: понадобятся правила для параметров и canonical. Это интерпретация, а не результат замера.
На сайте с полными логами «ресурсы» по косвенным признакам оказались POST-запросами, связанными с рендерингом, а на другом проекте крупную долю дали SVG-спрайты. Один и тот же показатель в Search Console скрывает разные причины, и без логов их не различить.
Как сравнивать Яндекс и Google на одном сайте
Сравнивайте по этапам для одного шаблона: доступность, обход, индекс; долю проиндексированных страниц у двух поисковиков по общим счётчикам не сравнивайте, знаменатели у них разные. Для ленты заказов в каталоге обход известен: Google обошёл 19,5 тыс. URL, Яндекс 86,4 тыс., пересечение 5,12 тыс. Сколько из них в индексе, покажет свежая выгрузка из Вебмастера и Search Console по этим адресам.
Когда это действительно бюджет
Диагностическая ошибка номер один — называть бюджетом любую проблему с индексацией. Документация Google описывает три этапа: обход, индексация, показ в выдаче; обнаружение адресов входит в обход, обработка — в индексацию. Статусы в Search Console показывают, на каком этапе остановился адрес.
| Что видно | Где искать причину | Бюджет? |
|---|---|---|
| URL не обнаружен | Перелинковка, sitemap | нет |
| Обнаружен, но не обойдён | Приоритет обхода, нагрузка, спрос, лимит | да |
| Обойдён, но не в индексе | Качество, дубли, canonical, технические сигналы | нет |
| В индексе, но нет показов | Релевантность, спрос, конкуренция | нет |
| Важные URL обходятся редко | Архитектура, обновляемость, приоритет | да |
| Растёт доля 5xx и время ответа | Доступность сервера, лимит обхода падает | да |
Бюджет — причина в строках «обнаружен, но не обойдён», «важные URL обходятся редко» и «растёт доля 5xx». В остальных случаях его оптимизация бессмысленна.
Малый сайт клиники: похоже на бюджет, но это не он
После отправки списка на переобход число адресов, известных Google, выросло. Страницы услуг обходились, но в индекс не попадали. По разбору вероятная причина — пересечение текста с соседней услугой, а не бюджет; контрольной группы нет. Часть адресов Google отклонил по снятой метке noindex: поисковик держит старый вердикт, пока не переобойдёт. На малом сайте статус «просканирована, но не проиндексирована» чаще вопрос качества и дублей, чем лимита обхода.
Как найти потери в логах и Search Console
Порядок работы на крупном сайте. У каждого шага есть результат, по которому видно, что он сделан.
- Проверить адреса ботовGoogle — по списку диапазонов или обратным DNS с прямой проверкой. Яндекс — обратный DNS и прямая проверка.→ чистая выборка
- Разбить запросы по методу и типуGET страниц, статика, POST, служебные обработчики. «Ресурсы» могут оказаться POST-запросами рендеринга.→ структура обхода
- Сгруппировать URL по шаблонамПервый–второй сегмент пути, глубина, параметры. Запросы, уникальные URL, запросов на URL.→ карта шаблонов
- Сопоставить обход с ценностьюОрганические визиты, клики и показы, число страниц в индексе по каждому шаблону.→ кандидаты на проверку
- Посмотреть статусыДоля 3xx и 4xx по шаблону. Разделяйте 301, 404 и повторные обращения к вариантам адреса.→ явления в не-200
- Сверить с Search Console«Статистика сканирования» по типам файлов и назначению, статусы страниц, sitemap против индекса.→ расхождения отчёта и лога
- Нанести на график событияДаты правок robots.txt, перелинковки, чистки, деплоев — чтобы проверить возможную связь изменений с динамикой обхода.→ гипотезы о причинах
Размер ответа в логе Apache оказался завышен примерно в 9,5 раза относительно переданного (вероятно, лог пишет размер до сжатия). Лог пишет время по часовому поясу сервера, а часовой пояс суток в отчёте Search Console в документации не указан, поэтому при сверке по дням учитывайте возможный сдвиг.
Шесть метрик эффективности обхода
Количество запросов само по себе ничего не говорит. Нужны показатели, которые различают «много обходов» и «обходы туда, куда нужно». Четыре из шести считаются по логам.
| Метрика | Как считать | Что показывает |
|---|---|---|
| Доля HTML | запросы GET страниц / все запросы | Структуру обхода (в каталоге: 23%) |
| Доля обхода по шаблонам | запросы к шаблону / HTML-запросы | Куда направлено внимание (лента заказов: 29%) |
| Концентрация | доля запросов у 10% самых частых URL, коэффициент Джини | Сосредоточенность обхода на малом числе URL (26,1% и 0,295) |
| Доля одноразовых | URL, обойдённых один раз / все обойдённые | Широту охвата (64%) |
| Покрытие | обойдённые целевые URL / известные целевые URL | Дошёл ли робот до важного |
| Задержка обновления | время от изменения страницы до следующего обхода | Свежесть |
Покрытие и задержка требуют списка целевых страниц и достоверных дат обновления; при неполном sitemap покрытие считается оценочно. Заведите эти метрики у себя: в этой статье они не рассчитаны. Седьмая метрика, «обход мусорных URL» (запросы к заранее определённым нежелательным шаблонам / все запросы), рабочая, а не показатель Google. Она показывает, что доступно для высвобождения, но не гарантирует, что освободившееся уйдёт на нужные страницы.
Как узнать и посчитать краулинговый бюджет
Готового числа «бюджет сайта» нет ни у Google, ни у Яндекса. Его оценивают по трём источникам, и каждый показывает свою часть картины.
| Источник | Что даёт | Чего не даёт |
|---|---|---|
| Search Console, «Статистика сканирования» | Запросы Google к хосту по дням за 90 дней, типы файлов, назначение обхода, коды ответа, время ответа | Разбивки по шаблонам URL вашего сайта; сверку с логом приходится делать вручную |
| Серверные логи | Каждый запрос: адрес, метод, статус, робот | Проверки подлинности робота: адрес бота проверяют сами, а часовой пояс лога сверяют с отчётом |
| Вебмастер Яндекса | Отчёты об обходе и индексировании страниц, инструменты «Переобход страниц» и «Настройка GET-параметров» | Единого числа «бюджет»: в справке Яндекса речь о скорости обхода |
Расчёт занимает три строки.
- Сколько обходится сейчасЗапросы и уникальные URL проверенного бота за сутки. У каталога: около 613 тысяч запросов Googlebot за 33 дня, то есть примерно 18,6 тысячи в сутки, из них GET страниц 23% — около 4,3 тысячи в сутки (расчёт по данным каталога).→ суточный обход
- Сколько нужноЦелевой обход в сутки ≈ число важных URL ÷ срок переобхода в днях. Условный пример, не данные каталога: 30 000 важных страниц при переобходе раз в 10 суток дают около 3 000 запросов в сутки на HTML. Список важных URL берите из sitemap.xml и карты шаблонов.→ целевой обход
- Куда уходит разницаЕсли обход больше нужного, лишнее ищите в шаблонах, статусах и подделках робота. Если меньше, а лишнего нет, проверяйте скорость ответа и 5xx: по документации Google именно они снижают лимит.→ решение
Разбирать логи можно готовыми анализаторами (например, Screaming Frog Log File Analyser) или своими скриптами. Результат определяет не инструмент, а группировка адресов по шаблонам и проверка подлинности робота.
Чем исправлять найденное
Инструменты не взаимозаменяемы. Каждый решает свою задачу, и выбор неверного инструмента даёт обратный эффект.
| Задача | Инструмент | Оговорка |
|---|---|---|
| Ограничить обход | robots.txt | Не удаляет страницу из индекса |
| Исключить из индекса | noindex при открытом обходе | Робот должен успеть прочитать тег. Это способ убрать страницу из индекса, а не сэкономить бюджет |
| Указать основной дубль | canonical | Рекомендация, не команда |
| Убрать действительно удалённую страницу | 404 или 410 | У Google все 4xx, кроме 429, обрабатываются одинаково; проиндексированный URL с 4xx выпадает из индекса. Документированной разницы по скорости нет. На скорость обхода 4xx (кроме 429) не влияют |
| Лишние параметры в Яндексе | Clean-param, «Настройка GET-параметров» | Работает только в Яндексе |
| Ускорить обнаружение | XML-карта сайта (sitemap.xml), внутренняя перелинковка | Sitemap не гарантирует обход |
| Убрать цепочки редиректов | Внутренние ссылки сразу на конечный адрес | Каждый лишний переход — отдельный запрос робота (в каталоге цепочка «верхний регистр → 301 → 404» давала 23% запросов к ленте у Google) |
| Битые внутренние ссылки | Исправить саму ссылку на рабочий адрес | Редирект с битого адреса оставляет запрос на каждый заход робота |
| Медленные ответы и 5xx | Скорость ответа сервера, кэш | Коды 429 и 5xx снижают лимит обхода Google |
| Снизить повторную передачу | HTTP-кэш, ответ 304 | Нужны корректные Last-Modified и ETag |
Два примера, где выбор инструмента определил результат
robots.txt не снимает из индекса
- Что случилось. В магазине инструментов большой набор страниц личного кабинета и расходных материалов закрыли в robots.txt, и Google всё равно добавил их в индекс (по описанию в рабочем ТЗ проекта).
- Почему. Робот не может прочитать
noindexна странице, которую ему запретили открывать. - Как правильно.
noindexвместо запрета, пока страницы не уйдут из индекса. Это удаление из индекса, а не экономия бюджета: Google советует не использоватьnoindexради бюджета, хотя допускает косвенное освобождение бюджета при долгосрочном удалении страниц из индекса. - Родственный случай. В книжном сервисе около 19 тысяч URL лежали в sitemap и одновременно были закрыты в robots.txt для обоих роботов: сигналы противоречат друг другу.
Секции robots.txt не объединяются
- Что случилось. В каталоге в секции Googlebot открыты все пять обработчиков, в секции
*четыре из пяти. - Почему. Если в файле есть блок для Googlebot, робот читает только его и правила блока
User-agent: *не применяет. - Как правильно. Правку для Googlebot пишите в его собственную секцию. Правка из моего разбора добавляет
Disallowдля служебных путей в каждую секцию (файл с правкой весит 4 679 байт против 4 221 у живого). На 19 октября она не применена: данных «после» нет, вердикт по ней давать нельзя. - Проверка. До запрета сравните отрендеренную карточку в «Проверить URL»: один из обработчиков отдаёт блок комментариев (около 33 килобайт в ответе по логу), и закрытие может убрать его из страницы.
Фасетная навигация
По пересказу вторичных источников (в частности Search Engine Land) годового отчёта Google о проблемах обхода из подкаста Search Off the Record от 3 февраля 2026 года, около половины проблем приходится на фасеты, около четверти на параметры действий, около десятой на нерелевантные параметры. Это доли проблем обхода, а не запросов Googlebot. В документации (страница обновлена 18.12.2025) Google рекомендует закрывать через robots.txt адреса фасетов, которые не нужны в поиске. canonical может со временем снизить объём обхода, но Google ставит его ниже robots.txt, как и nofollow.
Шесть правил для сайта на миллионы URL
Google называет тему актуальной от миллиона URL с обновлением примерно раз в неделю. На таких сайтах дорого стоят шесть ошибок подсчёта. У каждого правила есть число и раздел, где оно разобрано.
- Сначала проверьте адреса ботов, потом считайте6% запросов с подписью Googlebot в логах каталога пришли с адресов вне диапазонов Google (раздел 3).
- Смотрите запросы на URL, а не долю шаблонаЛента с 29% HTML-обхода получает около 2,1 запроса на адрес, категории с 5% — порядка 5–6 (раздел 5).
- Нормализуйте адреса до любого сравненияБез приведения регистра счёт общих адресов у двух роботов получался 22,8 тысячи вместо 5,12 тысячи (раздел 6).
- Каждый робот обходит свою выборкуСтатусы на общих адресах почти совпадают (97,3% и 99,8% ответов 200), разницу создают адреса, которые видит один робот. Выводы по одному роботу на другой не переносите.
- Шаблон на сотни тысяч URL удаляют после проверки роли, а не по нулевой отдачеИз 174 тысяч страниц ленты в список на удаление вошли около 96,5 тысячи. Нулевая отдача — критерий отбора, а не вывод (дело 2).
- Чистка sitemap не лечит обход мимо sitemapУ классифайда около 86% из 1,35 миллиарда обработанных адресов Google нашёл вне sitemap, в индексе 230 миллионов (17%). Здесь нужны правила для параметров и canonical; это интерпретация, а не замер.
Три дела
Три дела: два на сайтах, где счёт идёт на сотни тысяч и миллионы URL, и один на малом сайте для контраста. В каждом есть задача, находка, решение, граница вывода и блок «Что сделать у себя» с порядком проверки и примером. Замера «после» нет ни в одном: это диагностика с планом, а не результат.
Фасеты: какие комбинации заслуживают обхода
- Проект
- Портал недвижимости, несколько миллионов URL со статусом 200 (по разбору логов от апреля).
- Задача
- Понять, какие шаблоны посадочных страниц на фасетах оправдывают обход.
- Нашли
- Листинг с ценовым диапазоном без дополнительных фасетов давал высокую отдачу на URL, выше многих «чистых» разделов. Комбинации из трёх и более фасетов без геопривязки отдавали минимально. Листинги офферов внутри жилого комплекса (большое число URL) дублировали карточку комплекса. Для 1 237 URL Google выбрал другой canonical, чем указал сайт; по выборке в 1 000 URL около 61% из них — новостройки. Крупнейшая находка — карточки объявлений: миллионы URL, по отчёту ни одного в sitemap, подавляющая часть без данных в Search Console, доля Google в поисковых визитах на этом шаблоне ничтожна. Googlebot при этом обходит этот слой активно.
- Решение
- Универсального правила «закрыть все фасеты» из этого не вытекает, решение сведено в матрицу ниже. Для карточек объявлений предложено закрыть их для Googlebot, оставив Яндексу, на 90 дней с контролем трафика, но только после оценки, сколько карточек уже в индексе Google: robots.txt не выводит страницы из индекса, их выводят через
noindexпри открытом обходе. - Граница
- Результата «после» нет: дело остаётся диагностикой с планом.
- Сгруппируйте запросы Googlebot к параметрическим адресам по набору ключей, а не по значениям: так сотни тысяч URL сворачиваются в десятки комбинаций. Скрипт читает лог из стандартного ввода (формат Apache или nginx combined):
Вывод — строки «число запросов, набор ключей», напримерimport re, sys, collections from urllib.parse import urlsplit, parse_qsl cnt = collections.Counter() for line in sys.stdin: if "Googlebot" not in line: continue m = re.search(r'"(?:GET|POST) (\S+)', line) if m: keys = tuple(sorted({k for k, _ in parse_qsl(urlsplit(m.group(1)).query)})) cnt[keys] += 1 for keys, n in cnt.most_common(20): print(n, "+".join(keys) or "(без параметров)")price+roomsилиprice+rooms+sort. Скрипт нужно запускать на проверенных адресах Googlebot (см. раздел 3). - Рядом с каждой комбинацией поставьте органические визиты и число страниц в индексе, заполните ячейки матрицы. Комбинации с тремя фасетами и больше без геопривязки — первые кандидаты на закрытие, одиночный ценовой диапазон — кандидат на поддержку.
- Прежде чем закрывать, оцените индекс: в Search Console, в отчёте «Страницы», отфильтруйте адреса комбинации. Если они в индексе, сначала
noindexпри открытом обходе, затем robots.txt. - Правило пишите в секцию Googlebot, а общие правила из секции
*перенесите туда же: секции не объединяются. Условный пример, ключи замените на свои и проверьте правило на логах до выкатки:User-agent: Googlebot Disallow: /*?*sort= Disallow: /*?*view=
96 тысяч URL ленты без визитов, кликов и показов
- Проект
- B2B-каталог. Для каждой из около 174 тысяч страниц ленты заказов собраны тип, глубина, код ответа, статус в Вебмастере, дата обхода, визиты, просмотры, клики и показы Google (таблица конца апреля).
- Задача
- Решить, что делать с лентой. В список на удаление вошли около 96,5 тысячи страниц с нулевыми визитами, кликами и показами, которые Вебмастер показывает как находящиеся в поиске Яндекса. «Нулевая отдача» здесь критерий отбора, а не вывод.
- Что подготовлено
- Техническое задание: физически удалить страницы и отдавать 410, убрать их из sitemap и внутренних ссылок, закрыть повторную генерацию через импорт и cron, сбросить кэш и сдать отчёт с датой деплоя. ТЗ составлено до разбора логов; после разбора рекомендация другая: удалять ленту только после проверки её роли в обнаружении карточек и данных об индексе.
- Что дали логи
- Лента занимает 29% обхода HTML у Google и 43% у Яндекса. Больше четверти запросов Google к ленте (27%) — редиректы и 404; цепочка «верхний регистр → 301 → 404» даёт 23%. Ответ 404 на удалённую страницу корректен и скорость обхода не снижает (по документации Google), хотя запрос на него всё же занимает робота. Управляемая часть меньше: не больше 4 776 редиректов (около 11% запросов к ленте), и то лишь если найдётся источник ссылок в верхнем регистре. Рычаг не подтверждён, замера нет.
- Граница
- Из нулевых показателей не следует, что ценности нет ни у одной страницы. Адреса похожи на артикулы товаров, то есть на длинный хвост запросов по артикулу. В середине лета в индексе Google было около 65 тысяч страниц (по скриншоту), а нулевые показатели взяты из апрельской таблицы, так что нулевой трафик мог быть следствием неиндексации. Архив мог служить путём, по которому робот находит карточки. Список из апрельской таблицы (около 96,5 тысячи страниц) и около 101 тысячи адресов из летних логов не совпадают. Массовое удаление я называю планом с рисками, а не рецептом. ТЗ не внедрено: ответов 410 в логах нет, на 8 проверенных 19 октября URL из списка отдаётся 200.
- Для каждого адреса из списка на удаление возьмите из логов число обходов и дату последнего обхода отдельно для Googlebot и YandexBot. Адреса, которые роботы регулярно обходят, нельзя считать бесполезными для робота, даже если у них нет визитов.
- Просканируйте сайт краулером и посчитайте входящие внутренние ссылки на эти адреса и исходящие с них на карточки. Если архив — единственный путь к карточкам, удаляйте его только вместе с заменой пути, например со ссылками из категорий.
- Начните с пилота: случайная выборка из списка, по условию 2–3% (для 96,5 тысячи это 2–3 тысячи адресов), остальные трогать не нужно. Выборку берите случайную, чтобы в неё попали и старые, и новые страницы.
- Через 4–6 недель сравните по логам обход карточек до и после, а в Вебмастере и Search Console долю этих страниц в индексе. Если обход карточек не изменился, архив путём к ним не служил, и можно расширять выборку. Если упал, откатывайте.
- Тип ответа выбирайте по таблице раздела 12: 410 только для действительно удалённых страниц, для остальных редирект на ближайший раздел или
noindex.
Перелинковка: управление обнаружением
- Проект
- Малый сайт клиники.
- Что сделали
- В августе семь гидов, на которые раньше никто не ссылался, получили первые внутренние ссылки.
- Что увидели
- Через 12 дней показы в Google выросли у четырёх из семи страниц. Числа малы, контрольной группы нет, поэтому это наблюдение, а не вывод.
- Граница
- Рядом работали другие правки, и по сайту целиком эффект нельзя отнести к ссылкам: показы за те же 12 дней выросли по всему сайту, как и число страниц с показами. На графике «Страницы» в Search Console есть ступенька в середине августа (проиндексированных страниц скачком стало примерно 200 вместо 130), раньше выката перелинковки, и подписывать её нельзя. Похожая ступенька в те же дни есть и у B2B-каталога, поэтому нельзя исключить общий внешний фактор. Показы здесь измеряют не обнаружение: для него нужны даты первого обхода и попадания в индекс по этим страницам.
- Запишите дату добавления первой внутренней ссылки на каждую страницу. Без даты связь ссылки с обходом не проверить.
- Раз в неделю снимайте для этих страниц состояние из «Проверки URL» в Search Console или из URL Inspection API: поле
lastCrawlTimeи статус индексации. API отдаёт дату последнего обхода, поэтому первый обход после ссылки видно только по недельным снимкам. - Возьмите контрольную группу: такие же страницы без новых ссылок. Сравнивайте срок от даты правки до первого обхода и до попадания в индекс у двух групп.
- Показы считайте вторичной метрикой. Они растут и от других правок, а обнаружение измеряют даты обхода и индексации.
Семь утверждений о краулинговом бюджете и что у них с доказательствами
«Чем больше обходит Googlebot, тем лучше ранжирование»
не подтверждаетсяДокументация этого не утверждает: обход нужен для попадания в выдачу, но сигналом ранжирования не служит.
«Закроем лишнее в robots.txt, и страницы уйдут из индекса»
не уйдутСтраницы могут остаться без возможности прочитать noindex. Пример — магазин инструментов (раздел 12).
«Поставим noindex, и обход сократится»
Робот всё равно должен прочитать страницу, чтобы увидеть тег. Google советует не использовать noindex для экономии бюджета.
«Бюджет нужен только очень большим сайтам»
частичноВерно для лимита обхода. Но у малых сайтов бывают другие проблемы (качество, дубли), которые выглядят похоже. Пример — клиника в разделе 9.
«Crawl-delay ограничит Яндекс»
Директива не учитывается с 22 февраля 2018 года.
«Ресурсы забирают бюджет у HTML»
зависит от сайтаДоля запросов на ресурсы не означает квоту на HTML. На сайте с полными логами «ресурсы» оказались POST-запросами рендеринга, на другом проекте крупную долю дали SVG-спрайты. Из доли нельзя сделать вывод об упущенных страницах.
«Освободим обход, и Google пойдёт на важные страницы»
гипотезаНи на одном из моих проектов замера «после» чистки нет.
Чек-лист: как провести такой разбор на своём сайте
- Соберите логи за 4–6 недель и проверьте адреса ботовGooglebot — по официальному списку на дату логов, Яндекс — обратным и прямым DNS.
- Посчитайте запросы по методу, типу и шаблонамНайдите шаблоны с высокой долей обхода.
- Сопоставьте обход с отдачей по каждому шаблонуОрганические визиты и число страниц в индексе.
- Классифицируйте проблему по этапамОбнаружение, обход, индексация. Бюджетом называйте только то, что остановилось на этапе обхода.
- Выберите инструмент по таблице раздела 12Проверьте решение на тестовом URL в «Проверить URL».
- Нанесите дату правки на суточный графикСравните полезный обход до и после, по возможности с контрольной группой URL.
- Через 4–6 недель оцените результатЕсли обход мусора упал, а полезный не вырос, зафиксируйте это: Google не обязан перераспределять освободившееся.
Цифры по логам в этой статье — измерения одного каталога, а не нормы. На своём сайте проверьте и структуру запросов, и ответы на варианты адреса, и robots.txt.
Если у вас крупный каталог или портал и нужен разбор логов, напишите мне. Начну с проверки адресов ботов и карты шаблонов: к ней вернёмся по каждому шагу чек-листа.
Состав данных и как считалось
- Главный источник — логи доступа крупного B2B-каталога: около 5,4 миллиона строк за 33 дня летом 2026 года и ещё 17 миллионов строк за весну; масштаб — сотни тысяч URL. По скриншоту отчёта «Страницы» в индексе Google было около 65 тысяч URL в период логов и 136 тысяч на 19 октября.
- Дополнительно: три выгрузки «Статистики сканирования» Search Console (90 дней), разбор логов портала недвижимости (одна неделя весны 2026 года, 2,65 миллиона строк), отчёты по другим проектам.
- Сырые серверные логи есть только по B2B-каталогу, и всё, что сказано про логи, относится к нему одному.
- Крупные числа по обходу округлены до трёх значащих цифр, поэтому суммы по строкам сходятся приблизительно; проценты и коэффициенты рассчитаны по точным значениям.
- Страницы документации Google и справки Яндекса открыты 19 октября 2026 года. У справки Яндекса дат обновления нет.
Частые вопросы
В документации Google это набор URL, которые Googlebot может и хочет обойти. Он складывается из лимита обхода (сколько запросов к хосту поисковик делает, не перегружая сервер) и спроса на обход. Бюджет считается на хост. Яндекс модель с теми же составляющими не публикует: в справке Вебмастера описаны скорость обхода, директива Clean-param и настройка GET-параметров.
Обычно нет. Google называет ориентиры: от миллиона URL с обновлением примерно раз в неделю, от десяти тысяч URL, которые меняются ежедневно, или большая доля адресов в статусе «Обнаружена, не проиндексирована». Это грубая оценка, а не порог. На малом сайте «просканирована, но не проиндексирована» чаще вопрос качества и дублей, чем лимита обхода.
В логах этого сайта отдельно видна высокая доля POST к пяти AJAX-обработчикам: 76% запросов проверенного Googlebot за 33 дня. По косвенным признакам это вызовы рендеринга, но прямого доказательства нет, и связь с отчётом Search Console данные не подтверждают. У того же сайта «Загрузка объектов страницы» составляет 67,6% за 90 дней; периоды и методики разные, равенства между цифрами нет.
Проверять адрес, а не строку User-Agent: по официальному списку диапазонов Google в формате JSON или обратным DNS с прямой проверкой. В каталоге 6% запросов с подписью Googlebot пришли с адресов вне диапазонов Google. Для Яндекса публикуется только метод проверки (обратный DNS и обязательная прямая проверка), списков адресов нет.
Данные этого не показывают: замеров «после» нет ни в одном из кейсов. robots.txt не удаляет страницы из индекса, а ответы 404 на удалённые страницы, по документации Google, на скорость обхода не влияют. В разделе архива заказов потенциально устранимыми выглядят повторные запросы на редиректы с верхнего регистра (не больше около 11% запросов Google к разделу), но без источника этих адресов и замера после изменений оценить эффект нельзя.
С логов за 4–6 недель. Проверьте адреса ботов, разбейте запросы по методу, типу и шаблонам URL, сопоставьте обход с визитами и индексом по каждому шаблону, нанесите даты правок на суточный график. Бюджетом называйте только то, что остановилось на этапе обхода.
Не сразу. Размер ответа не говорит о роли обработчика: счётчик отдаёт два байта, но может записывать событие на сервере, а блок комментариев отдаёт около 33 килобайт реального контента. Сначала сравните отрендеренную страницу в «Проверить URL → Просмотреть проверенную страницу» до и после правки. Правку для Googlebot пишите в его собственную секцию robots.txt: секции не объединяются.
На малом сайте статус «просканирована, но не проиндексирована» чаще вопрос качества и дублей, чем лимита обхода. На каталоге с сотнями тысяч URL три четверти запросов Googlebot оказались POST к служебным обработчикам, а часть запросов с его подписью была подделкой. Такое видно только по логам, поэтому на крупном сайте начинайте с них.
Одного числа нет ни у Google, ни у Яндекса. Оценивают по трём источникам: «Статистика сканирования» в Search Console (запросы Google по дням за 90 дней), серверные логи с проверкой адреса робота и отчёты Вебмастера Яндекса. Сравните суточный обход с числом страниц, которые должны быть в поиске.
Сначала уберите лишнее: цепочки редиректов, битые внутренние ссылки, дубли и параметры, подделки робота в выборке. По документации Google лимит обхода снижают коды 429 и 5xx, поэтому важны быстрые ответы сервера без ошибок. Спрос на обход зависит от того, насколько страницы нужны поиску и как часто меняются.
По этапу, на котором остановился адрес. Бюджет — причина, если URL обнаружен, но не обойдён, если важные URL обходятся редко или растёт доля 5xx и время ответа. Если страница обойдена, но не в индексе, ищите качество, дубли, canonical и технические сигналы. Если страница в индексе, но без показов, смотрите релевантность и конкуренцию.
Источники документации
Страницы открыты 19 октября 2026 года. Где у страницы есть дата обновления, она указана в названии.
- Управление краулинговым бюджетом (обновлено 22.07.2026)
- Myths and facts about crawling (обновлено 18.12.2025)
- Фасетная навигация (обновлено 18.12.2025)
- Проверка запросов Googlebot
- HTTP-коды ответа и обход