Проблема была не в том, что поиск меня не знает. Проблема была в том, что имя «Станислав Кириченко» знают сразу несколько систем — и каждая понимает под ним разного человека.
Entity resolution, или разрешение сущности, — задача найти среди записей из разных источников те, что описывают одного человека, и не приклеить к ним тех, кто только носит то же имя. Поэтому кейс не о том, как «создать себя» в графе знаний, а о том, как отделить свою идентичность от чужих, которые под этим именем уже существуют. Я вёл эту работу на живом сайте, замерял её и записывал не только то, что сработало. Ниже весь путь с датами и запросами, и в каждом пункте отдельно сказано, что я сделал, что увидел замер и что из этого можно заключить.
Пять Станиславов Кириченко
У неоднозначности имени две формы, и обе я наблюдал не в теории, а в конкретных ответах конкретных систем.
Форма первая, потенциальная неоднозначность. Google Knowledge Graph Search API, официальный интерфейс к графу знаний Google, по запросу «Stanislav Kirichenko» возвращает несколько узлов типа Person. Я снял этот замер 20 августа 2026 года.
kgsearch.googleapis.com, запрос латиницей «Stanislav Kirichenko» без ограничения по языку. В ответе пришли пять записей типа Person с одинаковым именем, у каждой resultScore = 24 и пустые поля, ни описания, ни ссылки, ни изображения. Значит, в графе есть пять кандидатов на имя, и ни один не заполнен настолько, чтобы система уверенно на него опиралась. Документация API называет resultScore индикатором того, насколько объект соответствует запросу. Одинаковые 24 у всех пяти значат, что ни один кандидат не выделяется среди остальных. Для сравнения, тот же API на запрос «Taylor Swift» отдаёт один заполненный узел с сайтом и статьёй. Раз метод различает пустое и полное, значит, дело не в инструменте. Замер повторяется с чужого компьютера: API Explorer на странице метода открывается с уже подставленным запросом, остаётся нажать Execute и сравнить ответ с моим.
ФАКТ. На 13 августа тех же узлов было четыре, на 20 августа стало пять, добавился /g/11zds4kh63. Напрашивается гипотеза, что пятый узел породил мой же элемент Wikidata, созданный как раз 13 августа. Я её проверил, и она не подтверждается тремя признаками. У элемента Wikidata нет свойства P2671 — идентификатора Google Knowledge Graph, то есть структурной связи с графом он не объявляет. У элемента ноль сайтлинков, статьи в Википедии нет, а без неё граф редко собирает описанный узел. И сам пятый узел, как остальные четыре, машинного типа /g/ и пустой. Подтяни граф мой элемент, я ждал бы узел с описанием «SEO specialist», а вижу ещё один безымянный.
НЕ ДОКАЗАНО. Прямой причиной Wikidata, скорее всего, не стала. Косвенную исключить не могу: пустой узел /g/ граф заводит, встретив имя как персону в новом веб-контенте, и таким контентом за неделю могли оказаться мои же свежие профили и ссылки, ещё не сведённые к основному узлу. Происхождение узел не раскрывает, доказать нельзя ни ту версию, ни другую.
Одна проверка сдвинула баланс в сторону второй версии. Я запросил тот же API не по имени, а по латинским связкам псевдонима и профессии — «Staurus SEO», «Staurus Kirichenko», «Kirichenko SEO». ФАКТ. Все три возвращают ровно этот пятый узел, /g/11zds4kh63. Значит, граф уже сводит мои латинские упоминания «имя плюс SEO» в один новый узел. А по чистому «Staurus», без профессии, в топе стоят чужие сущности, музыкант и фарм-компания, и меня там нет вовсе. Похоже на правду, но не доказано. Узел пустой, атрибутов из него не прочитать, поэтому «мой» здесь сильный вывод из отклика на связку, а не подтверждённая запись. Практический смысл двойной. Пятый узел, вероятно, не случайный однофамилец, а моя же зарождающаяся сущность под псевдонимом. И одиночный «Staurus» опорной точкой брать нельзя, его перетягивают чужие сущности, а резолвится только пара с «SEO» или «Kirichenko».
Оговорка к этому эндпоинту. В KG Search API все пять узлов на 20 августа остаются пустыми — по нему кажется, что граф ещё ничего не свёл. Но это только один, консервативный интерфейс графа. Живая выдача Google к этому дню показывает уже другую картину, и к ней я вернусь в конце: эндпоинты Google несинхронны, и по одному пустому API рано делать вывод, что сущности нет.
ФАКТ. По состоянию на 20 августа Knowledge Graph Search API возвращает пять пустых узлов Person «Stanislav Kirichenko», все с resultScore 24. Чего этот замер не доказывает: он не измеряет наличие или отсутствие Knowledge Panel — блока о персоне в правой части выдачи Google. Панель — отдельный сигнал, и его этим API не проверить.
Форма вторая, реальная ошибка разрешения сущности. Это уже не «потенциально». Система прямо связала моё имя с чужим человеком. В научной базе OpenAlex под профилем, привязанным к моему ORCID, на 13 августа висела чужая работа — диссертация по истории 2021 года, к SEO отношения не имеющая. Я её не писал. Машина решила, что она моя, потому что имя совпало, а различающих признаков не хватило.
Вот это и есть самая наглядная демонстрация проблемы: конкретная чужая диссертация, приписанная мне научным агрегатором. Ровно то, что entity resolution должен предотвращать, и что абстрактные пустые узлы показывают куда бледнее.
Оговорю границу кейса сразу. Это история про персону-эксперта. Для товарного бренда или компании набор шагов похож, но веса другие, потому что основная сущность там Organization, а не Person, и часть идентификаторов вроде ORCID неприменима. К этому вернусь в конце.
Как система решает, что два упоминания — один человек
Термин пришёл из работы с данными. Википедия ставит entity resolution в один ряд с record linkage и data matching: это поиск записей из разных источников, которые относятся к одной сущности, в том числе когда общего идентификатора у них нет. Математику задачи в 1969 году описали Иван Феллеги и Алан Сантер. Пару записей сравнивают по признакам, считают правдоподобие совпадения и сверяют его с двумя порогами: выше верхнего — один объект, ниже нижнего — разные, а пары между порогами отправляют на ручную проверку.
Ещё раньше, в 1959 году, Говард Ньюкомб предложил давать больший вес совпадениям по редким значениям. Для однофамильцев это главная мысль всей задачи. Совпадение по имени «Станислав Кириченко» почти ничего не стоит, потому что имя общее. Совпадение по дате рождения или по ORCID стоит много, потому что у тёзок они другие.
Граф знаний Google решает ту же задачу в масштабе веба. По описанию самой компании, он собирает факты со страниц, из открытых и лицензированных баз и к 2020 году накопил более 500 миллиардов фактов о пяти миллиардах сущностей. Как граф взвешивает признаки, Google не раскрывает. Поэтому таблица ниже — рамка для чтения кейса, а не схема его алгоритма.
| Этап | Что делает система | Как это выглядело у меня |
|---|---|---|
| Подбор кандидатов | Отбирает записи, похожие по грубому признаку, обычно по имени, чтобы не сравнивать всё со всем | KG Search API по «Stanislav Kirichenko» отдаёт пять узлов Person, все пустые и с одинаковым resultScore 24 |
| Сравнение признаков | Сверяет атрибуты пары: дату и место рождения, профессию, идентификаторы, ссылки | В разметке Person на сайте: дата рождения 2 мая 1986, место рождения Сумы, ORCID 0009-0001-2914-9541, sameAs на внешние профили |
| Решение по паре | Относит пару к одной сущности, к разным или к спорным | OpenAlex принял совпадение имени за совпадение человека и приписал мне чужую диссертацию по истории 2021 года |
| Склейка | Собирает записи одной сущности в один узел | «Staurus SEO», «Staurus Kirichenko» и «Kirichenko SEO» ведут в узел /g/11zds4kh63, 21 августа по нему открывается карточка «Станислав Кириченко, Исследователь» |
По таблице видно, на каком этапе я мог что-то сделать. Подбор кандидатов и склейку делает сама система, повлиять на них напрямую нельзя. Зато признаки для сравнения можно дать: опубликовать редкие атрибуты, которых нет у однофамильцев, и идентификаторы, которые ни у кого не совпадают. А ошибочное решение по паре, как в OpenAlex, можно оспорить. На этом и строились все шаги ниже.
Что я хотел проверить
Гипотеза формулировалась не как «попасть в Knowledge Graph». Панель в выдаче — следствие, на которое я напрямую повлиять не могу. Управляемая задача другая: сделать машиночитаемую идентичность однозначнее, чтобы системам было проще связать разрозненные сигналы в одну персону и труднее спутать её с тёзками.
Критерии успеха я задал до того, как появились результаты, иначе любой исход можно объявить победой задним числом. Уровней три.
Минимальный успех. Идентификаторы согласованы между собой, на сайте стоит единый @id сущности, внешние профили сходятся на одну персону, а разметка проходит валидатор без противоречий.
Наблюдаемый внешний сигнал. Поисковая или AI-система связывает сайт с персоной. Сайт появляется источником по релевантным entity-запросам или в ответе AI-системы.
Сильный внешний сигнал. Однозначно связанный с персоной Knowledge Panel или KG-объект, либо другой воспроизводимый признак entity recognition. Устойчивость такого сигнала проверяется повторными замерами, и один объект её не доказывает.
Дальше по тексту я держусь этой шкалы: каждый результат отношу к своему уровню и не выдаю минимальный успех за сильный сигнал.
Исходная точка
Сайт sk-seo.ru работает с марта 2026 года. Базовый гайд по entity-профилю я опубликовал 20 мая и от этой даты считаю окно наблюдения.
К 13 августа, когда я снял первый развёрнутый замер идентичности, картина была такой. Knowledge Panel по имени не находилась ни в одном написании, элемента Wikidata не существовало, а OpenAlex связывал имя с чужой диссертацией.
То есть на старте машиночитаемая идентичность либо отсутствовала, либо была ошибочной. Это и есть точка отсчёта, против которой читаются все дальнейшие изменения.
Что изменилось за 92 дня
Сначала результат, потом механика. Ниже таблица за окно с 20 мая по 20 августа. Одна оговорка о датах. 92 дня — это возраст базового гайда, от которого я считаю всё окно. А развёрнутый замер «было» я снял только 13 августа, поэтому в колонке «Было» стоит именно эта дата, и измеренная дельта «было и стало» покрывает не 92 дня, а неделю между 13 и 20 августа. Всё, что происходило раньше, я в цифрах не фиксировал и за рост не выдаю.
Я развёл в таблице два принципиально разных типа строк. Артефакт — то, что создал я сам. Внешний сигнал — то, как отреагировали системы вне моего контроля.
Это разделение и есть нерв всего кейса. За первое я отвечаю, второе только наблюдаю.
| Что мерил | Тип | Было | Стало (20.08) / текущий статус |
|---|---|---|---|
| Knowledge Panel Google (кириллическое имя) | внешний сигнал | не обнаружена (13.08) | появилась 20.08: дата рождения и вуз из моей разметки |
| Узлы «Stanislav Kirichenko» в KG (пустые) | внешний сигнал | 4 узла (13.08) | 5 узлов, score 24 |
| Элемент Wikidata | артефакт | не найден (13.08) | создан 13.08; удалён 01.09 после обсуждения как не соответствующий правилам значимости |
| Person schema с дисамбигуацией | артефакт | частичная | полная, 0 ошибок валидатора |
| Entity-пул запросов, Яндекс | внешний сигнал | не измерялся как пул | 7 кликов / 65 показов |
| Позиция «entity seo для ai», Яндекс | внешний сигнал | не измерялась | 3 (снимок 20.08) |
| Цитирование в Быстром ответе Алисы | внешний сигнал | baseline отсутствует | 2 из 4 проверенных запросов |
| OpenAlex | внешний сигнал | чужая диссертация (13.08) | не обнаружена, заявка применена |
Пара строк намеренно оставлена в статусе «не измерялся» — там, где нулевого замера на старте я не делал. Выдавать отсутствие baseline за «было ноль» — значит рисовать рост, которого не проверял. Где baseline есть, он назван с датой.
Теперь — что было сделано между этими двумя точками, почему так и что там ломалось.
Как я уменьшал неоднозначность
Работа шла слоями, снизу вверх. Сначала собственный сайт как точка правды, потом внешние точки сверки, потом связывание всего этого в один узел.
Каждый слой разбираю по одной схеме, а именно проблема, что сделал, почему так, что могло пойти не так, чем проверил.
Слой 1. Сайт как Entity Home
Проблема. Сайт заявляет, кто я, но для машины он остаётся self-asserted source, то есть источником, который сам о себе свидетельствует. Доверия к нему меньше, чем к внешнему подтверждению, зато он задаёт опорную версию фактов.
Что сделал. На страницах / и /about.html развернул полную разметку Person со свойствами birthDate, birthPlace, homeLocation, единым @id и массивом sameAs из внешних профилей.
Почему именно так. Дата и место рождения работают не на тщеславие, а на дисамбигуацию. Против пяти однофамильцев нужны признаки, которых у них нет и которые их разведут. Владелец сознательно пошёл на публикацию даты рождения (2 мая 1986) и места (Сумы) с этой целью — дать машине различающий атрибут. Единый @id нужен, чтобы разметка на разных страницах ссылалась на один узел, а не плодила новые.
Что могло пойти не так. Межстраничный @id не «склеивается» автоматически. Если сущность полно описана только на двух страницах, а на остальных стоит короткая ссылка-референс, легко получить пустые узлы. Поэтому полное описание Person живёт ровно на двух страницах, а дальше идёт только референс с именем и url.
Чем проверил. Собственным валидатором разметки по всем 44 страницам сайта, ноль ошибок. Это артефакт. Я отвечаю за то, что разметка корректна, но не за то, как её прочитает Google.
Слой 2. Идентификаторы вне собственного домена
Проблема. Сайт свидетельствует сам о себе. Нужны точки сверки за его пределами, в системах, которые я не контролирую целиком.
Что сделал. Завёл ORCID 0009-0001-2914-9541, препринт с DOI на Zenodo, профиль about.me и элемент Wikidata. Все они попадают в sameAs и связываются с сайтом обратными ссылками.
Насколько эти точки независимы. «Внешний» не значит «независимый». ORCID и about.me я веду сам, депозит на Zenodo тоже создаёт автор, так что это self-managed записи, просто на чужой площадке. Wikidata ближе к независимости, её модерирует сообщество и элемент без оснований удалят, но и она не «подтверждает факт» автоматически. Ценность этих точек не в том, что кто-то верифицировал факты, а в том, что они дают графу перекрёстные ссылки на один узел из разных мест.
Чем проверил. Живыми URL и валидностью каждой записи. Про то, что здесь ломалось, идёт отдельный раздел ниже, потому что ломалось много.
Слой 3. Контентный узел
Проблема. Идентичность без содержания остаётся пустым паспортом. Нужен контент, который привязывает имя к нише «entity SEO и AI-видимость», а не просто к строке «SEO-специалист».
Что сделал. Базовый гайд по entity-профилю стал узлом тематического кокона, и недавно я досшил внутренние связи между статьями об AI-видимости. Ссылка на гайд идёт по закреплённому смыслу, «профиль бренда». Тема «как строить» остаётся за ним, а этот кейс отвечает на другой вопрос, «что вышло на живом сайте».
Что пришлось переделывать
Внешние системы описывали меня не так, как я ожидал, и каждое расхождение приходилось находить вручную. Четыре случая, каждый по схеме «ожидал → получил → почему это проблема → исправление → статус».
Zenodo и тип записи. Ожидал, что препринт зарегистрируется как научная публикация. Получил тип Software. А это проблема, потому что внешний источник начинает описывать другой тип объекта, не статью, а программу, и связь «автор и работа» искажается. Сменил тип записи на Preprint. Статус — исправлено.
about.me и роли. Ожидал, что профиль опишет меня как SEO-специалиста. Получил дефолтные роли «small business owner» и «web developer», и они же попадали в meta description страницы. Проблема в том, что внешняя точка сверки транслировала неверную нишу. Задал роли SEO Specialist, SEO Consultant и Researcher вручную. Статус — исправлено.
OpenAlex и чужая диссертация. Ожидал, что профиль соберёт мои работы. Получил приписанную чужую диссертацию по истории. Это прямая ошибка разрешения сущности, чужой объект под моим именем. Подал заявку на отвязку, и на 20 августа чужая работа в профиле уже не обнаружена, заявка применена. Осталась другая проблема, уже не про чужого человека, а про девять записей-дублей вместо двух реальных работ.
Wikidata и references. Ожидал, что утверждения получат источники. Получил другое. На старте references не было вовсе, а часть источников я внёс не тем способом, как отдельные утверждения P973 вместо reference P854 внутри утверждения. На 20 августа references несли 7 утверждений из 20. 1 сентября элемент удалили после обсуждения как не соответствующий правилам значимости Wikidata. Ссылку на него я убрал из разметки Person; повторно создавать элемент без новых независимых источников не следует.
Что показали измерения
Теперь — внешние сигналы, то есть реакция систем. Здесь я особенно строго держу разделение факта, сигнала и недоказуемого, потому что тут проще всего соврать себе.
Цитирование в Быстром ответе Алисы
Методика. Я взял десять запросов из своего же AI-пласта, тех, по которым Яндекс уже давал сайту клики, и прогнал их через поиск ya.ru в браузере с обходом антибота. Для каждого фиксировал, есть ли блок «Быстрый ответ Алисы» и попадает ли sk-seo.ru в источники именно этого блока, а не в обычную выдачу ниже. Блок определял по структуре страницы, чтобы не спутать с органикой.
ФАКТ. 20 августа sk-seo.ru присутствовал среди источников Быстрого ответа Алисы по 2 из 4 успешно проверенных запросов. Первый — «оптимизация сайта под llm», где источником шёл мой разбор по LLM в B2B. Второй — «entity seo для ai» с гайдом по entity-профилю. Оговорка про знаменатель: из десяти запросов в замер вошли четыре, и состав этой четвёрки от ответа Алисы не зависел. «2 из 4» означает два из четырёх, а не из десяти.
СИГНАЛ. На замере за это окно у entity-запросов высокая доля кликов. По маске, заданной до просмотра кликов (entity | entities | сущност | knowledge graph), пул собрал 7 кликов на 65 показах за месяц — на шести запросах, то есть больше клика на запрос. Это высокая плотность для сайта, где у большинства тематических групп клик приходится на десятки показов. Масштаб при этом крохотный: семь кликов — малая выборка, и любое «место в рейтинге пулов» на ней неустойчиво, поэтому я не называю entity «первым пулом сайта» — это было бы натяжкой. Достаточно факта: интерес к теме до сайта доходит, и его можно измерить.
ФАКТ. По запросу «entity seo для ai» на живом снимке 20 августа сайт стоял на 3-й позиции в Яндексе, при средней за месяц 6,6. Выше держались trigub.ru и pr-cy.ru, ниже стоял isakov.work на 8-й.
Это редкая выдача, где вообще ранжируются личные сайты экспертов, а не только агрегаторы.
НЕ ДОКАЗАНО. Нельзя утверждать, что цитирование Алисой вызвано Wikidata, схемой или каким-то конкретным изменением. Я внёс несколько изменений одновременно, контрольной группы нет, а за 92 дня менялись и другие вещи. Совпадение по времени причинностью не является.
Отдельно назову слепое пятно. Весь entity-пул виден только в Яндексе. Google Search Console за тот же период не отдала ни одного entity-запроса. Так что «сигнал» здесь относится к одной поисковой системе, а не к поиску вообще.
Ограничения эксперимента
Раздел о методологии, не о провалах — их вынесу отдельно. Здесь то, что мешает делать из наблюдений сильные выводы, даже когда наблюдения положительные.
- Нет контрольной группы — не с чем сравнить «а что было бы без entity-работы».
- Несколько изменений внесены одновременно — эффект отдельного из них не изолировать.
- У ключевой метрики (Алиса) отсутствует baseline: до работы я её не мерил.
- Ответы Алисы персонализируются — другой пользователь и сессия дадут другой результат.
- Выборка мала: в замер Алисы вошли 4 запроса из 10 запланированных.
- Temporal confounding, то есть смешение с фоном времени. За те же 92 дня менялись возраст сайта, индексация, объём контента, ссылочное и сама выдача. Даже без единой entity-правки часть поисковых метрик сдвинулась бы естественно.
Последний пункт — главный аргумент против соблазна написать «сделал Wikidata → получил третью позицию». Возраст и накопленный контент объясняют часть роста и без всякой сущности.
Отрицательные результаты
А это уже не ограничения метода, а наблюдаемые факты того, что на 20 августа ещё не сошлось. Разница принципиальная: выше было «не могу доказать», здесь «проверил, пока не сложилось».
- KG Search API по латинскому имени 20.08 всё ещё отдаёт пустой машинный узел — этот эндпоинт отстаёт от живой панели (см. ниже).
- В OpenAlex осталось девять записей-дублей вместо двух реальных работ (само ложное связывание с чужой диссертацией при этом исправлено).
- Wikidata: элемент удалён 1 сентября после обсуждения как не соответствующий правилам значимости; ссылка исключена из
sameAs. - По части проверенных запросов Алиса сайт не цитирует, по части entity-запросов кликов нет вовсе.
Ни один из этих пунктов я не заклеиваю формулировкой «зато». Это хвосты, которые ещё не сошлись, и «пока» здесь несёт вес: представления Google не синхронны, одни его эндпоинты уже показывают собранную сущность, другие ещё догоняют пустым узлом. Что сошлось — в последнем разделе, и это оказалось сильнее, чем я ждал на 92-й день.
Что бы я делал сейчас с нуля
Дальше — не универсальный рецепт, а порядок, который сложился в моём случае. Специально не оформляю его как «сделай раз-два-три и получишь панель»: панель появилась в последний день окна, и какой из шагов её вызвал, я не знаю.
Последовательность была такой: сначала Entity Home на своём сайте с полной и непротиворечивой Person-разметкой; затем внешние точки сверки — те, что уместны конкретному человеку; затем связывание их в sameAs; и только потом — измерение, повторяемое во времени. Wikidata в этой цепочке стоит поздно и с оговоркой.
И главное — что из этого вообще применимо не мне, а вам. Набор сигналов зависит от того, кто сущность: человек, эксперт без публикаций или компания.
| Разметка / инструмент | Мне | Эксперту без публикаций | Компании |
|---|---|---|---|
| Person schema | да | да | не как основная (для авторов — да) |
| Organization schema | нет | если есть своя организация | да |
| ORCID | да | только если уместно | обычно нет |
| DOI | да | только при реальной публикации | обычно нет |
| Wikidata | элемент удалён 01.09, оснований не хватило | при наличии оснований | при наличии оснований |
| sameAs | да | да | да |
Таблица не о «можно / нельзя», а о том, что уместно как основная сущность. Эксперт может одновременно вести и Person, и Organization своей практики через worksFor; компания — размечать Person для основателей и авторов. Взаимоисключения тут нет, есть вопрос, что у сущности главное.
Если свести весь кейс к одной мысли, она такая. Я могу доказать, что разметка на сайте корректна. Я могу доказать, что Алиса цитировала сайт. Я не могу доказать, что первое вызвало второе. И вот это разделение — между тем, что ты сделал, что показал замер и что имеешь право заключить, — по-моему, и отличает entity-работу от веры в микроразметку.
Частые вопросы
Прямого индикатора «связал / не связал» ни один поисковик наружу не отдаёт. Косвенно проверяют так: Knowledge Graph Search API по имени показывает, есть ли узел сущности и заполнен ли он; поиск по имени плюс нише — появляется ли ваш сайт как источник; ответы AI-систем — цитируют ли они именно ваш ресурс на вопрос о вас. Ни один из этих замеров не доказывает связывание сам по себе, но вместе они показывают, движется ли образ в нужную сторону. Один замер ничего не значит — нужна серия с одними и теми же запросами.
Нет. Wikidata — не SEO-каталог, и создавать элемент только ради продвижения нельзя: запись без независимых источников удаляют как незначимую. Элемент имеет смысл, когда сущность действительно проходит правила проекта — есть внешние подтверждения существования и значимости. В моём случае ORCID, препринта с DOI и внешних профилей оказалось мало: элемент удалили 1 сентября 2026 года как не соответствующий правилам значимости. Если независимых оснований пока нет, сначала строится внешний след.
Разделяйте то, что вы создали, и то, как отреагировали внешние системы. Созданное — артефакт: схема на сайте, элемент Wikidata, внешние идентификаторы. Реакция систем — сигнал: сайт появился в источниках AI-ответа, вырос трафик по entity-запросам, изменился узел в графе знаний. Результатом считается второе, а не первое. И даже сигнал не доказывает, что его вызвала именно ваша разметка: за то же время меняются возраст сайта, индексация и сама выдача.
В этом кейсе цитирование сайта в Быстром ответе Алисы и трафик по entity-запросам я зафиксировал на контрольном замере через 92 дня после публикации базового гайда. Было ли так раньше, я не мерил, поэтому это момент, когда я снял сигнал, а не момент, когда он появился. Это не нормативный срок и не обещание, одно наблюдение на одном сайте не задаёт сроки для других. Устойчивость такого результата проверяется только серией повторных замеров, а не одной точкой.
Для компании основная сущность — Organization, а не Person, и ORCID с DOI обычно неприменимы: это идентификаторы исследователя. Общее для персоны и компании — согласованность атрибутов, единый Entity Home, sameAs на официальные профили и внешний независимый след. Wikidata в обоих случаях создаётся только при наличии оснований. Компания может размечать Person для основателей и авторов, а эксперт — вести и Person, и Organization своей практики; это не взаимоисключающие вещи.
Нет. По справке Google, блоки знаний создаются автоматически, и вручную Google их не создаёт и не удаляет. Заявить права можно только на панель, которая уже показывается: внизу блока есть ссылка «Заявить права на блок знаний», подтверждение идёт через вход в официальный аккаунт YouTube, Search Console, Twitter или Facebook. После проверки можно предлагать правки, и Google рассматривает их в первую очередь.
Что здесь на самом деле измерено
За 92 дня я сделал три вещи, каждую с приборами на руках. Развёл свою идентичность с чужой, убрав приписанную мне диссертацию из научного профиля — это была прямая ошибка разрешения сущности. Собрал из пустоты согласованную машиночитаемую личность: ORCID, схему без противоречий и связанные внешние профили. Созданный в рамках эксперимента элемент Wikidata позднее удалили из-за несоответствия правилам значимости, поэтому он больше не используется как опорный сигнал. И зафиксировал внешний отклик — на 20 августа как минимум одна AI-система цитирует сайт по моим темам. Сайту меньше года, так что это цитирование само по себе событие этого года, а не давний фон.
И вот тут за время написания статьи произошло то, чего я на 92-й день не ждал. ФАКТ (наблюдение 20 августа): по кириллическому запросу «Станислав Кириченко» Google показал панель сущности — заголовок с подписью «Исследователь» и блок «Сведения» с двумя строками: дата рождения 2 мая 1986 и вуз, Харьковский национальный университет радиоэлектроники. Обе строки — ровно те данные, что я публиковал в схеме сайта и в Wikidata; у Google их без моей entity-работы не было. Панель питается моими атрибутами.
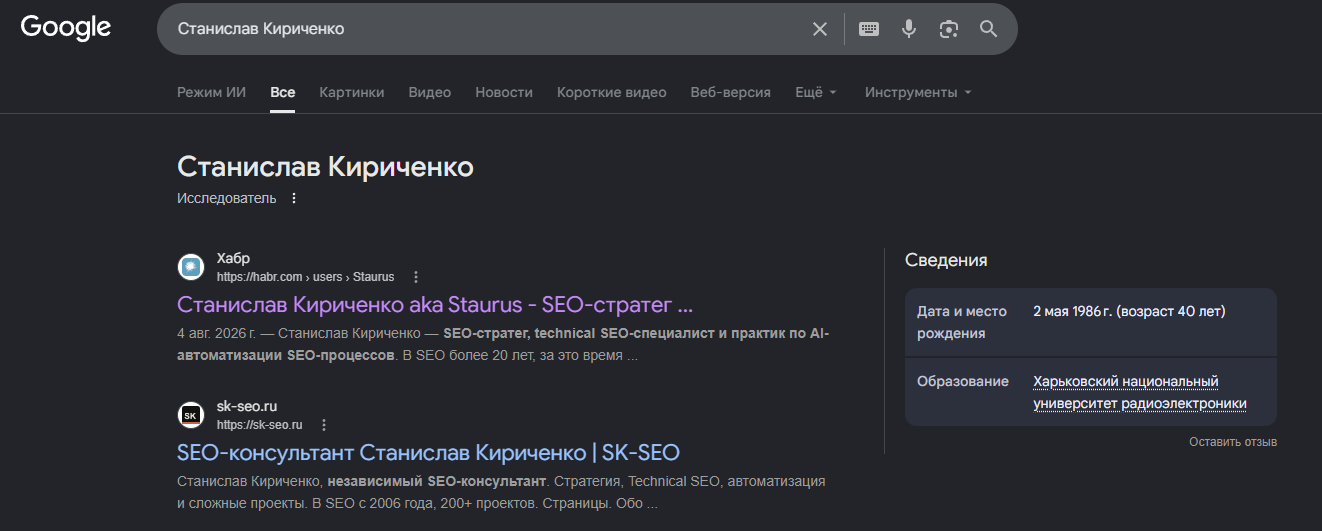
Ту же сущность разные эндпоинты Google показывают несинхронно. Панель на живой выдаче уже показывает атрибуты из моей разметки, а KG Search API по латинскому имени в тот же день ещё отдаёт пустой узел. Выдача, судя по всему, обновляется быстрее этого API.
Назавтра нашлась проверка, которая закрывает вопрос, чей это пятый узел. Карточка открывается по прямой ссылке с идентификатором — google.com/search?kgmid=/g/11zds4kh63, и это ровно тот узел, который накануне отзывался пустой записью на «Staurus SEO» и «Kirichenko SEO». ФАКТ (21 августа): по этому адресу Google отдаёт заголовок сущности «Станислав Кириченко, Исследователь», а первой строкой выдачи идёт мой сайт. Осторожное «похоже на правду» из первой части здесь можно ужесточить: идентификатор панели и пятый узел — одно и то же. Расхождение эндпоинтов при этом никуда не делось. Прямой запрос к API по тому же /g/11zds4kh63 21 августа по-прежнему возвращает пусто, хотя выдача уже рисует по нему карточку.
Что можно сделать с панелью, когда она появилась
Панель знаний, по справке Google, — блок с информацией о людях, местах и организациях из сети знаний, который создаётся автоматически по сведениям из интернета. Заявкой её не вызвать, а для уже показанной можно подтвердить права и предлагать правки. 20 августа, в день снимка, я подал заявку на подтверждение, что панель посвящена мне. Что даёт такая заявка и чего не даёт, Google описывает в справках о проверке и о правках.
| Действие | Можно ли | Как, по справке Google |
|---|---|---|
| Получить панель по заявке | нет | Показ решают автоматические системы: «мы не создаем и не удаляем блоки знаний вручную» |
| Заявить права на панель | если панель уже есть | Ссылка «Заявить права на блок знаний» внизу панели и вход в официальный аккаунт YouTube, Search Console, Twitter или Facebook. Заявить права можно пока не на все блоки |
| Править после проверки | да | Кнопка «Предложить изменения» и URL, которые подтверждают правку. Обработка занимает несколько дней, решение приходит письмом |
| Править без проверки | да | «Оставить отзыв» может любой пользователь, но предложения тех, кто прошёл проверку, Google рассматривает в первую очередь |
Для entity resolution заявка ничего не склеивает. Она закрепляет за человеком узел, который граф уже собрал, и даёт канал для правок, если граф снова перепутает атрибуты.
Чего я всё равно не заявляю. Во-первых, это одно наблюдение, а панель бывает персонализированной и нестабильной — устойчивость подтверждает только повтор замера, и он ещё впереди. Во-вторых, причинность. Панель показывает мои данные, но что её собрала именно моя разметка, а не совпавшая по времени индексация, одним сайтом без контрольной группы я доказать не могу. Что можно сказать без натяжки: за 92 дня имя прошло путь от пяти пустых узлов-однофамильцев и чужой диссертации в научном профиле до панели с моей датой рождения и вузом. Показать этот путь на живых данных, а не рассказать «как надо», — ровно то, ради чего кейс и писался.
Итог такой. Набор entity-сигналов построен, отклик внешних систем измерен, а причинную связь между отдельным действием и этим откликом на одном сайте без контрольной группы установить нельзя, и я её не выдаю. Дальше идёт серия повторных замеров по тем же запросам. Если нужно так же разобрать сущность вашего бренда или сайта, это тема для SEO-консультации.
- Wikidata — ранее созданный элемент удалён 1 сентября 2026 года после обсуждения как не соответствующий правилам значимости; в текущей разметке ссылка не используется.
- ORCID 0009-0001-2914-9541
- Google Knowledge Graph Search API
- API Explorer с запросом «Станислав Кириченко» — повторить замер в браузере
- Панель сущности по kgmid /g/11zds4kh63 — карточка на живой выдаче Google
- Wikipedia — Record linkage — термин, модель Феллеги — Сантера
- Google — A reintroduction to our Knowledge Graph and knowledge panels, 2020
- Справка Google — как подтвердить права на блок знаний
- Schema.org — Person type
- Кириченко С. «Entity SEO: как построить сущностный профиль бренда» — sk-seo.ru, 2026
- Кириченко С. «Как считать трафик из нейросетей» — sk-seo.ru, 2026