Начну с простого, без терминов. Люди всё чаще спрашивают не Google, а ChatGPT, Perplexity или Алису. Те отвечают сразу в чате, и ссылку на сайт показывают не всегда. Значит, привычная схема «попал в топ — получил клик» больше не гарантирует ничего. Это и называют AI-поиском.
Я слушал 55 докладов конференции Tech SEO Connect, где об этом рассказывают люди из Google, Bing и крупных агентств, и записывал цифры, потому что мне нужен был не пересказ трендов, а ответ на простой вопрос — что из этого делать на своём сайте. К середине стало не по себе — цифры не сходятся. Один спикер говорит, что половина страниц, на которые ссылаются нейросети, моложе трёх месяцев. Другая — что средний возраст такой страницы два с половиной года. У одного ChatGPT 1,2 миллиарда пользователей, у другого 900 миллионов. Трафик из AI то около процента, то больше, чем от людей.
Сначала я решил, что кто-то ошибается. Ага, сейчас. Полез проверять. Проверил и понял, что они мерят разное и никто не свёл эти цифры между собой. Отсюда и статья — что из этого работает на практике, что только звучит красиво и что сделать у себя за месяц. Если вы читали конспекты этой конференции и чувствовали, что они не сходятся, дальше будет понятнее.
Главные выводы
Пять вещей, ради которых стоит читать дальше. Каждая — из конкретного доклада, а не из общих соображений.
Если совсем коротко — посыл такой. Сайт теперь продаёт не страница, а абзац, который нейросеть может вынуть и процитировать. Всё остальное в статье — как сделать так, чтобы этим абзацем оказался ваш.
Пятьдесят пять докладов и один вопрос — что здесь вообще работает
55 докладов — это 24 часа 54 минуты записи. Говорят не блогеры, а практики из Google, Bing, команды Chrome и агентств — те, кто эти системы строит и обходит. Три блока публикаций — семнадцать докладов в октябре 2024-го, двадцать в декабре 2025-го и восемнадцать в ноябре 2026-го. Средний доклад идёт двадцать семь минут. Слушал не подряд, а по темам, и записывал, когда числа у двух спикеров расходились.
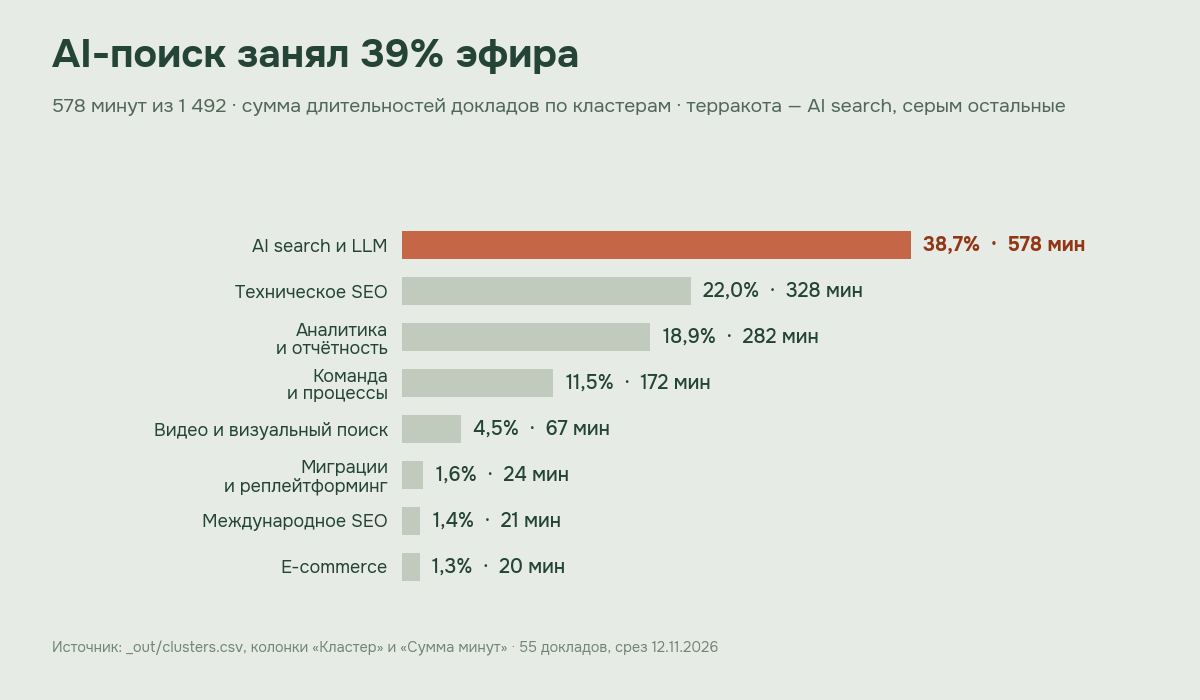
Данные разбора 55 докладов
- 17 докладов, 8 часов 4 минуты
Из них три про AI-поиск, остальное — техника, аналитика и процессы.
- 20 докладов, 8 часов 26 минут
Семь докладов про AI-поиск, появляются первые замеры цитирований.
- 18 докладов, 8 часов 24 минуты
Девять про AI-поиск, больше половины эфира
Вопрос у меня был простой. Если я прихожу к клиенту и говорю «делайте вот это для AI-поиска», откуда я знаю, что это работает? Вы наверняка слышали такие советы (я слышал их от трёх агентств за последний месяц) и каждый раз ловили себя на мысли «а это вообще к нам?». Доклады отвечают по-разному, и разница не в компетенции спикеров. Она в том, что каждый мерил своё и не свёл результат с соседом. Один считал ответы, другой страницы, третий запросы ботов. Цифры после такого сведения не складываются, а расходятся.
Поэтому статья устроена не как конспект. Сначала механика — как ответ вообще собирается и почему страница перестала быть единицей работы. Потом три решения, которые на конференции звучат чаще всего, и три, которые звучат, но не работают. Дальше самое полезное — где практики спорят. И в конце то, что можно сделать у себя за месяц, если времени на всё сразу нет. Давайте по порядку.
Начну с механики, потому что без неё остальное выглядит как набор ритуалов. Многие советы из конференции звучат странно ровно до того момента, пока не поймёшь, как модель читает страницу.
Ограничение, которое стоит держать в голове с самого начала. Это 55 докладов одной англоязычной конференции. Яндекс там почти не обсуждают, а каждый спикер говорит о своих проектах, а не о среднем по отрасли. Поэтому цифры ниже — это чужие замеры, а не рынок. Там, где я их пересказываю, я называю автора, чтобы вы могли проверить любую цифру сами (ссылки на доклады есть в конце).
Нейросеть цитирует не страницу, а кусок страницы
Это главное, что я понял про AI-поиск, и дальше всё становится на места. Модель не читает статью целиком — она режет страницу на куски примерно по 180 слов, оценивает каждый отдельно по своей шкале и берёт тот, который лучше отвечает на вопрос, поэтому в ответ попадает кусок, а не страница.
Пропорцию назвал Metehan Yesilyurt в разборе утёкшего стека ChatGPT. 84% времени ответа уходит на поиск, оценку и переранжирование кусков — по-английски это retrieval. То есть модель почти всё время ищет и сортирует, а не «думает». Слайд считан на GPT-6, в GPT-5,6 было 83%, так что цифра не «вообще про ChatGPT», а про конкретную версию. Я этот доклад пересматривал дважды, потому что в первый раз не поверил.
84% времени ответа уходит на поиск, оценку и переранжирование кусков
Отсюда второй факт, который меняет привычную оптимизацию. Если модель находит релевантный ответ в начале страницы, она прекращает читать и берёт его. В том же разборе звучит цифра — модель фактически читает около 6% страницы. Спикер сам оговаривается, что это может измениться, и я эту оговорку повторяю. Но направление понятное, и оно меняет привычную работу — то, что лежит в середине длинного текста, имеет мало шансов попасть в ответ. Проверьте у себя любую статью с трафиком — ответ у неё в середине или в первом абзаце? Скорее всего, в середине.
Metehan Yesilyurt, «The Leaked ChatGPT Ranking Stack»84% времени ответа — это поиск, оценка и переранжирование.
Что с этим делать практически. Первый абзац должен содержать ответ, а не вступление, каждый абзац должен читаться отдельно от страницы, потому что его могут вынуть именно так, без заголовка и соседей, а заголовки лучше формулировать как вопросы, чтобы фрагмент под заголовком отвечал на конкретный запрос, а не «раскрывал тему». Переставить определение в первый абзац — работа на полчаса, но меняется не только вид страницы, а то, какой кусок вытаскивает модель, и это заметно быстрее, чем правки в мета-тегах, на которые обычно уходит первая неделя. Откройте свой главный шаблон и посмотрите, что у вас в первом абзаце — ответ или «в современном мире».
С размером фрагмента есть расхождение, и оно важное. У Michael King в докладе про query fan-out звучит лимит до 500 токенов, у Metehan Yesilyurt — до 180 слов. Это разные единицы, и пересчитывать одну в другую я не буду (иначе получится математика ради математики).
Пятнадцать процентов? Нет, четверть. Топ-10 больше не пропуск в ответ
Раньше логика была линейной. Попал в топ, получил клик. В AI-поиске эта связка разорвана, и это второй факт, который стоит принять до всех остальных. На своих проектах я впервые увидел это, когда трафик из поиска вырос, а доля кликов не изменилась. Странное чувство, скажу я вам.
Как было
Попал в топ Google — получил клик. Позиция была главной метрикой, потому что из неё напрямую следовал трафик.
Как стало
Попал в топ — получил шанс один к четырём. Сайт цитируют не по позиции, а по куску текста, который отвечает на вопрос.
Josh Blyskal разобрал 250 миллионов AI-ответов и 3 миллиарда цитирований. А в отдельном замере на 1 311 страницах его команда проверила, чем объясняется цитируемость. Ссылающиеся домены, бэклинки и authority score объясняют 4–7% поведения цитирований, R² 0,066, 0,044 и 0,009, и это значит, что остальные 93–96% приходят из чего-то другого — из того, что мы пока не умеем мерить. Внятного ответа на вопрос «из чего» я на конференции не услышал.
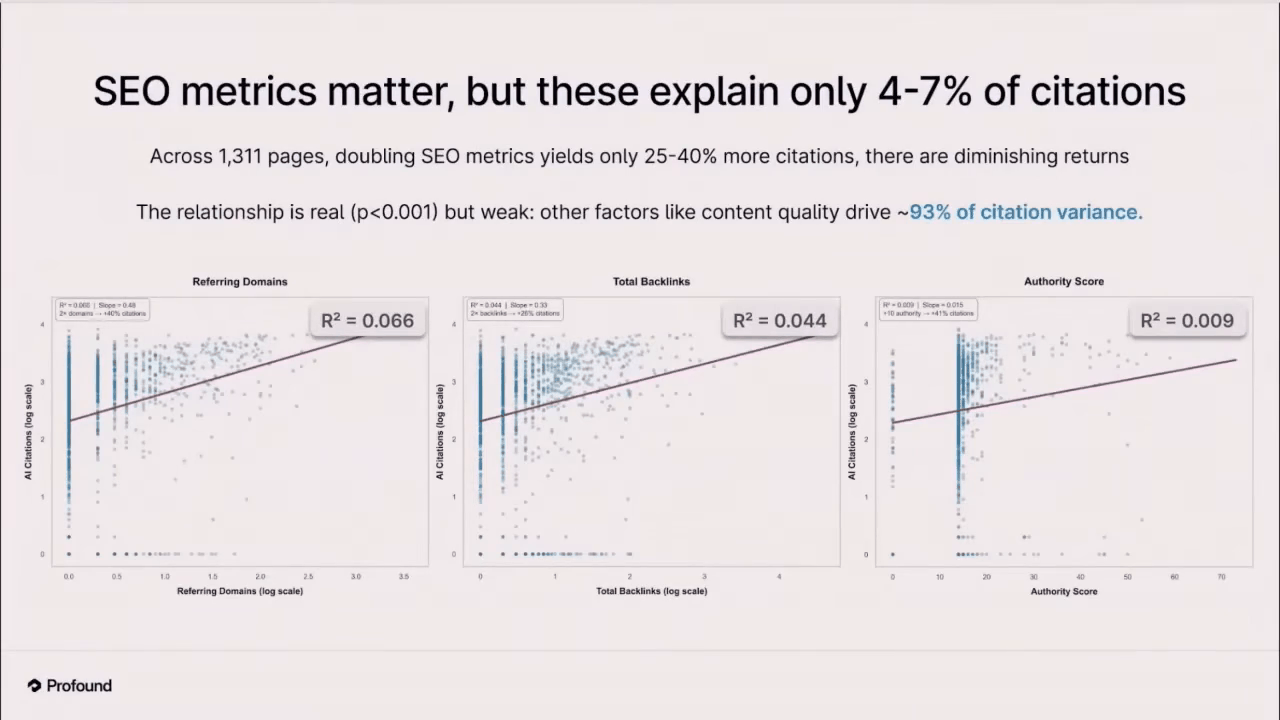
Josh Blyskal, «We Analyzed 250,000,000 AI Search Responses»
Ссылки при этом не умерли. Они перестали быть объясняющей моделью — по ним нельзя предсказать, попадёт ли страница в ответ. Michael King в другом докладе приводит цифру, которая добивает связку с позицией. По исследованию, на которое он ссылается, у страницы из топ-10 Google шанс попасть в AI-каналы — один из четырёх. Для ChatGPT пересечение с топом ещё меньше, 19%. Он говорит прямо, что не может строить бизнес на таком шансе. Не бизнес-план.
Michael King, «Everything You MFs Should Know About Query Fan Out»Я не могу строить бизнес на шансе один к четырём.
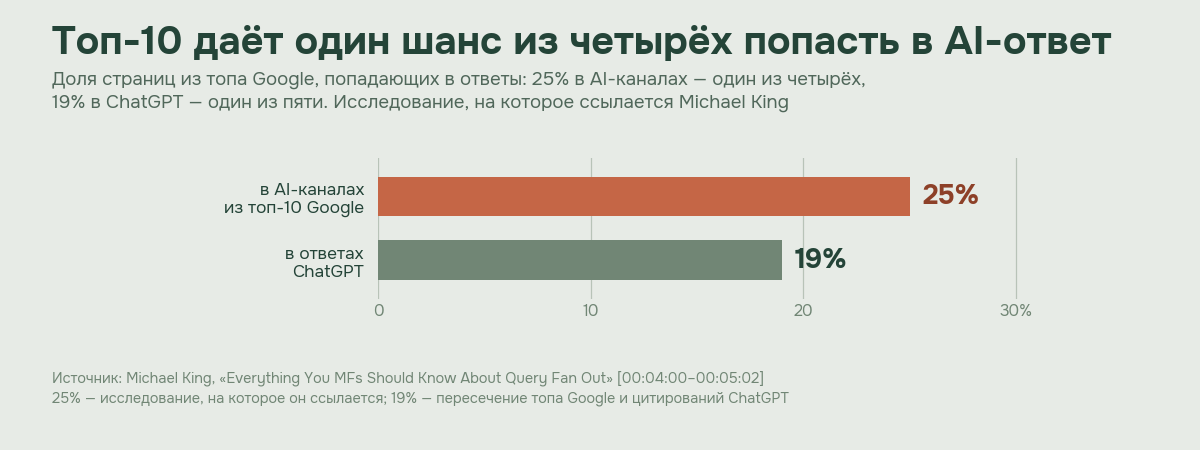
Данные доклада Michael King
Для практики это означает неприятную вещь, к которой я до сих пор привыкаю: отчёт «позиции выросли» может не коррелировать с видимостью в AI-ответах вообще, потому что вы можете быть в топе и не попадать в ответ, и наоборот, а привычные графики этого просто не показывают. И это не повод бросать ссылки. Это повод перестать мерить ими AI-видимость и завести отдельный замер — по двадцати-пятидесяти своим запросам смотреть, цитируется страница или нет. Скажите честно, вы знаете, какие ваши страницы попадают в ответы?
Я бы сделал проще. Взял двадцать запросов, где у вас уже есть позиции, и раз в месяц проверял руками, какие страницы попадают в ответы (мой список лежит в обычной таблице, не в BI). Двадцать запросов, полчаса работы. Через три месяца будет видно больше, чем из любого дашборда.
Query fan-out, или Почему частотность перестала быть планом контента
Третий механизм объясняет, почему привычная семантика перестаёт работать. Модель не ищет по вашему запросу напрямую. Она разворачивает его в десятки подзапросов, и это называется query fan-out. Если вы ещё планируете контент по частотности, этот раздел для вас.
Michael King называет цифру, которая ломает планирование. В его замере на один промпт приходится в среднем 10,7 подзапроса, а максимум доходит до 28. У 95% запросов в query fan-out нет месячного объёма поиска. Их не вводят в поисковую строку, их генерирует модель из вашего промпта, и в инструментах частотности у них просто ноль. Если вы строите контент-план по частотности, вы оптимизируете запросы, которых никто не вводил, и не отвечаете на вопросы, которые модель задаёт сама себе, а потом удивляетесь, почему в ответ попадает не ваша страница. Проверить это просто. Возьмите свой топ-запрос и выпишите десять уточнений, которые человек добавил бы к нему в диалоге. Так и происходит.
Michael King, «Everything You MFs Should Know About Query Fan Out»У 95% запросов в query fan out нет месячного объёма поиска.
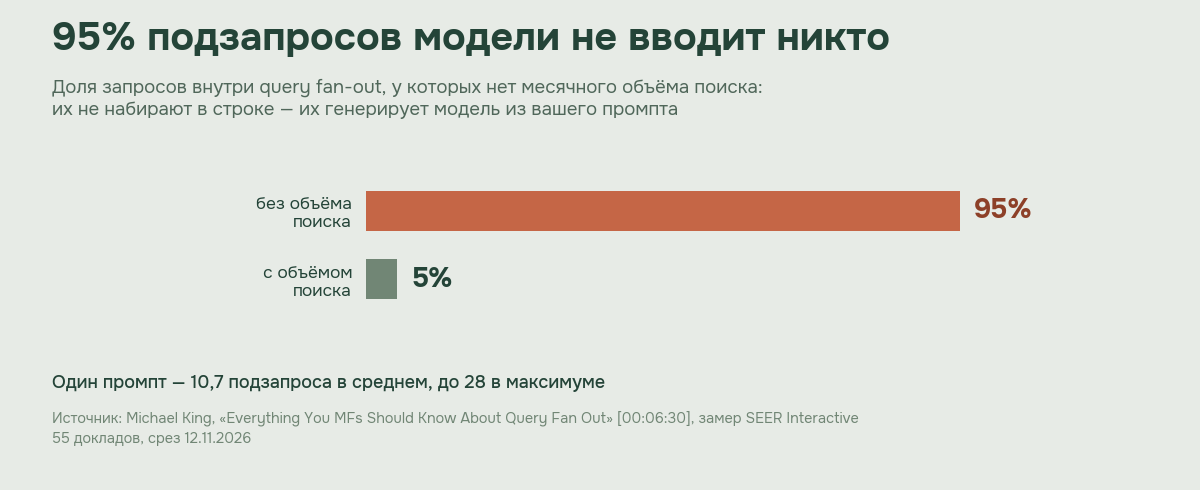
Данные доклада Michael King
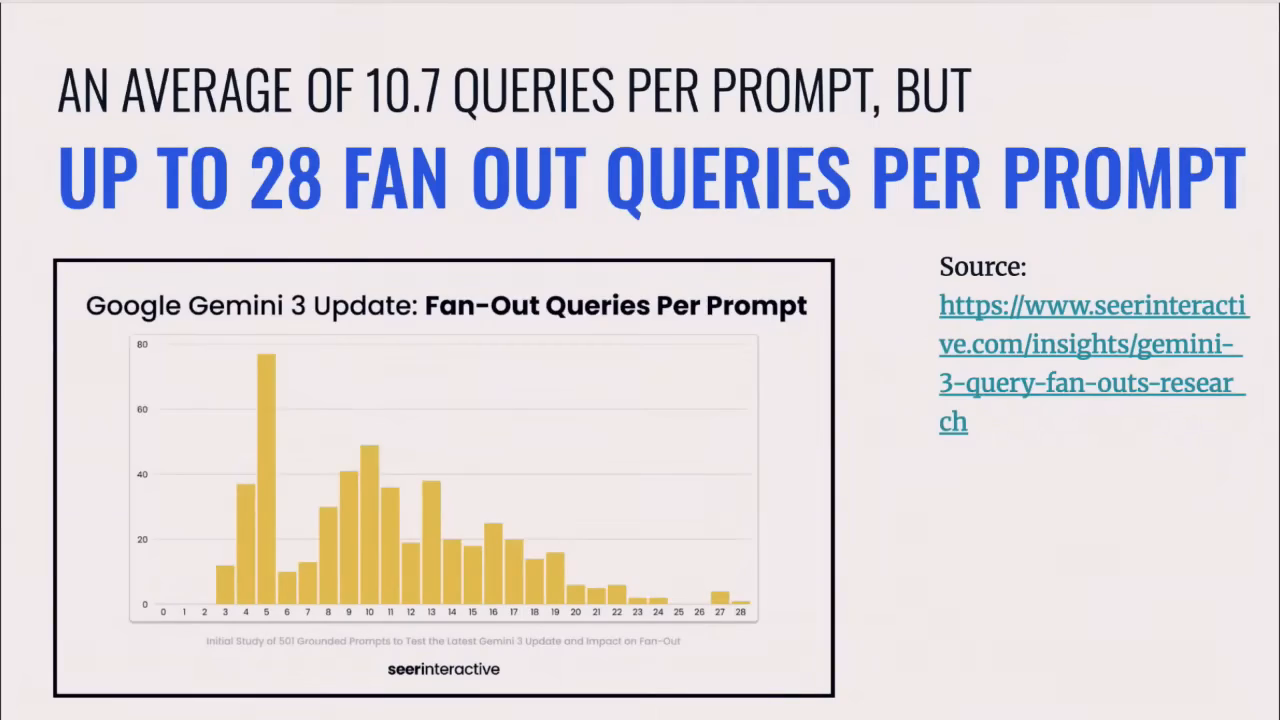
Michael King, «Everything You MFs Should Know About Query Fan Out»
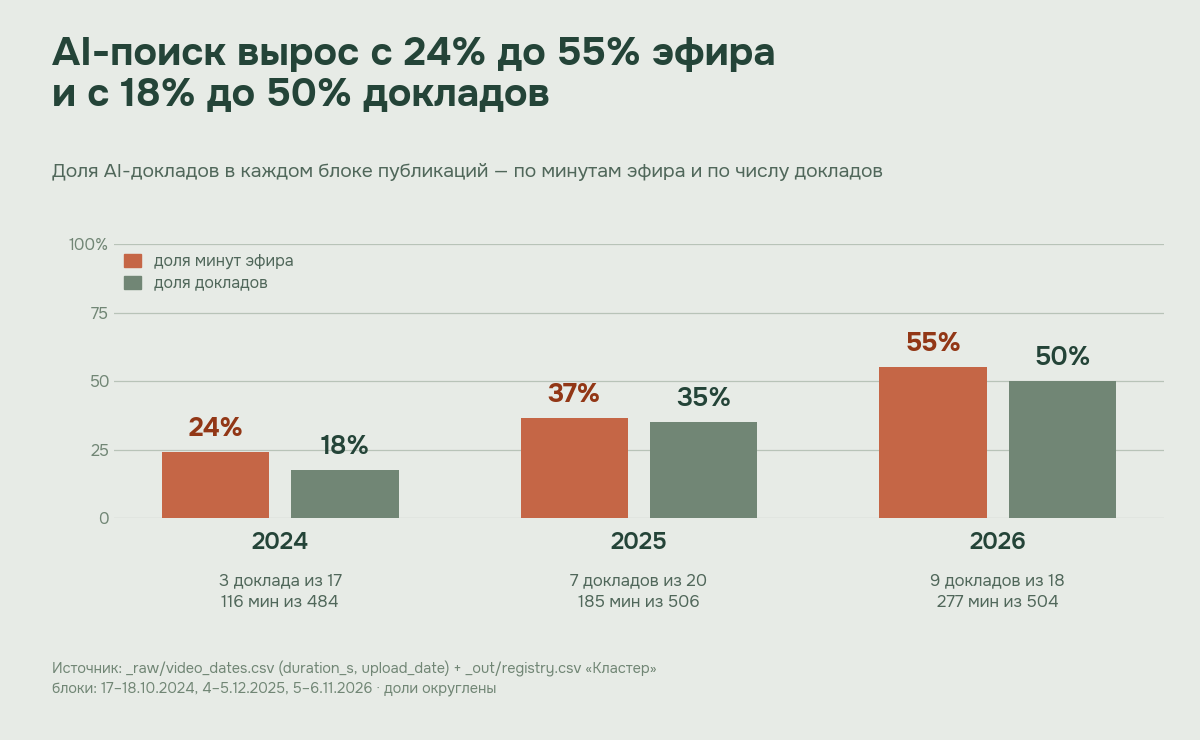
Данные разбора 55 докладов
Семантика от этого не умерла, и я бы не спешил её хоронить — частотность по-прежнему отвечает на вопрос, что люди ищут и как строить структуру сайта, но она больше не отвечает на вопрос, что модель спросит у себя, когда пользователь задаст ей ваш запрос. Второе нужно для контента — перед публикацией разберите тему на пять-десять уточнений, которыми модель могла бы её развернуть, и проверьте, есть ли на странице ответ на каждое. Я такой список теперь держу в брифе (пять минут, а спорим потом меньше).
Заодно это объясняет, почему в выдаче растут форматы, которые раньше считались слабыми. Blyskal в своём разборе говорит, что списки и блоговый контент дают 61% всех цитирований. Не «оптимизированные страницы», не лендинги, а списки и блоги. Answer engines ленивы, и им проще взять готовый перечень, чем собирать его из десяти источников. Лень, как выяснилось, двигатель прогресса.
Три решения, которые звучат чаще всего и не требуют бюджета
Дальше самая практичная часть — три вещи, которые на конференции повторялись чаще других, и все три стоят ноль рублей.
Что из трёх решений делать?
Markdown-дубли страниц. Идея простая — отдать агентам облегчённую markdown-версию вместо тяжёлого HTML. Ответ отрицательный, если речь про отдельный файл. RAG-пайплайн сам превращает нормальный HTML в markdown, поэтому отдельная версия не добавляет ничего, а поддерживать её надо вечно, и это ровно тот случай, когда команда месяц делает файлы, которые потом никто не открывает. Работающий сценарий один — подмена ответа по user-agent через Cloudflare Worker или Vercel middleware. Спикер называет риски прямо — клоакинг по духу правил, путаница пользователя, когда фрагмент из ответа не находится на странице, и расхождение между тем, что на странице, и тем, что попало в ответ. Тратить на это неделю не стоит. Тот же результат даёт чистый HTML с сильными заголовками и без div-мусора. Мы это проходили с адаптивными версиями страниц: поддерживать второй формат дороже, чем один раз привести в порядок основной.
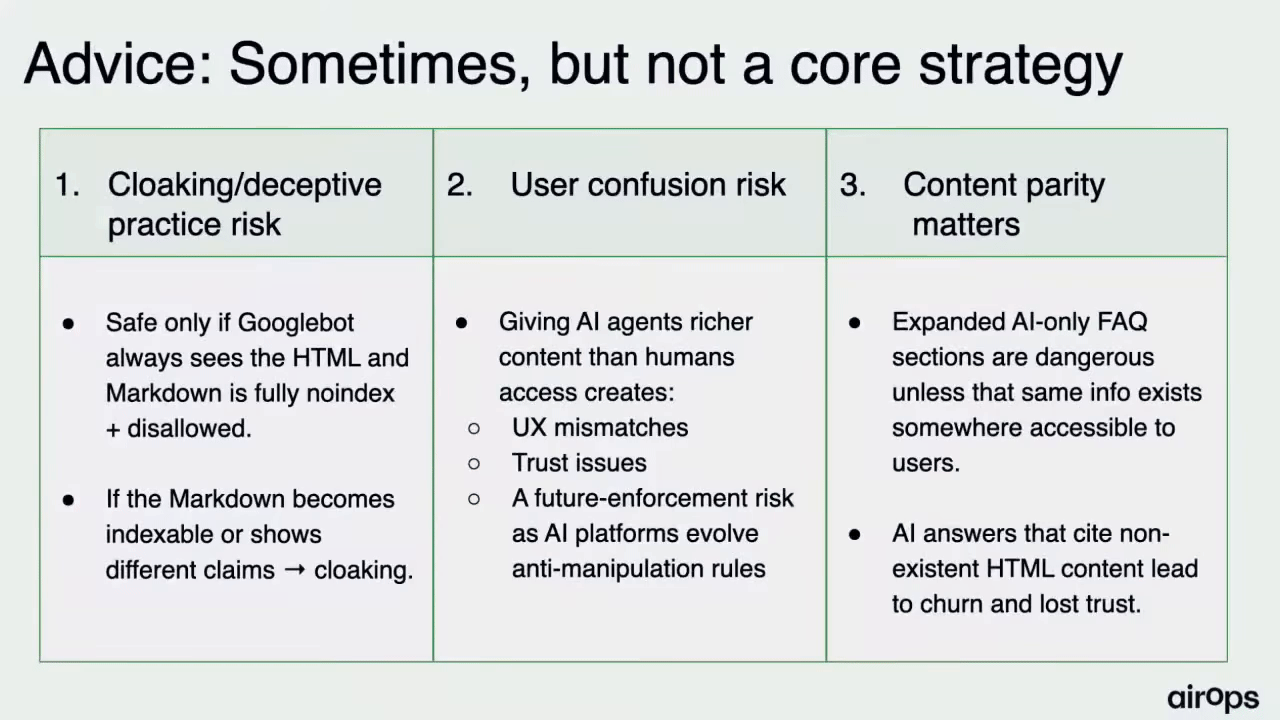
Alex Halliday, «Should We Do This Yet?»
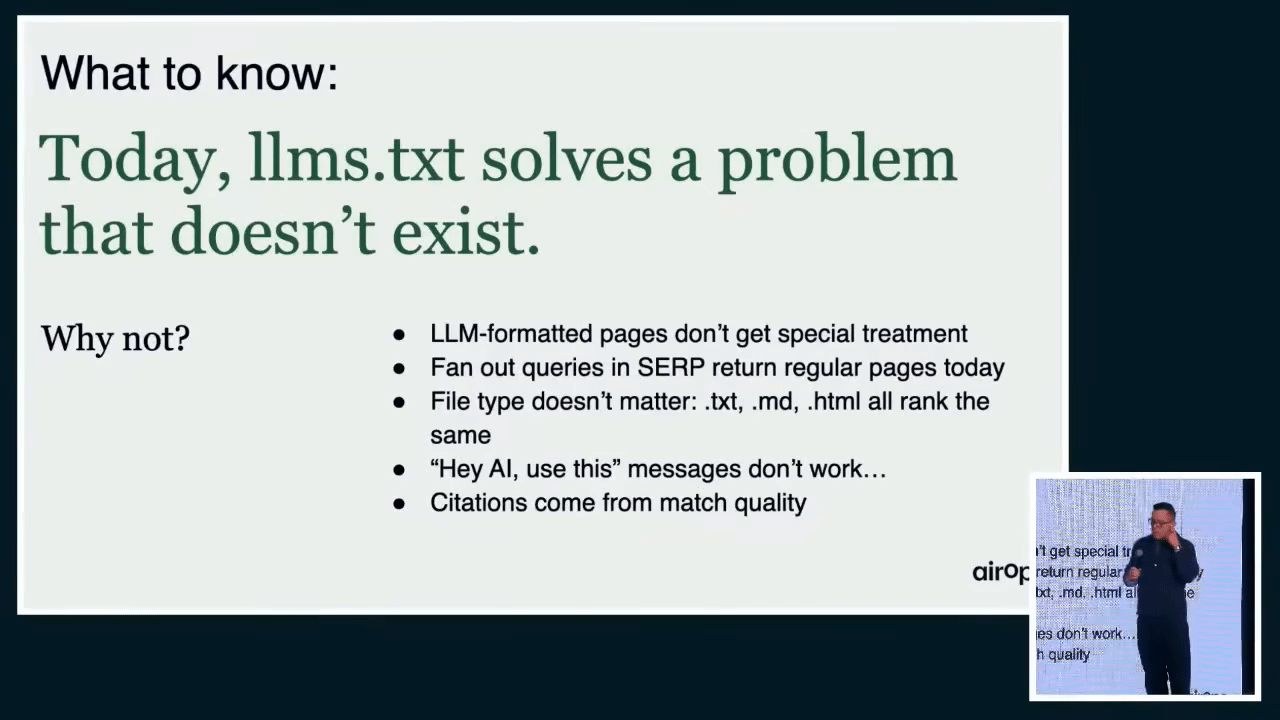
llms.txt. Ответ короткий — нет. Аргумент не в том, что идея плохая, а в том, что она решает проблему, которой пока нет — fan-out видит тот же SERP, что и человек, тип файла ничего не меняет, retrieval в 99,9% случаев делает один хоп, а не обходит сайт по карте ссылок, и пока стандарт поддерживает одна сторона, файл лежит мёртвым грузом. Если файл у вас лежит без дела, вы ничего не потеряли. Пока его не читают. Ну-ну.
Alex Halliday, «Should We Do This Yet?»llms.txt решает проблему, которой не существует.
Alex Halliday, «Should We Do This Yet?»
Блоки ответов. А вот это делать. Модель ищет короткий декларативный фрагмент, который можно вставить в ответ, значит страница должна такие фрагменты содержать (и вы можете проверить это на своей же выдаче — посмотрите, откуда взят ответ). Определение в первом абзаце, FAQ, раздел ключевых фактов, пошаговые блоки, резюме сверху. Плюс сигналы свежести и авторитет в первом предложении. Это не отдельная технология, а нормальная редактура, и тут я согласен с докладом полностью — переписать один шаблон страниц дешевле и полезнее, чем делать файлы для агентов, которые те пока не читают, а читать начнут неизвестно когда.
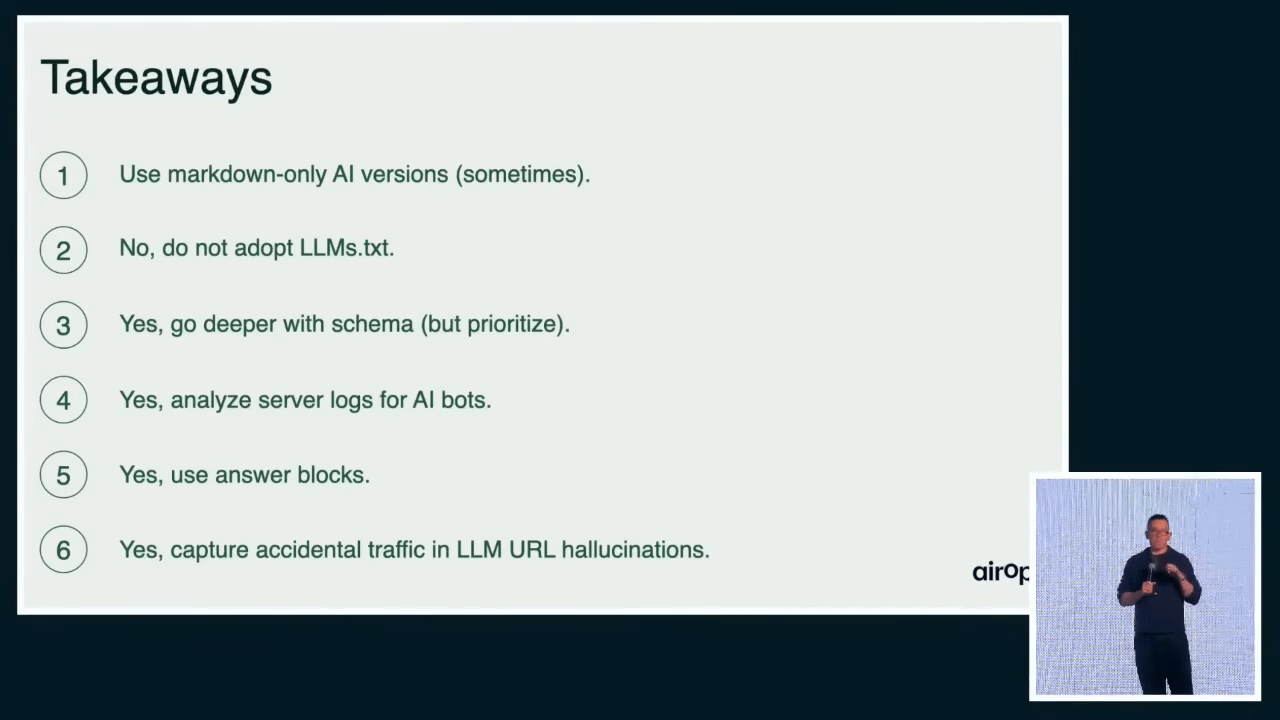
Alex Halliday, «Should We Do This Yet?»
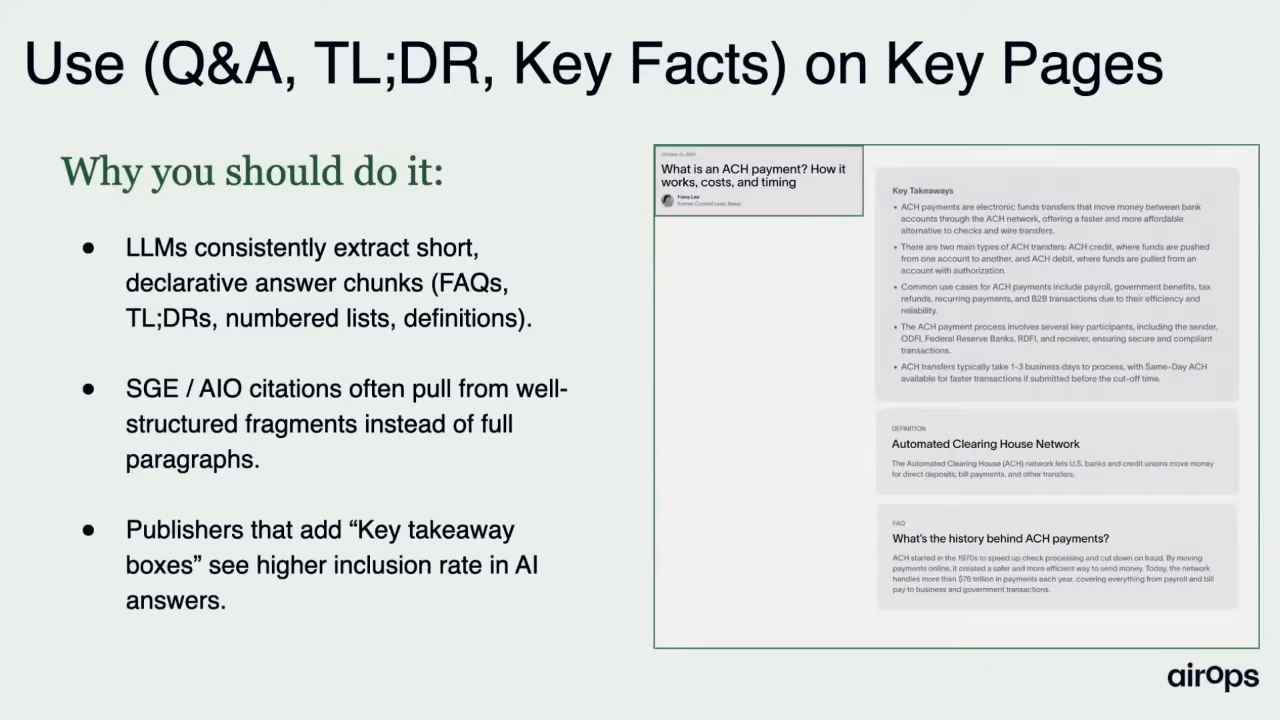
Alex Halliday, «Should We Do This Yet?»
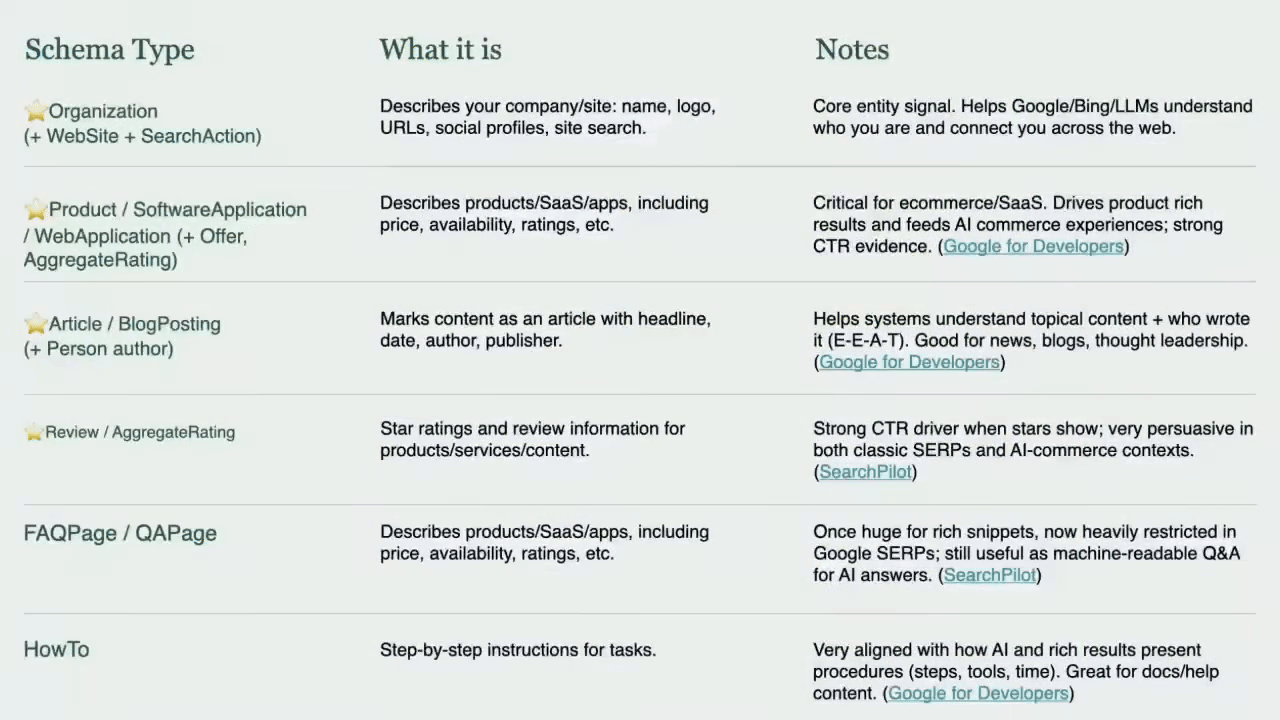
Холлидей в своём докладе говорит про это без сантиментов («сделайте уже эту разметку»), и показывает таблицу типов, которые реально работают. Вот она.
Alex Halliday, «Should We Do This Yet?»
Schema — машинный контракт, а не галочка для rich results
Тема, вокруг которой спорят меньше всего, но спор есть. Если вы отвечаете за шаблоны, вам придётся выбрать позицию в этом споре. Schema упоминают заметно чаще любого другого технического пункта — семнадцать докладов из пятидесяти пяти, если считать по полным расшифровкам. По извлечённым практикам выходит пять, потому что там учтены только прямые советы. Поэтому вывод строю не на частоте, а на содержании, и содержание здесь убедительное.
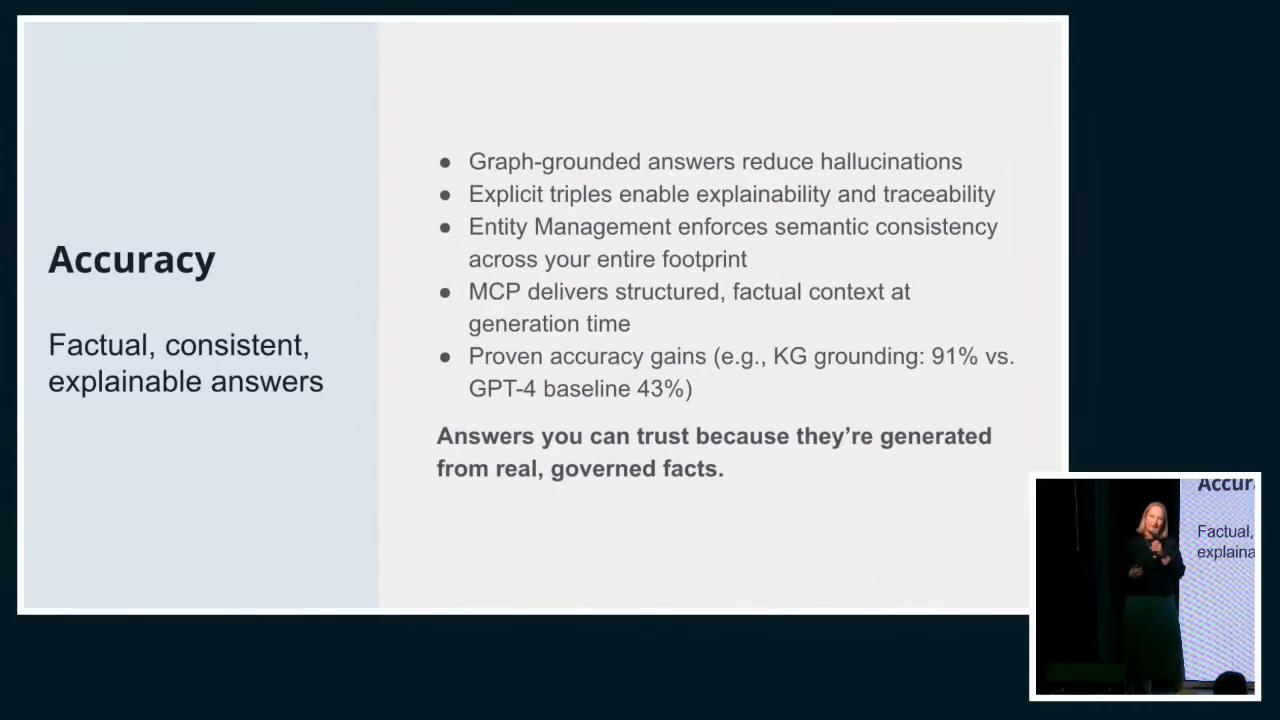
Martha van Berkel в докладе про граф знаний называет масштаб. В Schema.org больше 840 классов, и главная ошибка — называть всё веб-страницей. Разметка перестала быть галочкой для rich results и стала машинным контрактом — по ней модель понимает, что за сущность перед ней, и как связать её с другими.
Martha van Berkel, «From Schema Markup to Knowledge Graphs»
Данные доклада Martha van Berkel
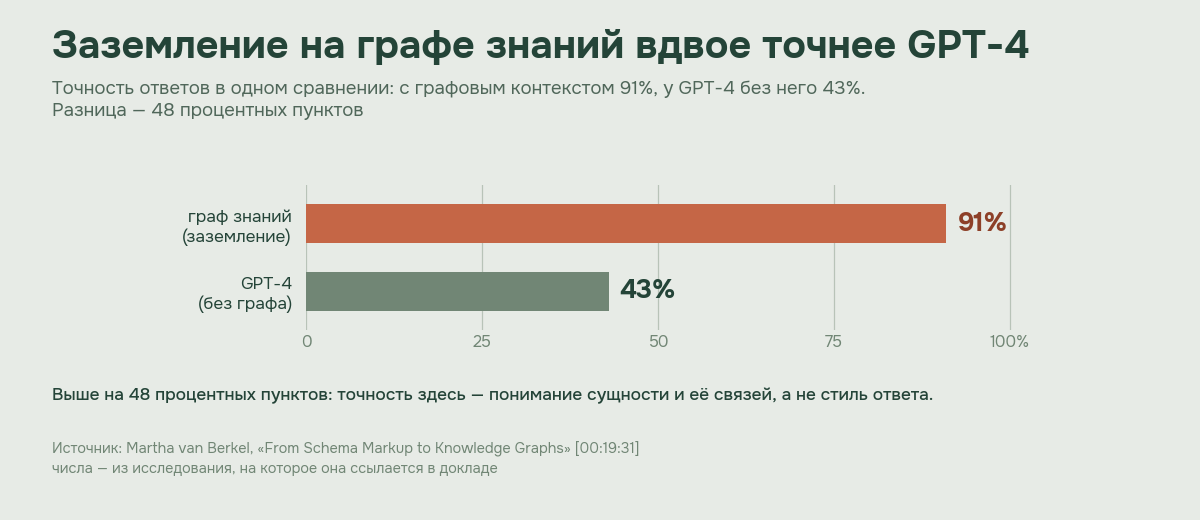
Дальше два числа, которые стоит запомнить. В исследовании, на которое она ссылается, заземление на графе знаний дало 91% точности против 43% у GPT-4 в том же сравнении, а отдельно она говорит, что графовые данные дали на 300% большую точность в корпоративных ответах, чем реляционные. Точность здесь означает, что модель правильно поняла сущность и её связи, а не «стала лучше писать».
Кейс, который она приводит, звучит почти анекдотично. В AI Overviews у Wells Fargo стояла локация «закрыто навсегда», и модель ссылалась на новость двадцатипятилетней давности. После нормальной разметки местоположений, за несколько дней, она начала цитировать страницу с локацией. Не дообучение, не новый контент. Разметка. И ещё один аргумент, который обычно выпадает из разговора: schema попадает в Web Data Commons и Common Crawl. То есть работает не только в момент ответа, но и в обучении. Модель может знать о вас до того, как её спросили. Если хотите, чтобы в ответе звучали ваши факты, а не чужие, начинайте с этой части.
Martha van Berkel, «From Schema Markup to Knowledge Graphs»Через несколько дней AI Overviews начала цитировать их страницу с локацией вместо той статьи двадцатипятилетней давности.
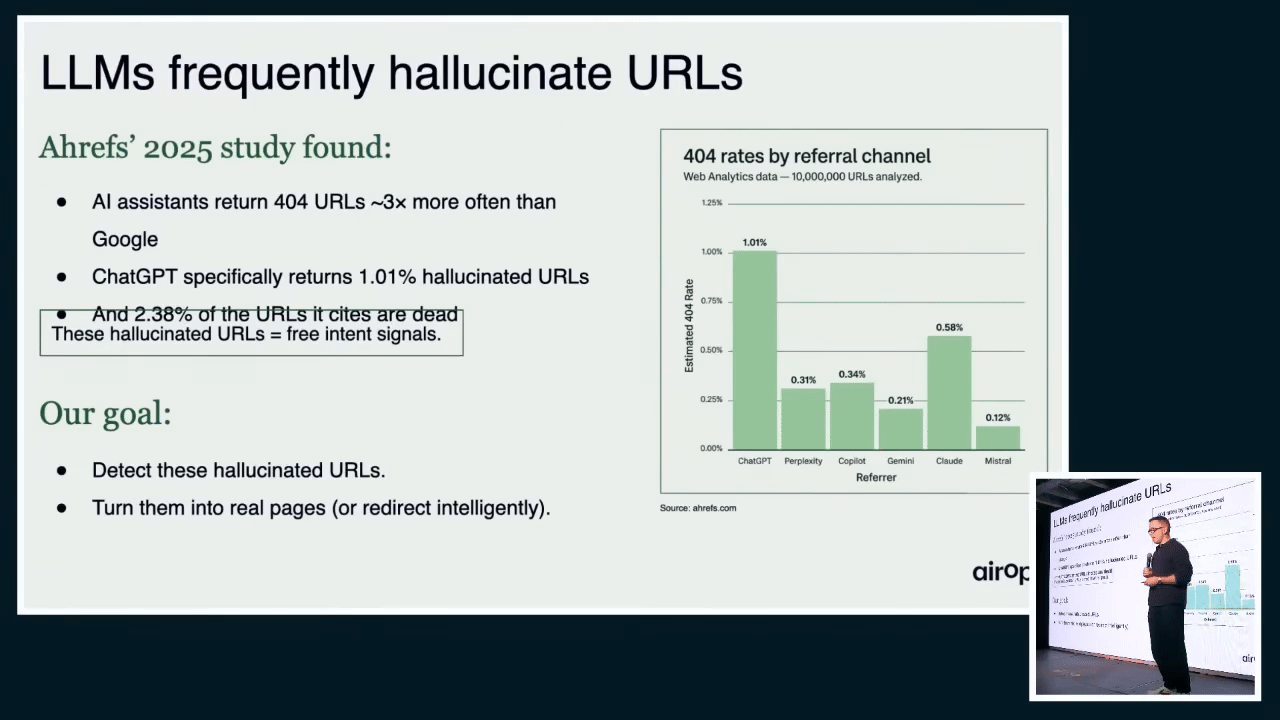
Ещё один довод из того же доклада, который обычно пропускают. AI-ассистенты выдумывают адреса страниц. По исследованию Ahrefs 2025 года, 404-е они отдают примерно втрое чаще, чем Google, у ChatGPT доля выдуманных URL — 1,01%, а 2,38% ссылок ведут на мёртвые страницы. Выглядит как проблема, а на практике это бесплатный сигнал спроса. Если модель придумала адрес, значит, у людей есть запрос на такую страницу. Холлидей предлагает их отлавливать и превращать в реальные страницы или аккуратно редиректить.
Alex Halliday, «Should We Do This Yet?»Модели часто выдумывают URL. И 2,38% ссылок, которые они цитируют, ведут на мёртвые страницы.
Alex Halliday, «Should We Do This Yet?»
Спор здесь не в том, делать ли разметку, а в том, ради чего. Вы можете решить, что разметка у вас уже есть и вопрос закрыт. Aleyda Solís в докладе 2026 года говорит прямо, что структурированные данные не стоит приоритизировать именно ради AI-видимости, у них есть другие пользы. Я с этим спорю (и в моей практике разметка меняла поведение модели быстрее, чем новый текст). Разметка нужна там, где модель должна понять сущность, и в этом смысле она часть машинного контракта, а не украшение. Если выбирать между разметкой и новым текстом, я начинаю с разметки.
Порядок простой — продукты, статьи, пары «вопрос-ответ», изображения — на уровне шаблона, а не на отдельных страницах. Валидатор, а не глаз. Связи между сущностями важнее количества типов — несколько связанных сущностей полезнее пятидесяти разрозненных. Если у вас в разметке весь сайт размечен как WebPage (я видел такое чаще, чем хотелось бы), начинать надо с типов.
AI-боты видны в логах, а не в аналитике
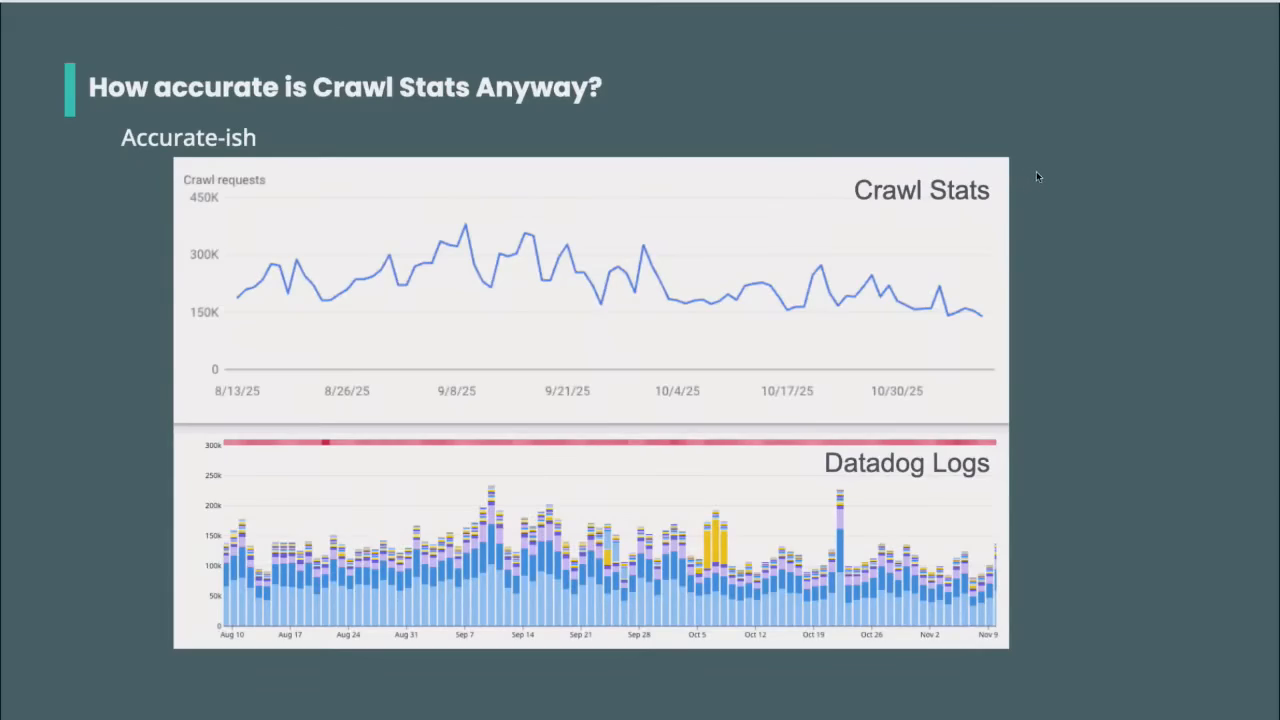
Самое полезное на конференции я услышал не в докладе про тренды, а в докладе про SRE. Rachel Anderson сравнила Crawl Stats в Search Console с логами первой стороны за один период. В кабинете оказалось примерно на 50 тысяч запросов больше, чем в логах. Я перечитал этот абзац дважды. Ожидаешь, что кабинет занижает, а он завышает. Вот так.
Rachel Anderson, «The Secret to Enterprise Crawl Optimization: SRE»
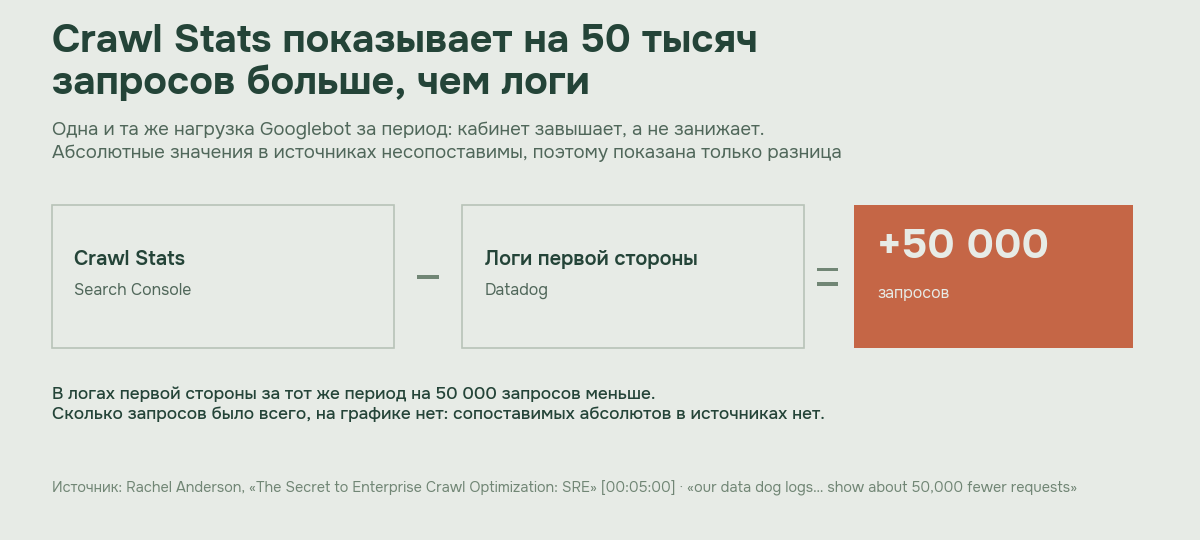
Данные доклада Rachel Anderson
Причина в ограничениях кабинета, и их стоит держать в голове, когда вы смотрите на его цифры — только доменные ресурсы, сегментация по поддоменам, примеры URL вместо полного списка, только Googlebot и хранение около 90 дней, то есть для крупного домена это индикатор тренда, а не источник точных чисел. И это отдельная история про то, что кабинет вообще не видит AI-ботов, кроме Googlebot.
Давайте посмотрим, что с этим делать. С логами есть и приятная часть. Их можно не только читать, но и группировать: Холлидей показывает, как кластеризовать запросы по страницам и увидеть, куда AI-боты ходят чаще всего. Дальше эти адреса становятся приоритетом на обновление, логика та же, что с обходом Googlebot. Мне этот приём нравится тем, что он превращает сырой лог в список задач. Если у вас логи за месяц уже есть, начните с этой кластеризации.
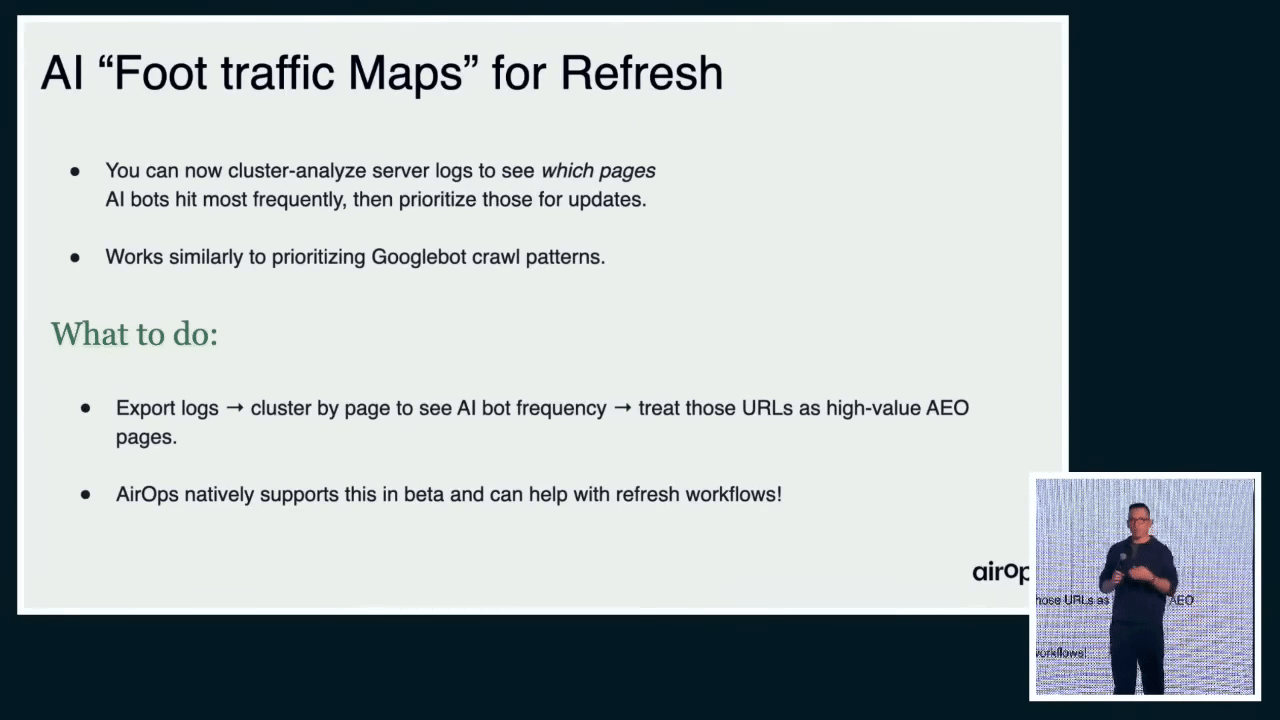
Alex Halliday, «Should We Do This Yet?»
Почему логи важнее. GA, Метрика и любая аналитика на JavaScript не видят AI-ботов, потому что те не выполняют скрипты, а логи сервера или CDN видят обход, но не видят, что из этого обхода попало в ответ, и это две разные картины, из которых одна без второй врёт. В отчётах их обычно смешивают, а потом удивляются, почему цифра не сходится с реальностью. Я такие смешанные отчёты видел у половины клиентов и каждый раз начинал разбор с одного вопроса — откуда взялось это число.
Есть и вторая проблема, о которой реже говорят. Единой цифры «AI-трафик» не существует, потому что в неё пытаются уложить три разных величины. Доля визитов из AI-интерфейсов — меньше 1%. Органика — около трети сессий, и на слайде Индиго это одна треть, а не 30–50 из перечисления в речи. А запросы ботов уже превысили человеческий трафик, и это не противоречие, это другая метрика. Michael King называет смешение этих величин категориальной ошибкой, и с ним трудно спорить.
Michael King, «SEOs Don't Actually Do Marketing and It Shows»Трафик AI-ботов уже превысил человеческий. Значит, боты — арбитры спроса.
На этой разнице и ломаются отчёты. Обход принимают за цитирование и делают вывод о канале.
Где практики расходятся и что с этим делать
Теперь честная часть. Четыре места, где спикеры говорят разное, и это не скандал. Это напоминание, что цифра без методики ничего не доказывает. Если вы видели в чужом отчёте любую из этих цифр, теперь вы знаете, от чего она зависит.
| Что расходится | Одна цифра | Другая цифра | От чего зависит |
|---|---|---|---|
| Свежесть | Половина страниц моложе 13 недель (Blyskal) | Средний возраст 2,5 года (Green) | Доля страниц или средний возраст, тип запроса |
| Объём AI-трафика | Меньше 1% визитов (Indigo) | Запросы ботов больше людей (King) | Визиты, клики или обход ботов |
| Размер куска | До 180 слов (Yesilyurt) | До 500 токенов (King) | Слова против токенов, платформа |
| Форматы для агентов | Не нужны сейчас (Halliday) | Готовиться к агентам (Santos, van Berkel) | Горизонт — квартал или год |
Свежесть. Обе цифры из таблицы могут быть верны. Первая про долю страниц в быстрых темах, вторая про средний возраст в справочных. Если у вас конкурентная коммерческая тема, ориентируйтесь на недели. Если справочник, на годы. Какой из двух случаев у вас, вы знаете лучше меня.
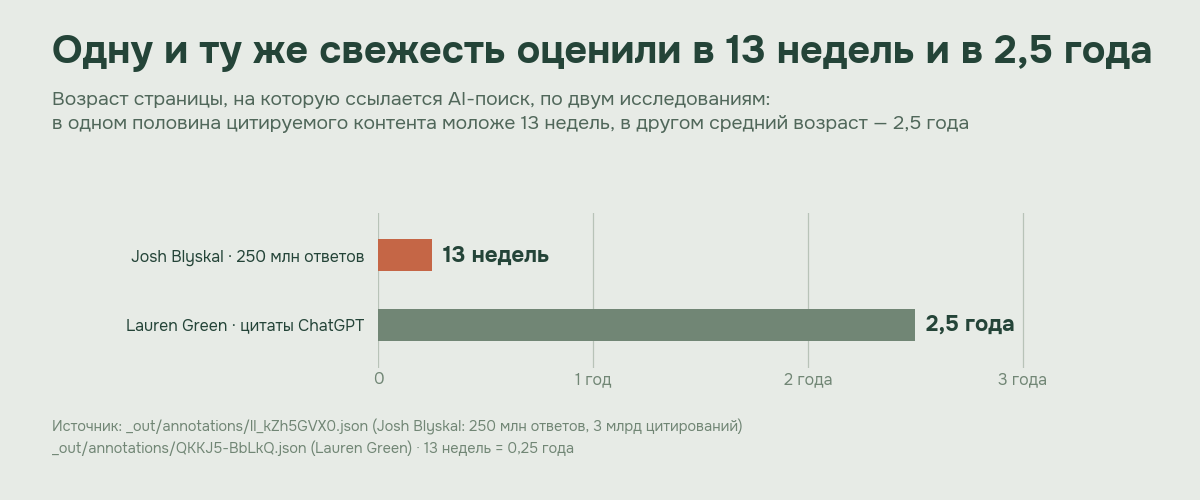
Данные докладов Josh Blyskal и Lauren Green
Объём AI-трафика. Это не противоречие. Это разные величины — визиты и обход. Пока в отчёте стоит одна цифра, она будет спорной.
Размер единицы извлечения. У одного спикера чанк до 180 слов, у другого до 500 токенов. Единицы разные, прямой пересчёт некорректен. Вывод один — короткий самодостаточный абзац.
Ставка на форматы для агентов. Разница не в правоте, а в горизонте. На квартал выигрывает Halliday, на год имеет смысл вкладываться в связанные данные: агентский веб уже идёт, и один визит агента может представлять 1,2 миллиарда пользователей.
Одна оговорка ко всей таблице расхождений. Примирение сторон — моя гипотеза, а не установленный факт. В корпусе мне не встретилось доклада, который сводил бы эти исследования между собой. Я смотрю на цифры и предполагаю, от какого условия они зависят. Проверять это нужно на своём кластере.
Что ещё было на конференции
Выше я разобрал механику AI-поиска и то, что с ней делать. Но 55 докладов — это не только ChatGPT: три больших блока конференции про технику, данные и людей. Там выводы не менее практичные, и без них картина неполная.
| Блок конференции | Главный вывод | Кто говорил |
|---|---|---|
| Техническое SEO и краулинг | Разовый аудит устаревает в день запуска. Логи и сетевой уровень показывают то, чего нет в кабинете. | Jori Ford, Serge Bezborodov, Rachel Anderson |
| Аналитика и данные | GSC и GA4 — один из источников. API отдаёт 26% показов, а история ограничена 16 месяцами. | Sam Torres, Serge Bezborodov, Ray Grieselhuber |
| Команда и внедрение | Внедряется 40–60% рекомендаций. Это узкое место, а не техника. | Aleyda Solís, Kevin Indig, Ross Hudgens, Rachel Anderson |
| Платформы и агенты | Bing просит IndexNow, а AI-краулеры не уходят глубже трёх ссылок. | Fabrice Canel, Krishna Madhavan, Jori Ford |
| Миграции, регионы, e-commerce | Шаблоны и перелинковка важнее объёма: решает качество повторяемых страниц. | Zach Chahalis, Max Prin, Serge Bezborodov |
Несколько цифр из этого блока, чтобы стало понятно, насколько там плотный материал. Patrick Stox разобрал больше миллиона сайтов и говорит, что около 60% веба — дубликаты. Fabrice Canel из Bing называет 3,5 миллиарда URL, которые пришли через IndexNow, и 18% кликов по новым адресам. Krishna Madhavan говорит, что половина новых проиндексированных URL с кликами в Bing приходит через тот же протокол. Sam Torres напоминает, что Search Console хранит данные 16 месяцев, а GA4 — 14, поэтому историю приходится собирать самому.
Это не мелочи для эрудиции. Если у вас техпроблемы или миграция, выводы из этих докладов дадут больше, чем ещё один разбор про ChatGPT. Поэтому в источниках ниже — не одиннадцать спикеров, а все, на кого я ссылаюсь.
Что сделать за месяц, если времени на всё нет
Внедрение — отдельная проблема, и доклады её не сглаживают. Я видел это на своих проектах чаще, чем хотел бы. Если у вас в бэклоге лежит аудит полугодовой давности, вы уже знаете, о чём я. В опросе Aleyda Solís на 280 ответов самый частый ответ, его выбрали 29% респондентов, и звучит он так — внедряется 40–60% рекомендаций, причём это оптимистичная цифра, потому что Kevin Indig говорит, что для половины компаний до продакшена доходит половина рекомендаций или меньше. Ross Hudgens цитирует чужой пост, где из тысячи тикетов внедрили пять, и сам оговаривается, что в цитате есть преувеличение. Пять из тысячи. Вот и весь разговор. Типичный срок выполнения рекомендации, по тому же опросу, четыре-шесть недель.
Kevin Indig, «Getting Technical SEO Work Done at Fortune 100 Companies»Если рекомендации не внедряются, работы нет.
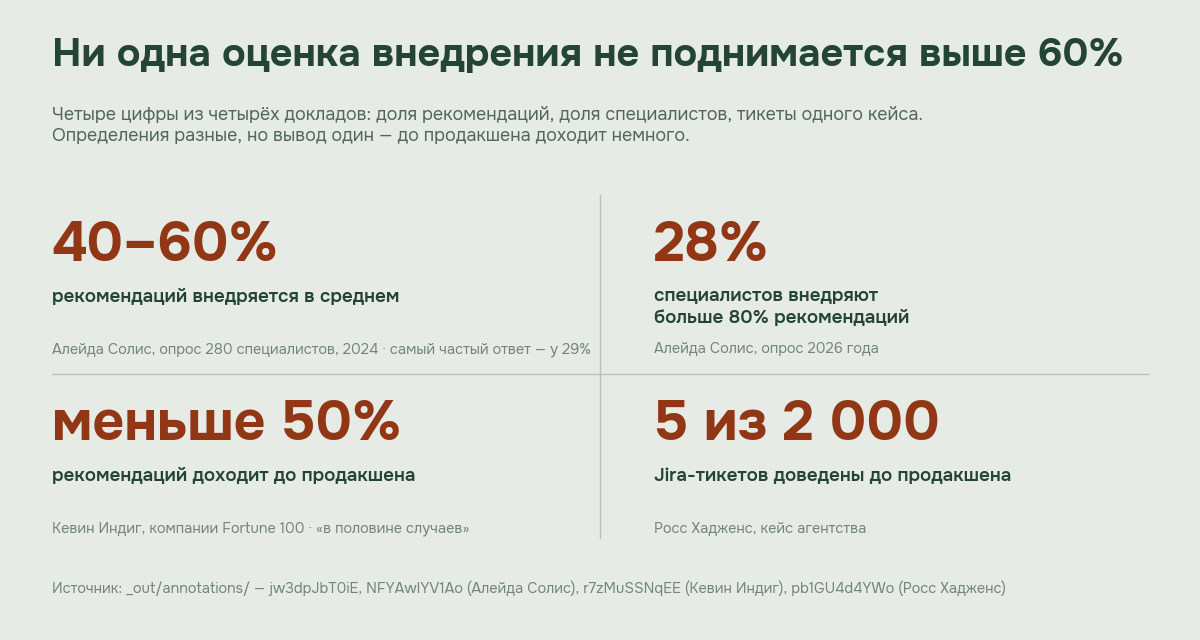
Данные докладов Aleyda Solís, Kevin Indig, Ross Hudgens
Отсюда вывод, который мне не нравится, но я в него верю — берите один шаблонный класс страниц, доводите его до конца, показывайте результат через месяц по одной метрике, выбранной до старта, и не начинайте второй шаблон, пока первый не прожил месяц, иначе получится ровно та картина, из-за которой 40–60% рекомендаций так и остаются в отчёте. Скорее всего, у вас в бэклоге висят десять (у меня тоже). Мы с клиентами всегда договариваемся о метрике до первой правки.
Вот что я бы сделал в таком порядке.
месяц логов, AI-боты, коды ответов
ответ в первом абзаце, FAQ, заголовки-вопросы
schema на шаблоне и проверка валидатором
три метрики до и после, через месяц
Критерии приёмки — нужные страницы отдают 200, на шаблоне есть ответ в первом абзаце и FAQ, разметка проходит валидатор.
llms.txt и отдельные markdown-версии на этом этапе не делать. Они не дают ничего, пока модели не начнут их читать, а время уходит. Если через год стандарт поддержат обе стороны, вернёмся к этому разговору. Я не против, я против делать это сейчас вместо разметки. Вам решать, но я бы потратил этот месяц иначе.
Проверьте себя за пять минут
Прежде чем идти в FAQ, ответьте себе на пять вопросов. Это не тест на знания, а быстрый срез — где у вас сейчас дырки. Отвечайте честно, вы это делаете для себя.
Знаете, какие AI-боты заходили на сайт за последний месяц? Если ответ «не знаю» или «кажется, GPTBot», у вас нет замера. Логи за месяц закроют этот вопрос.
Что у вас в первом абзаце главной страницы. Если после двух предложений вы не сказали, что делаете и для кого, в ответ модель возьмёт чужое объяснение.
Ваш шаблон статьи размечен как Article, а не как WebPage. Откройте валидатор и посмотрите. Если там WebPage, модель видит страницу без типа.
Вы проверяли, какие ваши страницы цитируются в ответах. Если нет, вы судите о видимости по позициям, а это разные вещи.
У вас есть llms.txt. Если да, оставьте его лежать, он не мешает. Если нет, не спешите делать.
Если на все пять ответ «да», вы уже впереди большинства — это не моя оценка, это следует из цифр в статье, потому что большинство сайтов не размечает шаблоны, не смотрит логи и не знает, какие их страницы цитируются. Если нет, порядок действий ниже.
Итог
Сайт больше не оптимизируют под страницу, его оптимизируют под абзац — тот, который можно вынуть из текста, вставить в ответ и процитировать. Всё остальное следствие — ответ в начале, короткие самодостаточные куски, разметка, чтобы модель поняла, о чём страница.
Мне эта перестройка не нравится, но она уже случилась. И в ней есть польза: писать понятнее и структурировать текст — это то, что помогает и людям. Ну-ну, скажете вы, опять благие пожелания. Тогда проверьте на одной странице. Возьмите свой топ-запрос, посмотрите, где стоит ответ, и переставьте его в первый абзац. Через месяц сравните.
А если у вас уже есть логи за месяц, скиньте в комментарии две цифры — сколько запросов в Crawl Stats и сколько в логах. Соберу сводку по проектам, интересно, у всех ли кабинет завышает. Разбирать это в одиночку долго.
Часто задаваемые вопросы
Меньше 1% визитов, а органика даёт около трети сессий. При этом запросы AI-ботов уже превышают человеческий трафик. Это две разные величины, и в отчёте их нужно разделять, иначе цифра «AI-трафик» будет спорить сама с собой. Я в своих отчётах показываю их двумя разными блоками.
По данным, которые цитирует Michael King, у страницы из топ-10 шанс попасть в AI-каналы один из четырёх. Ранжирование и извлечение работают по-разному — модель ищет фрагмент, а не документ. Позиция остаётся полезной, но перестаёт предсказывать цитируемость.
На этом этапе нет. Retrieval почти всегда идёт одним хопом, fan-out видит тот же SERP, что и человек, а стандарт пока не поддержан основными потребителями. Файл не вредит, но и не помогает. Если он у вас лежит без дела, вы ничего не потеряли, но не рассчитывайте на отдачу.
Собрать логи первого лица и понять, доходят ли AI-боты до страниц. Потом переписать один шаблон под фрагменты. Потом поставить schema и проверить валидатором. Всё остальное — после того, как появится замер.
Три метрики — доля страниц с ответом в первом абзаце, доля шаблонов с валидной schema, доля AI-ботов, получивших 200. Плюс прокси-показатели вроде брендовых запросов и прямого трафика. Одной цифры «AI-трафик» для решения мало.
Источники
Главные утверждения статьи и доклады, где их можно проверить.
- Josh Blyskal, «We Analyzed 250,000,000 AI Search Responses: Here's What We Found» — видео.
- Michael King, «Everything You MFs Should Know About Query Fan Out» — видео.
- Metehan Yesilyurt, «The Leaked ChatGPT Ranking Stack: How OpenAI Scores Every Webpage» — видео.
- Martha van Berkel, «From Schema Markup to Knowledge Graphs: Powering AI with Connected Data» — видео.
- Rachel Anderson, «The Secret to Enterprise Crawl Optimization: SRE» — видео.
- Alex Halliday, «Should We Do This Yet? Clear Advice On 5 High-Impact Technical SEO Decisions» — видео.
- Jamie Indigo, «Trashchat's Guide to Black Boxes: Technical SEO Tactics for LLMs» — видео.
- Lauren Green, «AI Bots on Your Site: What They See, Why It Matters, and Where to Draw the Line» — видео.
- Aleyda Solís, «The State of Technical SEO in 2024» — видео.
- Kevin Indig, «Getting Technical SEO Work Done at Fortune 100 Companies» — видео.
- Ross Hudgens, «From Deck to Dev: Getting SEO Recommendations Shipped at Enterprise Scale» — видео.
- Jori Ford, «When Server Logs Lie: The Wire-Level Truth Behind Googlebot's Ghost Errors» — видео.
- Serge Bezborodov, «Evergreen Crawl: See Your Site Exactly as Googlebot Saw It» — видео, «Can GSC Be the Source of SEO Decisions?» — видео.
- Patrick Stox, «What I learned from auditing over 1,000,000 websites» — видео.
- Sam Torres, «BigQuery for SEOs» — видео.
- Ray Grieselhuber, «Why Google Is Taking Action on SERP Data Collection and What to Do About It» — видео.
- Fabrice Canel, «Microsoft Bing — SEO for the AI era» — видео.
- Krishna Madhavan, «Beyond Blue Links: Freshness, Control, and Visibility» — видео.
- Zach Chahalis, «What I've Learned Doing Over 100 Website Replatformings and Migrations» — видео.
- Max Prin, «Stacking Signals: How International SEO Comes Together (And Falls Apart)» — видео.
- Dana DiTomaso, «Using GA4 to Surface Technical SEO Issues In Real-Time» — видео.
Что сделать дальше
Проверить ваш сайт
Покажу, где ваш сайт теряет видимость в AI-поиске. Доступ ботов, разметка, блоки ответов, и всё это на ваших данных.
Написать в Telegram