Содержание
GEO не отменяет SEO и не требует отдельного интернета. Я проверил 2 400 запросов Google, 800 запросов Яндекса, 38 факторов цитирования и собрал десять мифов, которые чаще всего продают как «GEO». Вот что связано с попаданием в ответ, а что остаётся обещанием.
- GEO работает там, где есть источники. Google AI и Алиса берут проиндексированные страницы. Без индекса и доступа цитировать нечего.
- Позиция в Google — сильнейший сигнал. По позиции я разделил процитированные и непроцитированные страницы в 89,3% пар. Но 40,5% ссылок в AI-блоке стоят вне топ-10.
- У Алисы другая механика. 65,6% её источников вне топ-30; в 67 из 104 ответов источников больше, чем видимых результатов.
- Структура и автор связаны с цитированием. Информационные страницы ×1,54, страницы с автором ×1,23. Schema.org и llms.txt не заменяют содержание.
- Отчёт Search Console показывает охват, а не качество. Нужен ручной замер промптов и повторный прогон.
Главное: GEO не отменяет SEO. Он добавляет замер ответов, извлекаемость и внешний след бренда.
GEO — не отдельный интернет
GEO расшифровывается как Generative Engine Optimization. Практический смысл: сделать так, чтобы генеративная система нашла страницу, поняла её и сослалась на неё в ответе. Пользователь при этом может вообще не перейти на сайт.
Важная развилка: ответ с источниками и ответ по памяти — разные вещи. ChatGPT без веб-доступа отвечает по параметрической памяти модели. Там нет поиска и цитирования. ChatGPT с поиском, Perplexity, Google AI Overviews и Алиса AI с источниками сначала ищут страницы, а потом собирают ответ. Именно к этому режиму относится GEO.
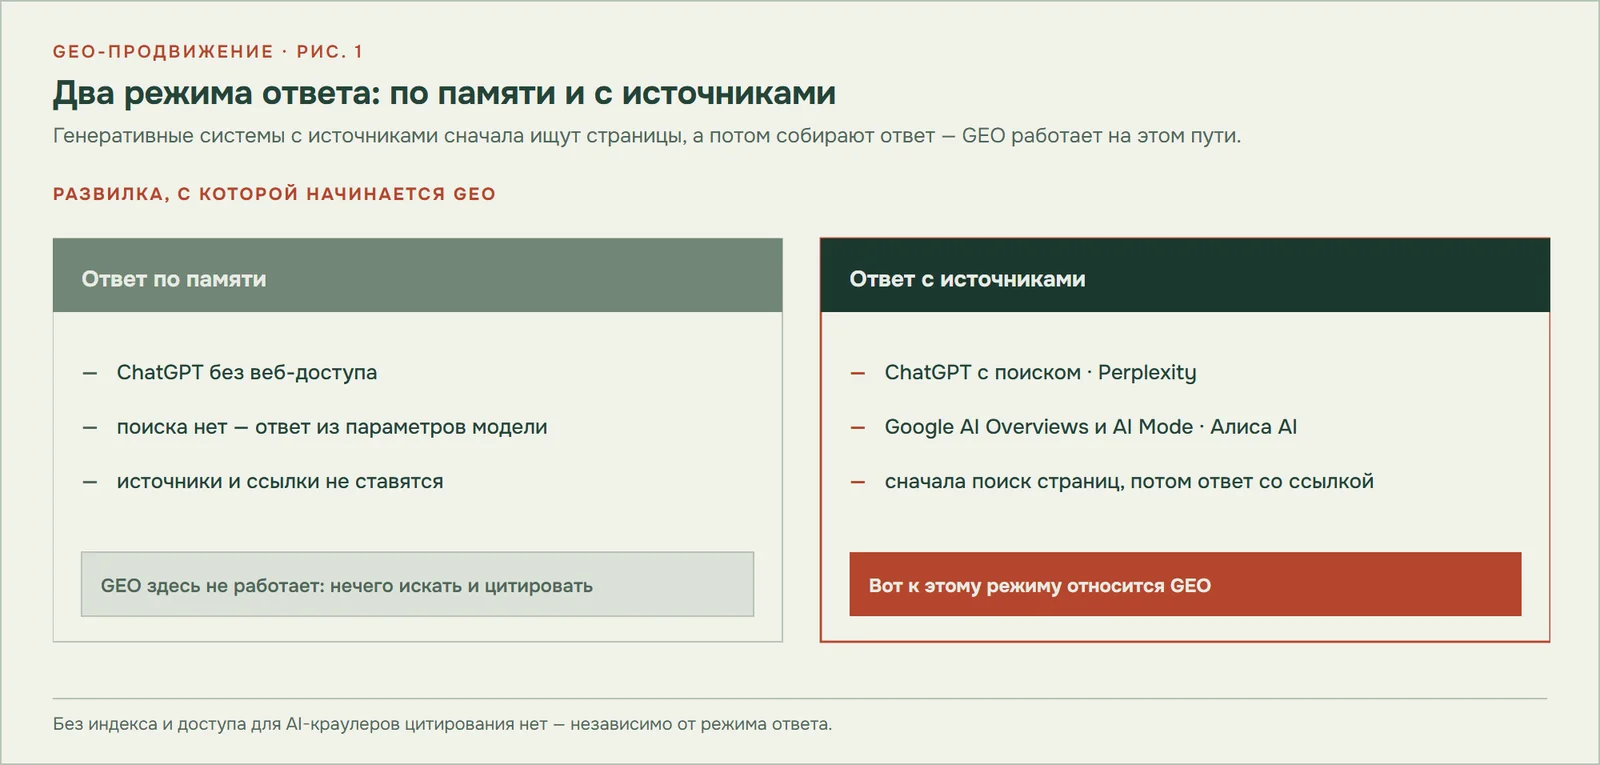
Google прямо говорит, что его AI-функции — часть Search, а не отдельная поисковая система. Новый гид Google по оптимизации для генеративных функций сводит работу к трём вещам: качественный контент, техническая доступность и обычные сигналы ранжирования. Отдельного «фактора GEO» в документации нет.
Яндекс описывает Алису AI похожим образом: в Поиске она берёт страницы, которые нашла по исходному и уточнённым запросам, и ставит ссылки на источники. Без источников Алиса тоже умеет отвечать, но это уже другой режим.
| Что сравниваем | GEO | SEO |
|---|---|---|
| Единица результата | Строка в ответе и ссылка-источник | Позиция в выдаче |
| Откуда берутся данные | Индекс и поисковая выдача | Индекс и поисковая выдача |
| Что оптимизируем | Фрагмент, который можно вынуть и процитировать | Страницу под запрос |
| Скорость изменений | Дни и недели, высокая волатильность | Месяцы, устойчивее |
| Что проверяем | Повторный замер в нескольких системах | Позиции, показы, клики |
| Гарантия места | Нет | Нет |
Вывод простой: GEO начинается там, где заканчивается базовая SEO-доступность. Но не заканчивается ею.
Что происходит между запросом и ответом
Путь до ответа можно разложить на четыре звена.
- Индекс. Google и Яндекс должны знать адрес страницы. Если страницы нет в индексе, генеративной системе нечего доставать.
- Краулер. AI-бот должен получить тот же HTML, что и браузер. Закрытый robots.txt, отказ сервера или рендеринг, который бот не выполняет, обрывают цепочку.
- Отбор. Модель или поисковый слой отбирает кандидатов по запросу. В Google это связано с обычным ранжированием; в Алисе с индексом Яндекса и уточняющими запросами.
- Извлечение и ответ. Из страницы вынимается фрагмент: определение, число, таблица, список. Модель собирает ответ и, если режим это поддерживает, ставит ссылку на источник.
Это и есть RAG, Retrieval-Augmented Generation, в практическом смысле. Но RAG не означает, что модель «угадывает бренд из головы». Она может найти страницу, а может не найти. Может взять один абзац, а может несколько. Может сослаться, а может пересказать без ссылки.
Есть ещё один слой, который часто пропускают: query fan-out. Сложный запрос разбивается на несколько подзапросов, и ответ собирается из разных наборов источников. Поэтому страница, которая не входит в топ-10 по основному запросу, иногда попадает в ответ по уточняющему. И наоборот: страница из топ-10 может не попасть, если её фрагмент неудобно извлекать.
Путь до AI-ответа
Пять систем, пять разных правил
GEO часто описывают так, будто это одна механика. На деле у систем разные входы и разные ограничения.
| Система | На что опирается | Что проверить | Где смотреть |
|---|---|---|---|
| Google AI Overviews | Индекс и ранжирование Google | Позиция, сниппет, доступ робота | Отчёт Generative AI в Search Console |
| Google AI Mode | Query fan-out, несколько источников на один запрос | Страницы, которые отвечают на подвопросы | Search Console, ручной замер |
| ChatGPT с поиском | Веб-поиск, если режим включён | OAI-SearchBot, HTML, факты на странице | Ручной замер по промптам |
| Perplexity | Поисковый слой и собственный разбор источников | PerplexityBot, FAQ, JSON-LD | Ручной замер по промптам |
| Алиса AI | Индекс Яндекса и уточняющие запросы | YandexAdditional, источники, видимость | Вебмастер, раздел про Алису |
Одна и та же страница может быть сильна в Google AI Overviews и невидима в Алисе. Поэтому «мы сделали GEO» без указания системы — это не результат, а название услуги.
Что подтверждают данные: позиция в органике
В октябре 2026 я снял 2 400 запросов Google и 800 запросов Яндекса и проверил 38 признаков страницы. Это не лабораторный эксперимент с одной переменной, а срез выдачи: я смотрел, какие страницы попали в источники AI-ответа, и сравнивал их с теми, которые не попали.
Главный результат: в Google позиция в органике — самый сильный признак. По одной позиции я правильно отличал процитированную страницу от непроцитированной в 89,3% пар. Признаки самой страницы добавляли к этому меньше процентного пункта.
Что видно в цифрах:
- в AI-блок попадает 38,2% страниц из топ-10;
- 5,4% с позиций 11–20;
- 1,3% с позиций 21–50;
- но 40,5% ссылок блока лежат за пределами топ-10;
- страница на первой позиции попадала в блок в 65,1% случаев, на десятой — в 16,1%.
Последние два пункта не противоречат друг другу. Большая часть цитат приходит из верхних позиций, но заметная часть — из глубины. Поэтому «только топ-3» и «топ не важен» одинаково неверны.
Шанс попасть в AI-блок Google
С Алисой картина другая. 65,6% ссылок её ответов не входят в топ-30 Яндекса, а 63,9% не нашлись и в топ-50. В 104 ответах было от 5 до 26 источников, в среднем 14. В 67 ответах источников оказалось больше, чем результатов в видимой органике той же страницы. Яндекс это допускает: Алиса может собирать ответ из большего числа страниц, чем показывает обычная выдача.
Мой вывод: для Google SEO-позиция — база, для Алисы — не единственный вход. Но и там страницы должны быть в индексе и доступны роботу.
Где Алиса берёт источники
Что подтверждают данные: структура, фактура и автор
Структура влияет не потому, что «нейросеть любит списки», а потому что из списка проще вынуть готовый ответ. В моём замере это видно на типах страниц.
- Информационные страницы (инструкции, определения, сравнения, подборки) цитировались чаще коммерческих: ×1,54 в Google.
- Коммерческие страницы цитировались реже: ×0,61.
- Вопросы в подзаголовках давали ×1,37.
- Указанный автор: ×1,23.
- Возраст страницы 3–12 месяцев был связан с более частым цитированием.
Это связи в данных, а не гарантия. Но они объясняют, почему «просто текст с ключами» проигрывает странице, где есть прямой ответ, единица измерения, источник и границы применимости.
С разметкой сложнее. JSON-LD в Google чаще встречался у цитируемых страниц: 55,3% против 51,3%, но после поправки на позицию и длину эффект исчезал: ×1,12, то есть «разницы нет» отличить нельзя. В Perplexity JSON-LD и FAQPage были связаны с цитированием: ×1,49 и ×1,62 на 291 запросе. Это не «разметка поднимает в AI», а «разметка помогает разобрать страницу там, где парсер её читает».
С llms.txt похожая история. Страницы сайтов с файлом цитировались чаще: 19,0% против 13,9%, ×1,35. Но файл чаще лежит на «прочих» сайтах, а не у СМИ и форумов. С поправкой на тип сайта и авторитет домена остаётся ×1,13. Эффект, который нельзя уверенно отличить от нуля. По данным Ahrefs, 97% файлов не получили ни одного запроса за май 2026 года.
Практический вывод: сначала ответ, потом разметка. Если на странице нет определения, числа и проверяемого факта, Schema.org не добавит их из воздуха.
Что связано с цитированием
Что подтверждают данные: внешний след бренда
E-E-A-T (Expertise, Experience, Authoritativeness, Trustworthiness) не является отдельным «фактором GEO». Но внешние упоминания влияют на то, какие источники модель находит и насколько уверенно называет бренд.
Логика простая. Если бренд упоминается только на своём сайте, у модели меньше подтверждений. Если те же факты повторяются в отраслевом медиа, каталоге, исследовании или независимом обзоре, появляется второй и третий источник. Модель может собрать ответ из них, а может процитировать вас — но вероятность, что она вообще увидит бренд, растёт.
При этом нет единого «рейтинга доверия», который можно купить или поднять одной публикацией. У разных систем разные индексы, разные запросы и разные правила отбора. «Цитируемость» — не свойство сайта, а результат конкретного запроса в конкретной системе в конкретный день. Брендовый шум — отдельная проблема: в разборе на sk-seo.ru пять его видов, от семантического до репутационного, и каждый ломает образ по-своему.
Отдельно про доступ. В сентябре 2026 я проверил 149 крупных сайтов: у 23 сервер отказывал хотя бы одному AI-боту, которого robots.txt пускал. Это не теория про «нейросеть не увидела»: это буквальный отказ на уровне ответа сервера. Если AI-краулер получает 403, никакой контент и никакая разметка не помогут.
Сколько сайтов реально пускают AI-ботов
Что показывает Search Console с июня 2026
В русских пересказах часто пишут «Search Console показывает AI Overviews с мая 2026». На самом деле отчёт вышел 3 июня 2026. Google объявил отдельные отчёты Search Generative AI performance reports. Они покрывают генеративные функции в Search, включая AI Overviews и AI Mode, и генеративные функции в Discover.
Что в отчёте есть:
- показы страниц внутри AI-функций;
- разрез по страницам;
- страны и устройства;
- даты с часовой, дневной, недельной и месячной гранулярностью.
Чего в нём нет на старте:
- кликов по AI-функциям;
- разреза по запросам;
- объяснения, почему модель выбрала именно эту страницу;
- полноценного аудита цитирований.
Google также говорит, что показы AI-функций входят в общий отчёт Performance и отображаются там. Новый отчёт — отдельный вид тех же данных, а не второй независимый счётчик. С 31 августа 2026 он доступен всем сайтам, но по-прежнему без кликов, CTR и разреза по запросам.
Поэтому отчёт полезен как индикатор объёма, но не отвечает на вопрос «за что меня процитировали». Для этого нужен ручной замер по списку промптов и повторные прогоны.
У Яндекса свой инструмент: в Вебмастере есть раздел «Видимость сайта в Алисе AI». Он показывает Share of Voice, динамику, примеры запросов и сайты, которые часто упоминаются в ответах по тем же запросам. Данные охватывают последние три месяца и обновляются еженедельно. Это ближе к измерению цитирования, чем отчёт Google, но всё равно не объясняет причину выбора.
Что показывает отчёт Generative AI
- показы
- страницы
- страны
- устройства
- даты
- клики
- запросы
- причина выбора
Почему GEO-счёт похож на SEO-счёт
Я разобрал 18 российских прайсов, 4 зарубежных предложения и 64 опубликованных GEO-кейса. В кейсах агентства чаще всего описывали контент 58 раз, внешнее продвижение 50, техническое SEO 26. Новый объект работы встречался реже: замер генеративных ответов, разбор формулировок, citation rate, Share of Voice.
Это не значит, что GEO — фикция. Новое в нём есть: измерение ответов, работа с извлекаемостью, внешний цифровой след и повторный замер. Но если в смете только «контент + ссылки + техничка» и нет ни одного замера, вы платите за SEO под новым названием.
Практический тест для сметы: попросите показать baseline, список промптов, сырые ответы и повторный замер. Если этого нет, «GEO» сводится к переименованию старой работы.
Что описано в 64 GEO-кейсах
Десять мифов о GEO
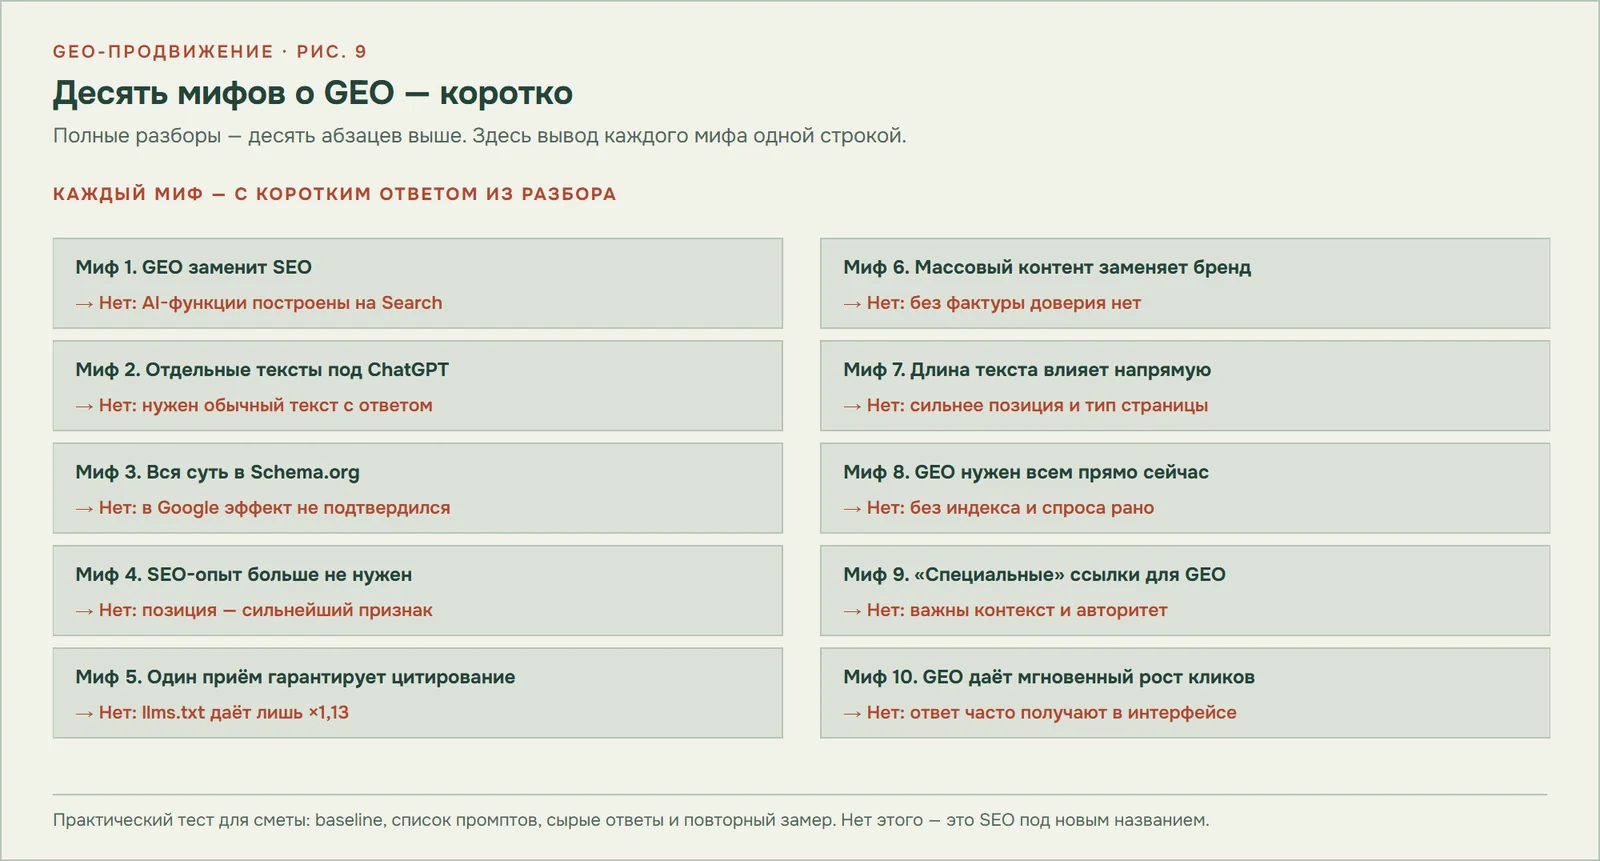
Миф 1. GEO заменит SEO. Нет. Google AI-функции построены на Search, а Алиса берёт проиндексированные страницы Яндекса. 40,5% цитат в Google приходят не из топ-10, но это не отменяет индекс, доступ и ранжирование. Без SEO-базы генеративной системе нечего доставать.
Миф 2. Нужно писать отдельные тексты под ChatGPT. Нет. Модель читает обычный веб, а не «специальный ChatGPT-формат». Один и тот же текст должен быть понятен человеку, поисковому роботу и парсеру. Разница только в том, есть ли на странице извлекаемый ответ.
Миф 3. Вся суть GEO в разметке Schema.org. Нет. В Google после поправки на позицию и длину эффект JSON-LD не подтвердился. В Perplexity разметка связана с цитированием сильнее, но и там это не гарантия. Разметка помогает разобрать страницу, а не заменяет содержание.
Миф 4. SEO-опыт больше не нужен. Нет. Позиция в органике — самый сильный признак в Google. Техническая доступность, индексация, ссылки и качество контента остаются базой. «GEO-магия» без этого не работает.
Миф 5. Есть один файл или приём, который гарантирует цитирование. Нет. llms.txt после поправки на тип сайта даёт ×1,13, и 97% файлов не получили запросов за май 2026. Одна Schema.org, один текст, одна ссылка — не гарантия. Гарантии в этой теме вообще нет. 15 мая 2026 Google прямо назвал манипуляцию генеративными ответами спамом, хотя новой категории нарушений не появилось.
Миф 6. Массовый контент заменяет развитие бренда. Нет. Массовое размещение без фактуры и подтверждений не создаёт доверия. В моём замере информационные страницы цитировались чаще, но это тип страницы, а не разрешение производить больше текста.
Миф 7. Длина текста напрямую влияет на попадание. Нет. В замере сильнее связаны позиция, тип страницы, близость заголовка к запросу и вопросы в подзаголовках. Длинный текст без ответа проигрывает короткому с фактом и единицей измерения.
Миф 8. GEO нужен всем и прямо сейчас. Нет. Если сайт не индексируется, нет спроса на бренд и закрыт доступ AI-краулеров, начинать с GEO рано. Для срочных локальных услуг классический поиск часто остаётся основным каналом.
Миф 9. Можно купить «специальные» ссылки для GEO. Нет. Ссылки важны, но для цитирования критичны контекст упоминания и авторитет площадки. Спамные ссылки не делают бренд экспертом. Прямого «ссылочного фактора GEO» в документации нет.
Миф 10. GEO даёт мгновенный рост кликов. Нет. Часть пользователей получает ответ в интерфейсе и не переходит на сайт. Показы в AI-функциях могут расти, а клики падать. Успех здесь измеряется охватом, упоминаниями и качеством лидов, а не только трафиком.
Что считать цитированием
В отчётах и презентациях смешивают три разных события:
- упоминание: модель назвала бренд без ссылки;
- ссылка: в ответе есть URL страницы;
- переход: пользователь нажал и пришёл на сайт.
Для бизнеса это разные вещи. Упоминание без ссылки может работать на узнаваемость, но не даёт трафика. Ссылка без перехода даёт показ, но не визит. Переход без упоминания может быть брендовым запросом, который к GEO отношения не имеет.
Поэтому в замере я считаю три доли отдельно: ответы с упоминанием, ответы со ссылкой и визиты с AI-реферером. Если считать только переходы, GEO почти всегда будет выглядеть нулевым. Если считать только упоминания, можно получить красивый отчёт без заявок.
Три разных события
Какие метрики считать
| Метрика | Что показывает | Где брать | Ограничение |
|---|---|---|---|
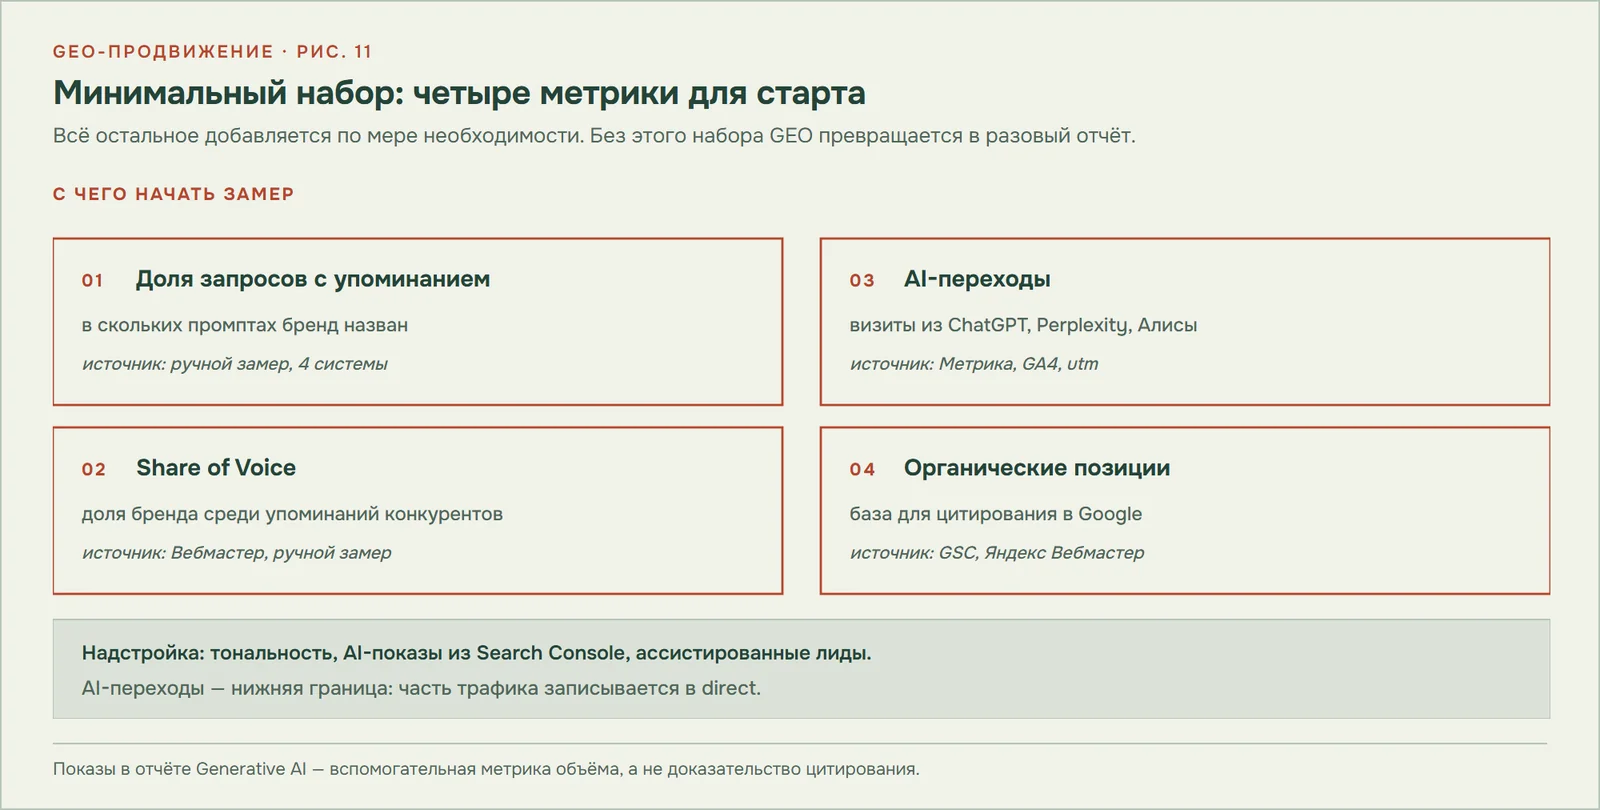
| Доля запросов с упоминанием | В скольких промптах бренд назван | Ручной замер по списку, 4 системы | Зависит от списка и дня |
| Share of Voice | Доля бренда среди упоминаний конкурентов | Яндекс Вебмастер, ручной замер | Разные системы считают по-разному |
| Тональность | Как бренд описан в ответе | Ручная разметка, LLM-помощник | Оценка субъективна |
| AI-показы и страницы | Сколько раз URL появился в AI-функции | Search Console, отчёт Generative AI | Нет кликов и причин, выкатка частичная |
| AI-переходы | Визиты из ChatGPT, Perplexity, Алисы | Метрика, GA4, utm | Часть трафика записывается в direct |
| Ассистированные лиды | Сколько заявок видели AI-ответ | CRM, опрос, сквозная аналитика | Атрибуция неполная |
| Органические позиции | База для Google AI | GSC, Яндекс Вебмастер | Не объясняет цитирование само по себе |
Минимальный набор для старта: доля запросов с упоминанием, Share of Voice, AI-переходы и органика. Всё остальное — надстройка. В эксперименте на 200 ответах часть AI-трафика записалась в direct, поэтому AI-переходы считайте нижней границей, а не полным объёмом.
Как выглядит работа за 90 дней
Неделя 1. Доступ. Проверить индекс, robots.txt, ответы сервера для AI-ботов, sitemap, canonical. Отдельно YandexAdditional для Алисы. Если доступа нет, остальное не имеет смысла.
Недели 1–2. Базовая линия. Собрать 50–70 промптов по кластерам, снять ответы в ChatGPT, Perplexity, AI Overviews и Алисе. Зафиксировать дату, регион, версию списка и повторный прогон. Один прогон ничего не доказывает.
Недели 2–4. Сущность. Свести название, автора, услуги и профили в один узел: Schema.org, sameAs, страница «Обо мне», согласованные данные на внешних площадках. Разные написания и старые профили размывают бренд.
Недели 4–8. Извлекаемость. На ключевых страницах добавить прямой ответ, определение, числа с источником, таблицу, автора и дату. Не переписывать всё: сначала страницы, которые уже близко к запросу.
Недели 6–12. Внешний след. Отраслевые обзоры, каталоги, экспертные комментарии, кейсы. Не «ссылки для GEO», а подтверждения фактов на площадках, которым доверяет аудитория.
Неделя 12. Повторный замер. Та же выборка, та же методика, та же дата в календаре. Сравнивать с базовой линией, а не с ощущением «стало лучше».
Срок 2–4 месяца из обзоров — не закон, а горизонт планирования. Он зависит от отрасли, конкуренции, доступа и того, сколько страниц реально нужно править.
Что править в первую очередь:
- Доступ: robots.txt, ответ сервера, YandexAdditional, sitemap, canonical.
- Первый абзац: прямой ответ на вопрос без разогрева.
- H2 в форме вопросов, которые реально задают в модели.
- Таблица или список с единицами измерения и датой.
- Автор, дата публикации и ссылки на первоисточники.
- Внешние подтверждения: отраслевой обзор, каталог, экспертный комментарий.
Кому GEO нужен, а кому рано
Нужен:
- B2B и сложные услуги, где клиент собирает короткий список до звонка; в разборе LLM SEO для B2B — 10 публичных кейсов и 7 механик роста;
- e-commerce и локальный бизнес, где модель сравнивает клиники, отели, подрядчиков и товары;
- эксперты и личные бренды, у которых есть однофамильцы и старые профили;
- агентства и in-house-команды, которым нужен внешний замер и повторяемая методика.
Рано:
- сайт не индексируется или закрыт от AI-ботов;
- нет спроса на бренд и нет контента, который отвечает на вопросы;
- бизнес живёт на срочных локальных услугах, где классический поиск пока основной;
- нет ресурса на повторный замер: без него GEO превращается в разовый отчёт.
Кейс: клиника в Дубае
В кейсе клиники в Дубае SEO и GEO шли вместе. За март–октябрь 2026 показы в Google выросли с 8 140 до 53 752 в месяц, небрендовые клики — с 47 до 133. В сентябре 36 из 144 обращений пришли из ChatGPT.
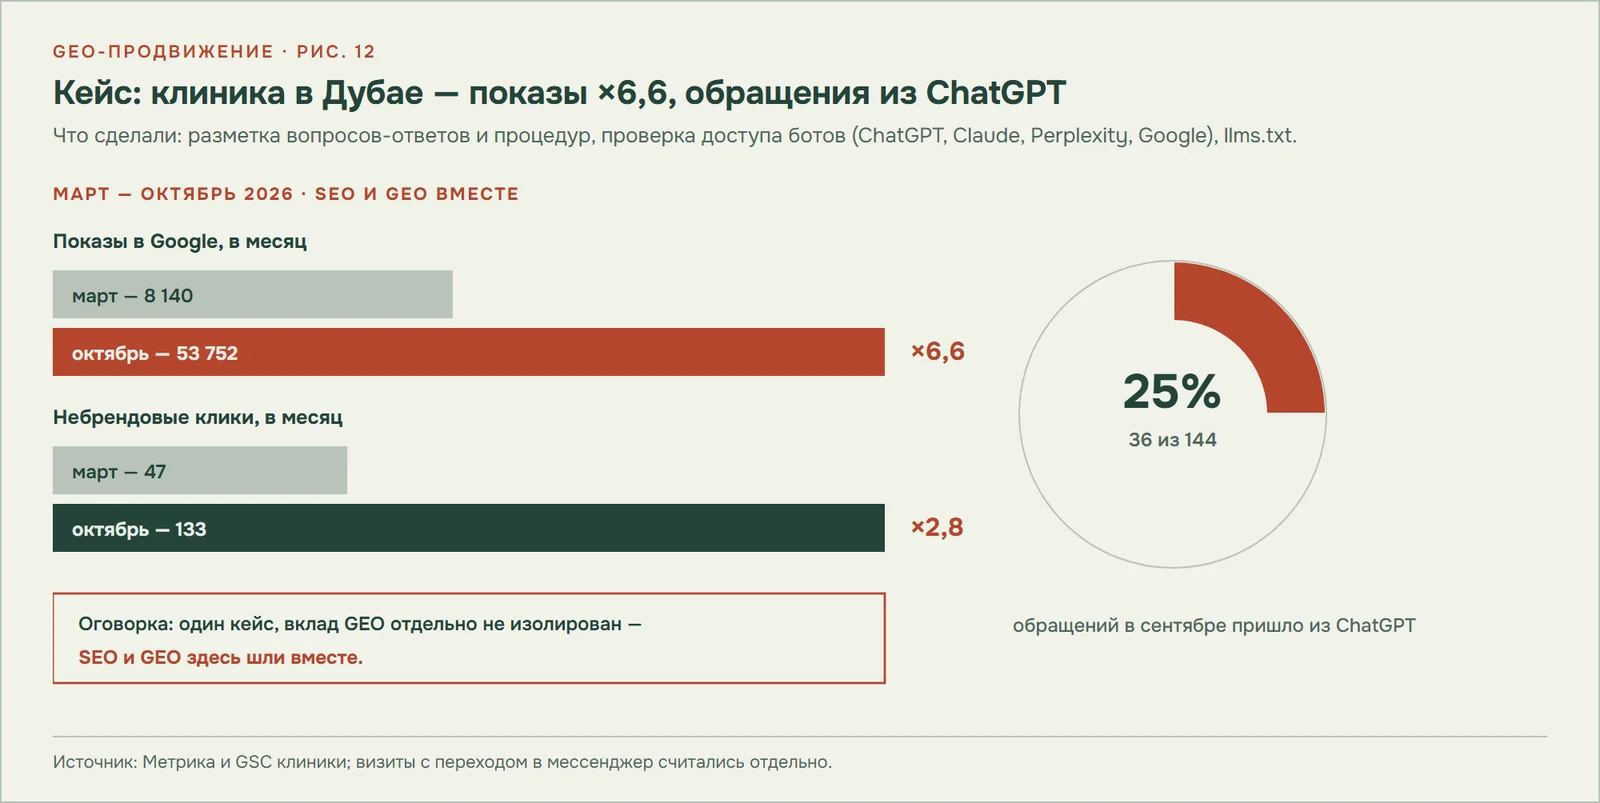
Что делали: разметили вопросы-ответы и медицинские процедуры, проверили, что ChatGPT, Claude, Perplexity и Google получают тот же HTML, что браузер, выложили llms.txt. Отдельно считали визиты с переходом в мессенджер.
Оговорка: это один кейс, SEO и GEO в нём не разделены. Нельзя сказать, что рост показов дал именно GEO. Но кейс показывает, что AI-канал можно увидеть в Метрике и связать с обращениями, а не только с «упоминаниями».
Ограничения этого разбора
- Это срез, а не эксперимент с контрольной группой. 2 400 запросов Google и 800 Яндекса сняты в Москве в октябре 2026. Другая география, другая дата и другой набор запросов могут дать другие числа.
- Я показываю связи, а не причинность. Если страница с автором цитируется чаще, это не значит, что автор стал причиной цитирования.
- Ответы моделей нестабильны. Повторный замер через 10–12 дней дал в среднем 37,5% общих ссылок у Google и 65,1% у Алисы. Один прогон здесь ничего не доказывает.
- Отчёт Search Console по AI-функциям доступен всем сайтам с 31 августа 2026, но не показывает клики и причины выбора страницы. Это индикатор объёма, а не аудит цитирования.
- Кейс клиники в Дубае — один проект, в котором SEO и GEO шли вместе. Он не доказывает, что рост дал именно GEO.
Что уже проверено на этом сайте
Статья опирается на восемь разборов, которые я делал по этой теме:
- GEO-пакет: новая работа или дубль SEO — 18 российских и 4 зарубежных прайса, 64 кейса. Большая часть «GEO» в сметах — SEO плюс замер.
- Как ChatGPT, AI Overviews и Алиса видят ваш бренд — путь от доступа ботов до образа, цитат и заявок.
- Когда оптимизация под AI превращается в спам — граница Google после 15 мая 2026.
- Сколько трафика приносят нейросети — четыре разных объекта под одним словом и эксперимент на 200 ответах.
- Файл llms.txt: кто его читает — тест 8 AI-систем и граница эффекта.
- Брендовый шум в глазах ИИ — пять видов шума и Brand Signal Clarity Score.
- Как стать видимым в ChatGPT и Perplexity — семь действий и проверка за 10 минут.
- LLM SEO для B2B — 10 публичных кейсов, 7 механик и 15 опорных действий.
Частые вопросы
Нет. Google AI-функции работают на Search, Алиса на индексе Яндекса. Без технической базы и релевантности генеративной системе нечего цитировать.
Нет. Нужен обычный текст с прямым ответом, фактами, источником и понятной структурой. «Специальный формат для ChatGPT» не является фактором отбора.
Нет. Разметка помогает разобрать страницу, но не заменяет содержание. В Google эффект JSON-LD после поправки на позицию и длину не подтвердился.
Как навигационный слой: да, как «фактор ранжирования» — нет. После поправки на тип сайта эффект небольшой, а большинство файлов не запрашиваются.
В обзорах называют 2–4 месяца, но это ориентир, а не гарантия. Всё зависит от доступа, конкуренции и объёма правок. Повторный замер нужен в любом случае.
Нет. Правила отбора у моделей закрыты и меняются, набор источников нестабилен. Можно гарантировать доступ, методику, замер и разбор причин.
Доля запросов с упоминанием, Share of Voice, тональность, AI-переходы и ассистированные лиды. Показы в Search Console — вспомогательная метрика, а не доказательство цитирования.
Источники
- Google Search Central. Optimizing for generative AI features — официальный гид, обновлён в 2026.
- Google Search Central. AI features and your website — как AI-функции связаны с Search.
- Google Search Central Blog. Introducing Search Generative AI performance reports in Search Console — 3 июня 2026.
- Яндекс Вебмастер. Ответы Алисы AI и источники.
- Яндекс Вебмастер. Видимость сайта в Алисе AI.
- Яндекс Вебмастер. Роботы Яндекса.
- OpenAI. Overview of OpenAI crawlers.
- Собственный замер: 38 факторов цитирования на 2 400 запросах Google и 800 Яндекса.
- Собственный замер: 120 проверок источников Алисы AI.
- Собственный тест: llms.txt на 8 AI-системах.
- Собственный замер: 149 сайтов и доступ AI-ботов.
- Кейс: клиника в Дубае, SEO и GEO.