Содержание
- В графе 46 статей, 261 ссылка, 206 уникальных пар. 55 ссылок повторные: вес они не удваивают.
- PageRank зависит не от числа входящих, а от того, кто ссылается и на сколько целей делится вес.
- Две сироты и семь тупиков. Сквозной блок «почитать дальше» не заменяет контекстную ссылку.
- 64 анкора не называют тему цели. Восемь средних пар каннибализации уже связаны взаимно — и всё равно близки.
- Кейс GSC: услуга и хаб делят «seo консультация». 301 не лечит разные интенты.
Главное: считать надо не ссылки, а вес на цель и интент страницы.
Ссылочный вес любят описывать как «энергию», которая перетекает по ссылкам. На практике это арифметика: страница делит свой вес между теми, на кого ссылается. Я посчитал граф из 46 статей своего блога: 261 ссылка, 2 страницы-сироты, 7 тупиков и 55 повторных ссылок.
Дальше — формула без магии, четыре таблицы с расчётами и кейс из Search Console: как услуга и хаб делят один запрос. В конце — чек-лист, который можно пройти за вечер.
Что такое ссылочный вес — простыми словами
Ссылочный вес — условная доля авторитета страницы, которая передаётся по ссылкам. Не «рейтинг», не «баллы от Google» и не то, что можно увидеть в отчёте. Это модель: мы предполагаем, что страница с большим числом качественных входящих ссылок важнее, и она передаёт часть этой важности дальше.
Проще всего так. Страница A имеет вес 1,0 и ссылается на пять других страниц. Каждая получит по 0,2 при условии, что ссылки ведут на разные адреса и мы пока не учитываем затухание.
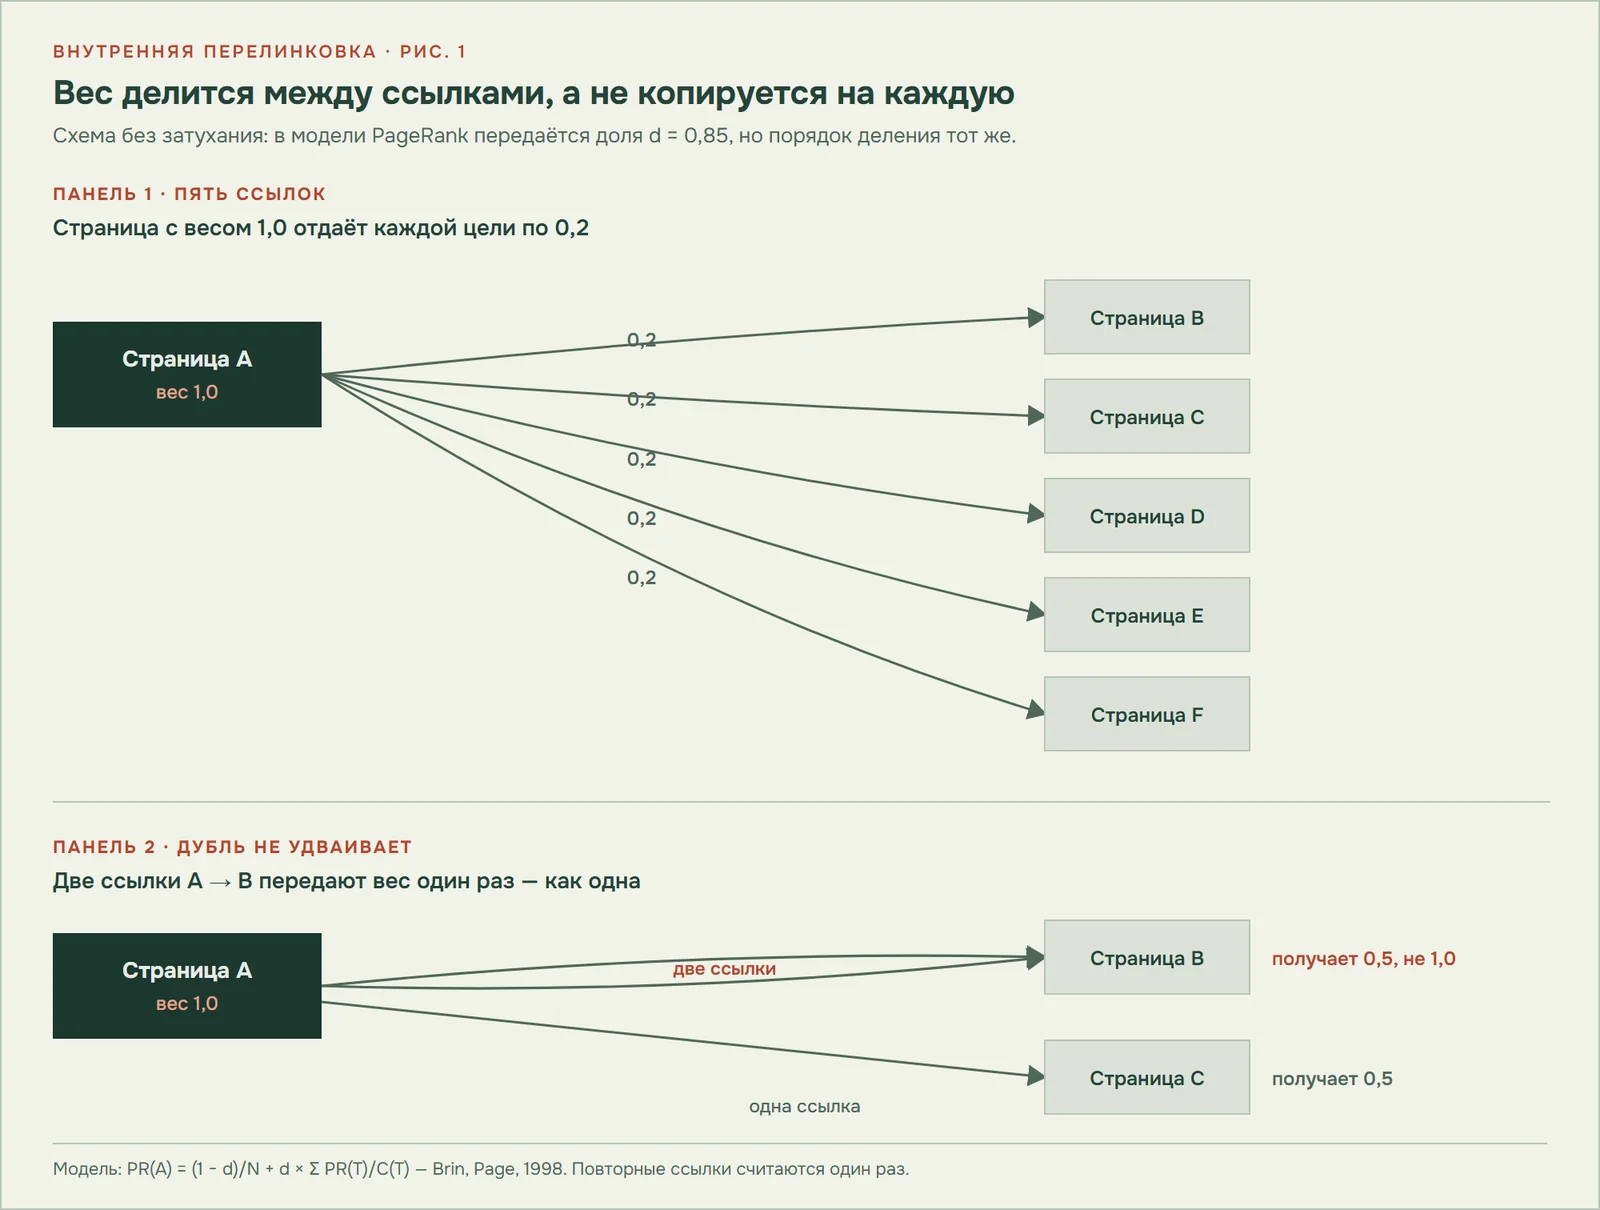
Во второй панели рисунка важный нюанс: две ссылки с A на B не дают B вдвое больше. Повторные ссылки на один и тот же адрес считаются как одна. Об этом ниже, в разделе про дубли.
Здесь же стоит развести два понятия, которые постоянно путают.
Внешний ссылочный вес описывает ссылки на ваш сайт с других сайтов. Именно его обычно имеют в виду, когда говорят «нарастили ссылочную массу».
Внутренний PageRank описывает ссылки внутри сайта. Им можно управлять: вы сами решаете, какие страницы получат вес, а какие останутся на обочине. В статье речь про него.
У статьи про hreflang есть внешние ссылки. Это внешний вес. Внутри блога она ссылается на миграцию и краулинговый бюджет: это уже внутренний. Первый вы не контролируете, второй — полностью.
Чего вес не обещает:
- Google не публикует значения и не подтверждает формулы. Всё, что вы считаете, — модель, а не отчёт поисковика.
- Из того, что страница получает вес, не следует рост позиций. Вес — один из сигналов, а не ручка «плюс 30% трафика».
- Краулеры считают по-разному. Link Score в Screaming Frog, Internal PageRank в Netpeak Spider и ваша формула дадут разные числа на одном сайте. Сравнивать можно только расчёты внутри одного инструмента.
Коротко: вес — это деление. Чем больше целей у страницы и чем меньше веса она получила сама, тем меньше достанется каждой.
Значений веса нет ни в Search Console, ни в Вебмастере: там списки ссылок, а не цифры. Любая цифра веса — результат модели, которую построили вы или инструмент.
Формула: как вес делится на самом деле
Классическая формула PageRank выглядит так:
PR(A) = (1 − d)/N + d × (PR(T1)/C(T1) + PR(T2)/C(T2) + … + PR(Tn)/C(Tn))Где:
PR(A): вес страницы A;d: коэффициент затухания, обычно 0,85;N: число страниц в графе;PR(T): вес страницы, которая ссылается на A;C(T): число уникальных исходящих ссылок с этой страницы.
Читается так: у каждой страницы есть базовая доля (1 − d)/N, а основную часть веса она получает от тех, кто на неё ссылается. Каждый донор отдаёт свой вес поровну между всеми своими целями. Чем больше ссылок, тем меньше доля каждой.
Разберём на пальцах. Есть A с весом 1,0. Она ссылается на B, C, D, E и F. В упрощённой модели без затухания каждая получит 0,2. Если A поставит две ссылки на B и одну на C, целей всё равно две: B получит 0,5, C тоже 0,5. Вторая ссылка на B не сработает как усилитель.
Затухание d не «съедает 15% на каждой ссылке». Оно описывает вероятность, что случайный переход по ссылке продолжится, а не оборвётся. На порядок деления это не влияет: чем больше целей, тем меньше доля каждой. Если считать с d = 0,85, у A с весом 1,0 и пятью целями каждая получит 0,17, а не 0,2. Пропорция та же, числа меньше.
Таблица 1. Что происходит с весом при разных типах ссылок
| Тип ссылки | Что происходит |
|---|---|
| Обычная ссылка из текста | Вес делится между уникальными целями страницы |
| Дубль A → B | Считается один раз, вторая ссылка вес не удваивает |
rel="nofollow" | В моделях краулеров вес не передаёт; Google с 2020 года трактует как подсказку |
| 301-редирект | Ведёт на цель, но длинные цепочки теряют часть сигнала |
rel="canonical" | Краулеры сворачивают на каноническую страницу; для Google это подсказка, а не директива |
| Ссылка, добавленная через JavaScript | Может не попасть в исходный HTML — нужен рендеринг |
Последняя строка важна для сайтов на React, Vue и любых SPA: если ссылка появляется только после выполнения скрипта, часть краулеров её не увидит. Внутренняя перелинковка должна быть в HTML.
Сколько отдаёт ваша страница: 46 статей
Я взял 46 статей блога и посчитал только ссылки из тела. Блок «почитать дальше» считал отдельно: он есть на каждой странице и не отражает осознанную перелинковку.
Ссылки в CTA-блоках, сносках и подписях считал как обычные. Внешние не учитывал, страницы услуг и инструментов считал отдельно. Получилось:
- 261 ссылка из тела;
- 206 уникальных пар «источник → цель»;
- 55 повторных ссылок, то есть 21% от всех;
- медиана 4 ссылки на статью, среднее 5,7;
- 50 взаимных пар.
Дальше — PageRank по формуле выше, d = 0,85, 200 итераций. Значения нормированы так, что сумма весов всех страниц равна 46, а средняя — 1,0. Поэтому 2,58 — это «в 2,6 раза выше средней страницы», а не «2,58 балла из 10». Считать такую матрицу можно в Python: 100–200 итераций, без внешних сервисов.
Серверных логов, данных Яндекс Вебмастера и полного GSC за октябрь: API Вебмастера недоступен, выгрузка заканчивается 09.10.2026. Поэтому обход и каннибализацию я оцениваю по графу и Google, а не по фактическому краулингу.
Таблица 2. Вес страницы и вес, который достаётся каждой цели
| Страница | PageRank | Входящих | Уникальных целей | Вес на цель |
|---|---|---|---|---|
| AI-видимость в ChatGPT и Perplexity | 2,58 | 18 | 14 | 0,18 |
| LLM-подход в B2B SEO | 2,21 | 14 | 11 | 0,20 |
| Плотность триплетов и позиции | 2,20 | 6 | 2 | 1,10 |
| Entity SEO: профиль бренда | 1,92 | 13 | 6 | 0,32 |
| Как извлечь триплеты из текста | 1,87 | 6 | 1 | 1,87 |
| Факторы ранжирования в ИИ-ответах | 1,78 | 18 | 20 | 0,09 |
Смотрите на последние две строки. У статьи про извлечение триплетов PageRank 1,87, у статьи про факторы цитирования 1,78. Первая отдаёт весь вес одной странице: 1,87 на цель. Вторая делит 1,78 на двадцать целей, по 0,09 каждой. Разница в 21 раз.
считать «сколько ссылок» недостаточно. Надо считать, сколько целей и кто ссылается.
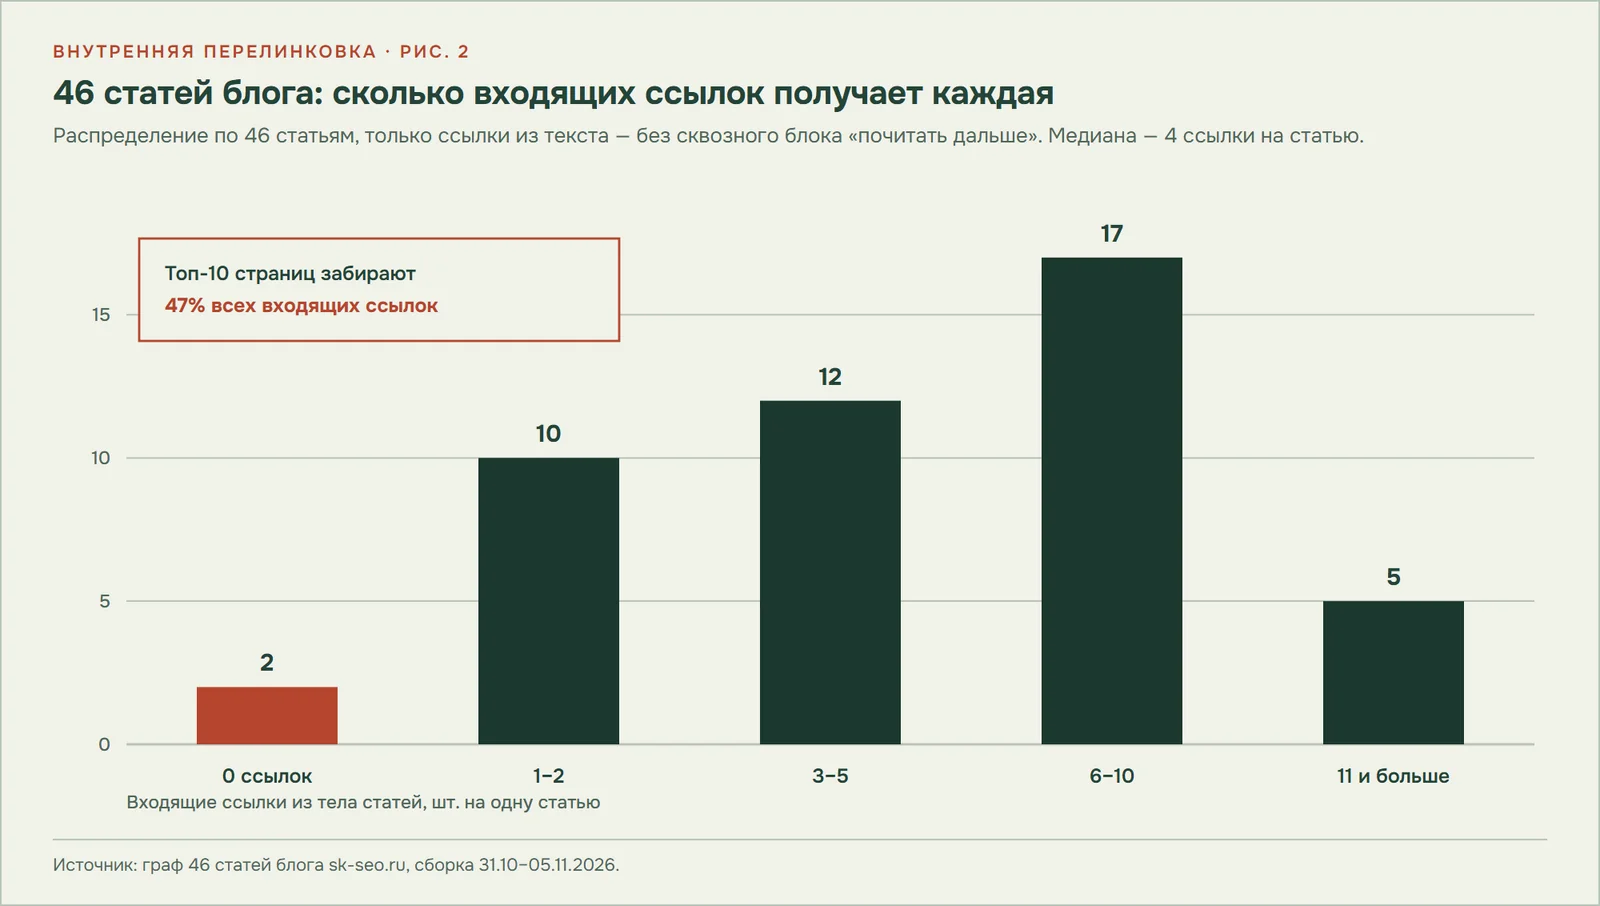
Распределение неравномерное. У двух статей нет ни одной входящей ссылки из тела. У пяти 11 и больше. Топ-10 страниц забирают 47% всех входящих ссылок. Это нормально для сайта, где есть несколько сильных материалов, но означает, что половина блога живёт на голодном пайке.
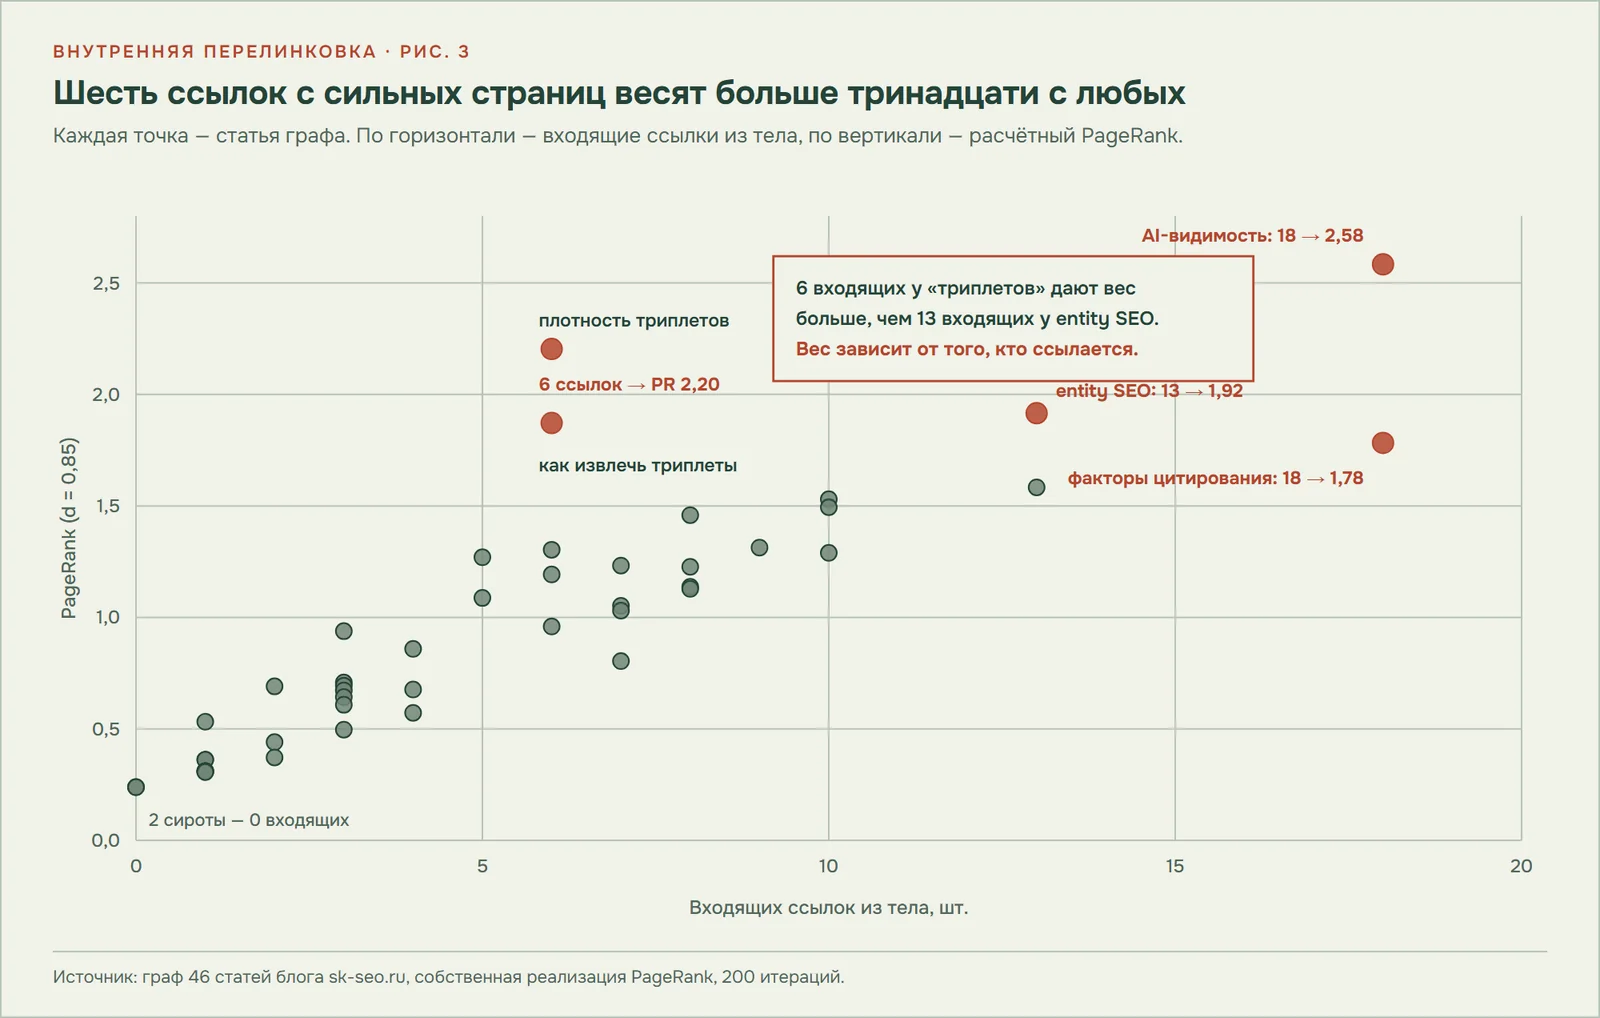
На scatter-графике видно, что точки не выстраиваются в прямую. У «триплетов» 6 входящих и PageRank 2,20, у Entity SEO 13 входящих и 1,92. Причина в том, кто ссылается: шесть ссылок от сильных страниц дают больше, чем тринадцать от слабых.
Ещё одна метрика: плотность. У обзорной статьи про AI-видимость 8,86 ссылки на 1 000 слов, у исследования про миграцию 0,33. Разница в 27 раз. Это не «хорошо» и не «плохо»: у обзора задача провести читателя по теме, у исследования — рассказать один результат. Но вес на цель у обзора ниже.
Страницы-сироты и тупики: как найти за 15 минут
Сирота: страница, на которую нет ни одной входящей ссылки из тела. Тупик: страница, с которой нет ни одной исходящей ссылки в тело.
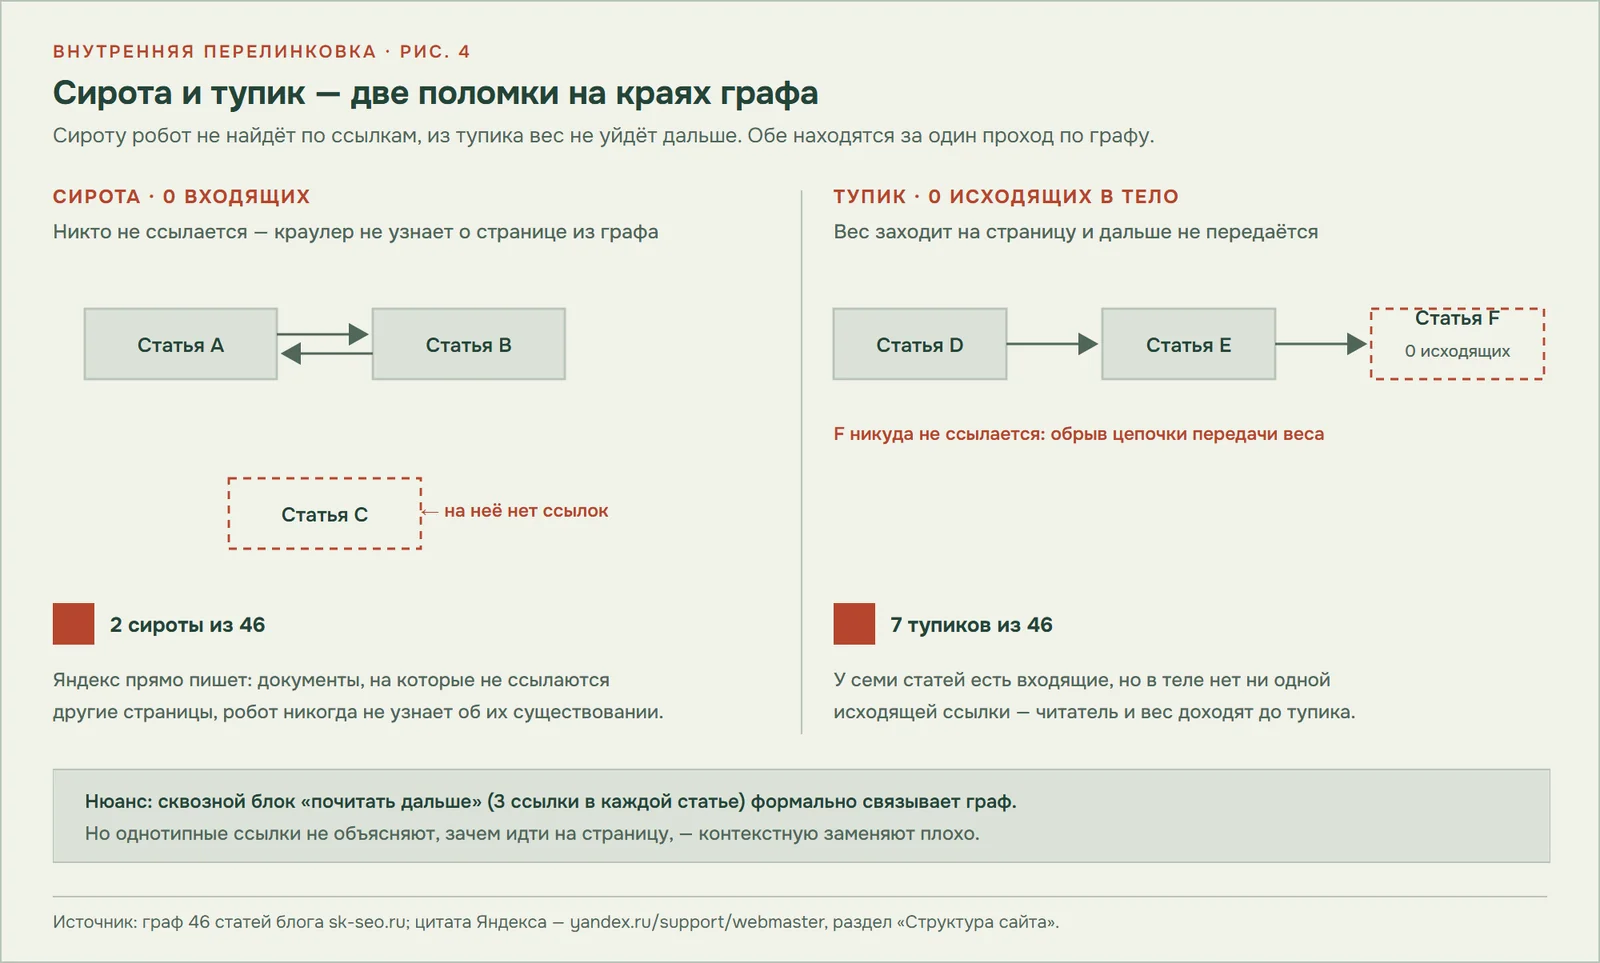
В моём блоге две сироты. «Индексация сайта» — новая статья, её ещё никто не упомянул. «Как проверять позиции в Google» — полностью изолированная: ни входящих, ни исходящих.
Тупиков семь: про robots.txt и AI-ботов, hreflang, источники Нейро Алисы, краулинговый бюджет, основной контент Google, проверку позиций и спрос на ИИ в Яндексе. У них есть входящие ссылки, но вес дальше не уходит.
Об этом лучше всего сказал Яндекс в справке «Структура сайта»:
Если на вашем сайте есть документы, на которые не ссылаются другие страницы, робот Яндекса никогда не узнает про их существование, и они не будут учитываться при поиске.
Там же — про глубину: время индексации зависит от уровня вложенности страницы. Чем глубже, тем дольше ждать. Почти все статьи блога доступны за два клика от главной; отдельные исследования выведены на главную. Поэтому здесь глубина не болит. В каталогах и услугах — болит: страница на пятом клике ждёт индексации дольше.
Как найти за 15 минут:
- Откройте Search Console → «Ссылки» → «Top internally-linked pages». Это список страниц, на которые чаще всего ссылаются изнутри. Тех, кого в нём нет, проверяйте отдельно.
- В Яндекс Вебмастере — раздел «Ссылки» → «Внутренние ссылки». С 30 мая 2024 года там есть статистика по внутренним и битым ссылкам.
- Если есть краулер (Screaming Frog, Netpeak Spider, SiteAnalyzer), постройте отчёт по входящим ссылкам и отфильтруйте нули.
- Без краулера сверьте карту сайта вручную: у каждой страницы должен быть хотя бы один входящий контекстный путь.
Что делать с сиротами: 2–3 контекстные ссылки из статей той же темы, не из футера и не из «почитать дальше». Для «Индексации» это краулинговый бюджет и технический чек-лист.
Оговорка: сквозной блок «почитать дальше» формально делает граф связным. Три ссылки есть у каждой статьи. Но однотипные карточки не объясняют, зачем читателю идти именно туда, и не заменяют ссылку в тексте. Поэтому в расчёте они не участвуют.
Дубли ссылок: почему 10 ссылок — это одна
55 из 261 ссылки повторные. Это 21%. Самая частая пара: статья про AI-видимость ссылается на исследование о факторах цитирования десять раз. Анкоры при этом разные: «длину», «разметку», «авторитет домена», «падение вчетверо».
Кажется, что десять ссылок усиливают сигнал. В модели PageRank это не так. Повторная ссылка на тот же адрес считается один раз. В Link Score у Screaming Frog то же правило: multiple links from URL A to URL B are ignored, повторные ссылки не учитываются.
Что происходит на практике: страница тратит десять мест в тексте, но передаёт вес как за одну ссылку. Плюс размывается анкорный сигнал: у цели десять разных анкоров вместо одного точного.
- одна ссылка на цель в одном смысловом блоке;
- если нужно вернуться к странице позже, ставьте ссылку с другим анкором и с другой задачей («подробнее про расчёт»), но не десять раз в одном списке;
- проверьте пары «источник → цель» счётчиком: если больше одной, сокращайте.
В моём случае 17 из 31 ссылки обзорной статьи вели на уже указанные адреса. После чистки у неё останется 14 целей и 14 ссылок: то же покрытие, меньше шума. Проверить у себя просто: выгрузите все внутренние ссылки и сгруппируйте по паре «источник → цель». Всё, где больше одной, — кандидат на чистку.
Анкоры: 33 точных, 164 частичных, 64 мимо
Я сверил все 261 анкор с заголовками целевых страниц. Получилось три группы.
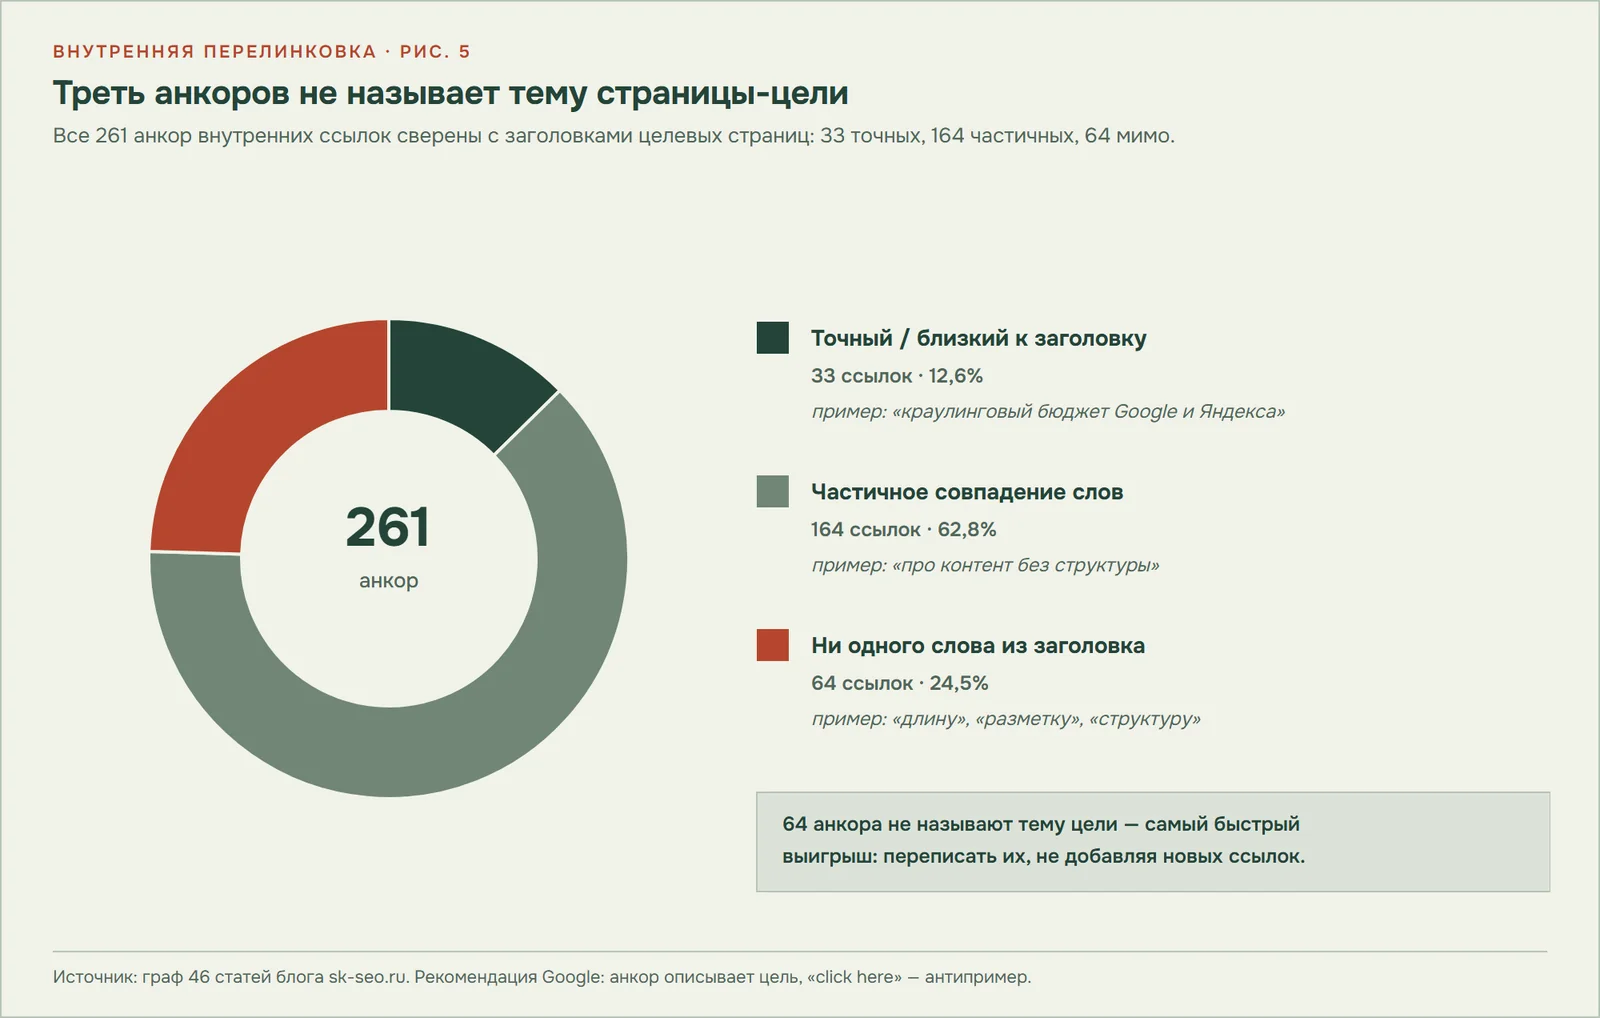
Точный или близкий: 33 ссылки (12,6%). Пример: «краулинговый бюджет Google и Яндекса» ведёт на статью с таким заголовком.
Частичный: 164 ссылки (62,8%). Пример: «про контент без структуры» ведёт на статью «Почему контент без структуры не спасает даже сильный бренд».
Мимо: 64 ссылки (24,5%). Здесь ни одного слова из заголовка цели: «длину», «разметку», «структуру», «поведение», «рендеринг». Формально это ссылки, фактически это потерянный сигнал.
Пустых анкоров вроде «подробнее» или «читать» нет, и это хорошо. Но 64 ссылки можно улучшить без добавления новых: переписать анкор так, чтобы он называл тему.
Таблица 3. Примеры анкоров из графа
| Анкор | Откуда → куда | Оценка |
|---|---|---|
| «краулинговый бюджет Google и Яндекса» | JavaScript SEO → краулинговый бюджет | точный |
| «Факторы ранжирования в ИИ-ответах» | AI-видимость → факторы цитирования | близкий к заголовку |
| «про контент без структуры» | AI-видимость → контент без структуры | частичный, но понятный |
| «длину», «разметку», «структуру» | AI-видимость → факторы цитирования | не называют тему |
Рекомендация Google простая: анкор должен быть описательным и конкретным, «click here» — антипример. Правило, по которому я проверяю: анкор = тема целевой страницы в 3–5 словах. Если по анкору нельзя понять, куда ведёт ссылка, его нужно переписать.
Информационные ссылки получают анкор-тему, коммерческие — анкор-действие, навигационные — название раздела. Смешивать не надо: «заказать» на статью и «как считается вес» на услугу — плохая пара.
И ещё: анкоры не лечат каннибализацию. Они помогают понять, какая страница за какой вопрос отвечает, но если две страницы целятся в один интент, разные анкоры их не разведут.
Каннибализация запросов: чем отличается от дубля
Каннибализация возникает, когда две страницы сайта претендуют на один и тот же запрос. Поисковик выбирает одну, вторая болтается на 40–90 позиции и собирает показы, которые могли бы достаться основной.
Это не дубль контента. Дубль — одинаковый текст по двум адресам. Лечится технически: 301 или canonical. Каннибализация — разные страницы под один интент. Лечится структурой: развести темы, выбрать главную, перелинковать.
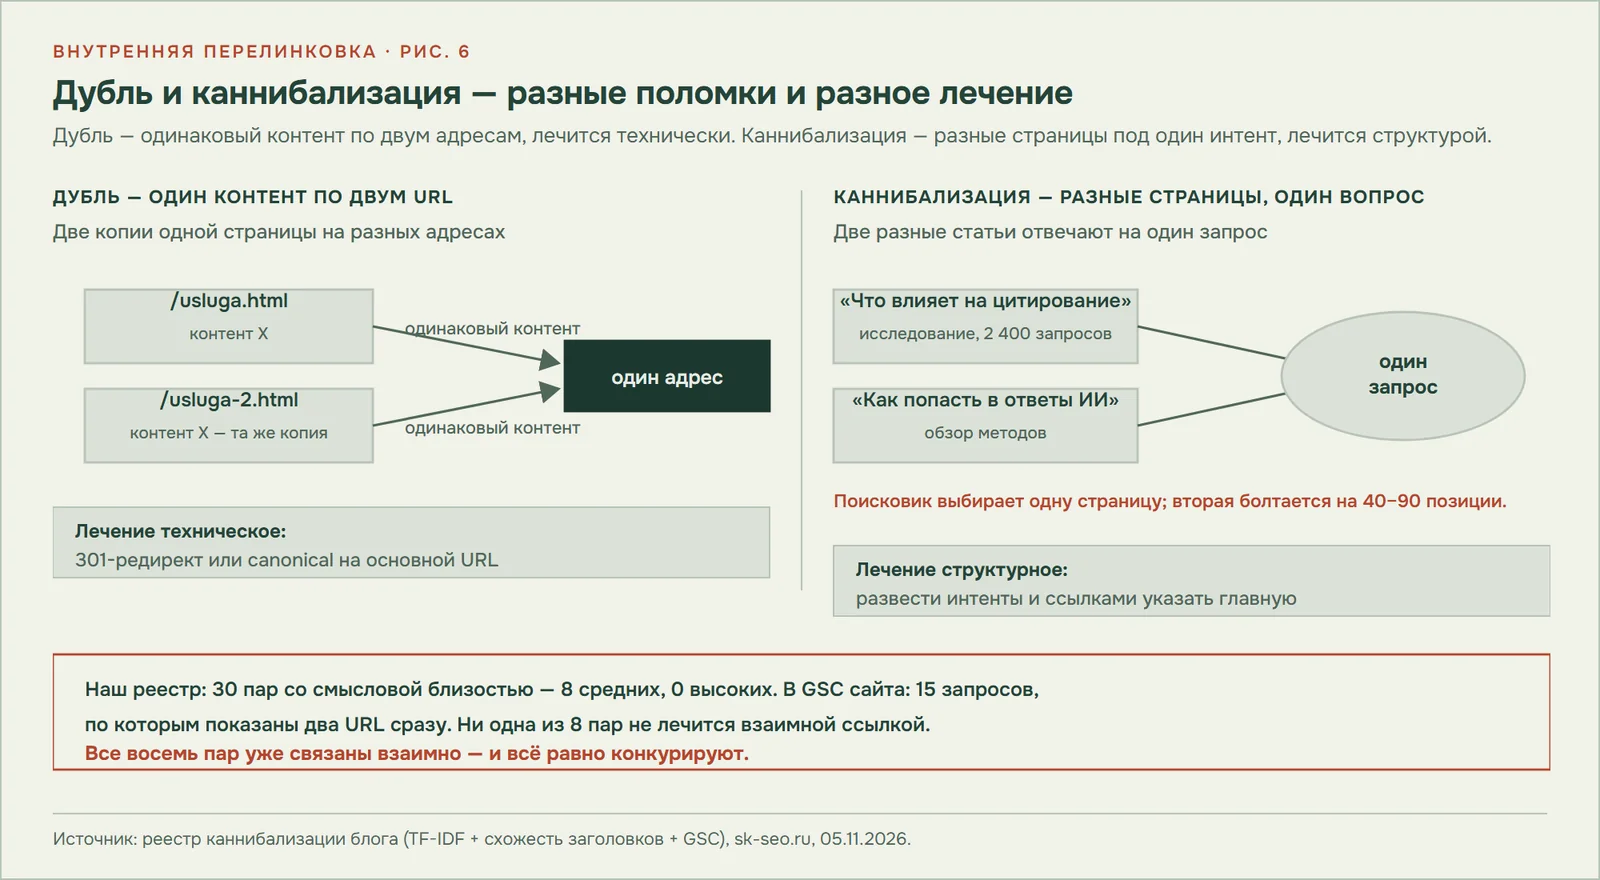
В реестре блога 30 пар со смысловой близостью. Из них 8 средних и 22 низких. Высоких нет: «высокий» риск ставится только тогда, когда у пары есть общие запросы в GSC, а таких пар не нашлось. При этом все восемь средних пар уже связаны взаимно, но смысловая близость никуда не делась. Взаимная ссылка не лечит каннибализацию.
Это не значит, что каннибализации нет. Это значит, что на 46 статьях и 1 908 показах GSC (окно 01.06–09.10.2026) её не подтверждает. Смотреть надо шире: на весь сайт.
В Search Console 15 запросов, по которым показываются два URL и больше. Разберём самый показательный.
Как проверить у себя: в интерфейсе GSC нет отчёта «запрос → все страницы». Выгрузите пары «запрос — страница» через Search Console API (dimension query + page) или плагин, сгруппируйте по запросу и оставьте те, где больше одного URL. Дальше смотрите позиции: если один URL в топ-10, а второй ниже 40, это повод проверить интенты. Скорее всего, каннибализация, но бывает и «широкая видимость» двух разных страниц.
Семь тематических гнёзд, где риск есть всегда:
| Гнездо | Статей | Риск | Что делать |
|---|---|---|---|
| AI-детекторы и машинность текста | 4 | средний | развести: измерение, метрика, сравнение моделей, техники |
| Триплеты | 2 | низкий, но пузырь 5+5 ссылок | убрать дубли, разные анкоры |
| Топ выдачи Google и Яндекса | 5 | средний | хаб «что отличает топ» + разные объекты в H1 |
| GEO и AI-видимость | 6 | высокий по коммерческому ключу | развести статью и услугу |
| Индексация и обход | 4 | средний | «Индексация сайта» — хаб, остальные ссылаются вверх |
| Аудит | 3 | низкий | связать с чек-листом |
| Конференции | 2 | низкий | не трогать |
Правило простое: один кластер запросов — одна страница. Если появляется вторая, она должна отвечать на другой вопрос, а не пересказывать первый другими словами. Если оба URL в топ-10, это не всегда каннибализация: возможно, они отвечают на разные интенты. Смотрите H1 и первые абзацы, а не только запрос.
Кейс: услуга и хаб делят запрос «seo консультация»
Самый показательный случай — «seo консультация»: страница услуги и хаб услуг делят один интент.
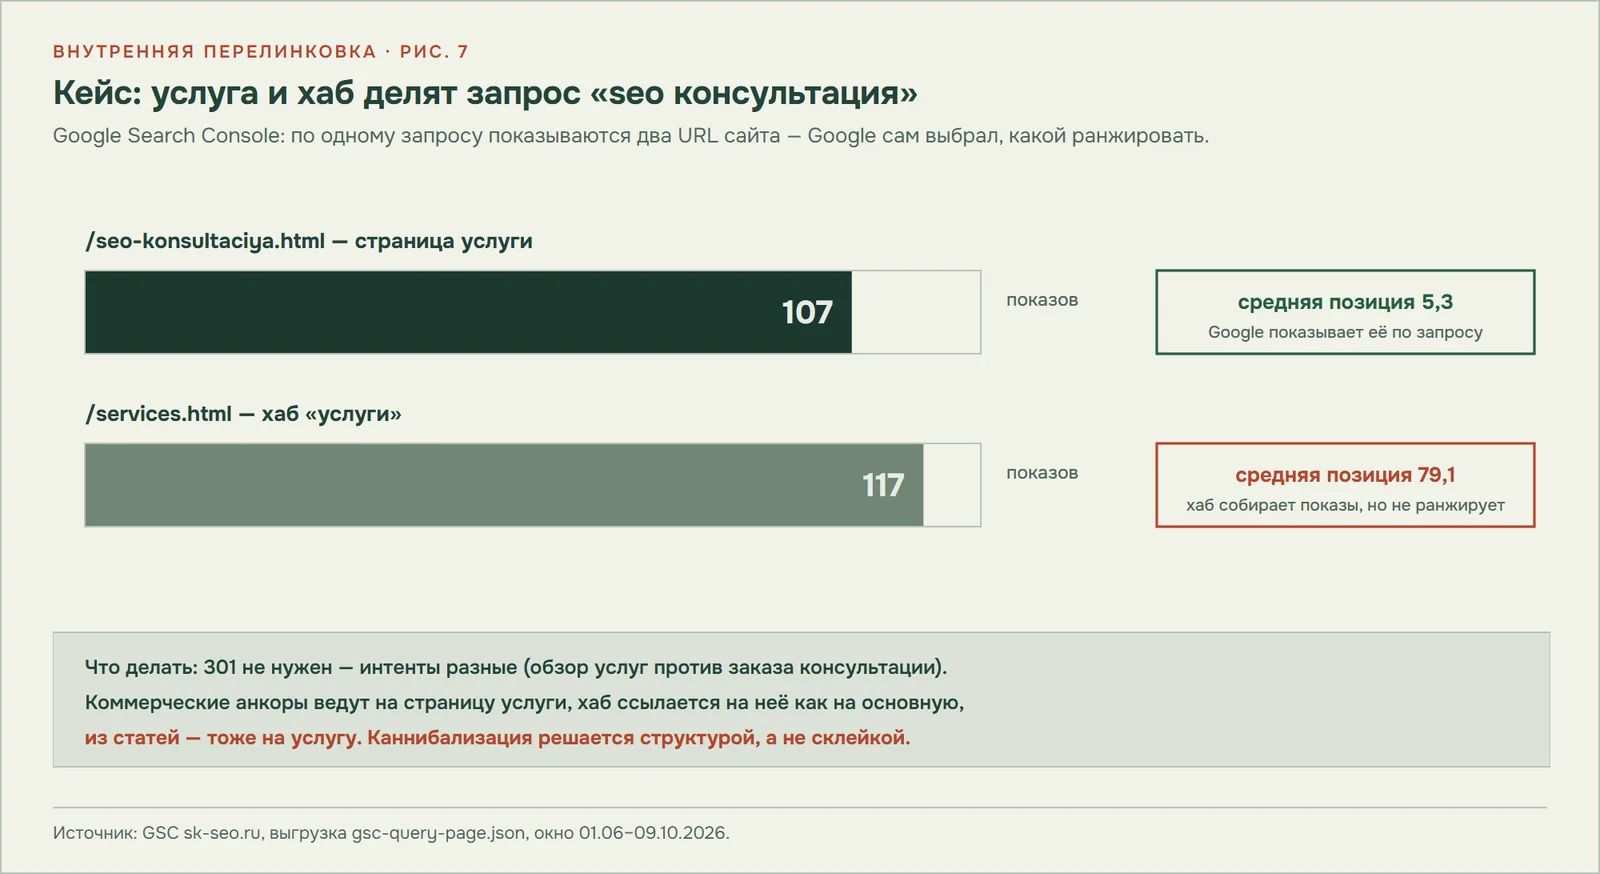
Что видно: у /seo-konsultaciya.html 107 показов и средняя позиция 5,3. У /services.html 117 показов и позиция 79,1. Google выбрал страницу услуги; хаб собирает показы, но не ранжируется. В заголовке хаба — «SEO-услуги», а не «консультация». Скорее всего, Google считает его релевантным из-за блока консультаций и внутренних ссылок; точную причину GSC не показывает. Страница услуги выигрывает, потому что отвечает на заказ.
склеивать 301. Интенты разные. Хаб отвечает на «какие услуги есть», а страница услуги — на «заказать консультацию». 301 сведёт две страницы в одну и лишит хаб обзорной роли.
коммерческие анкоры вести на страницу услуги, хаб оставить обзором и сослаться с него на услугу как на основную. Из статей тоже ведите на услугу, если речь про заказ, и на хаб, если про выбор. На практике: с хаба «заказать консультацию», из статей «консультация по SEO», внутри услуги «все услуги». Один интент, одна главная страница.
Второй пример мельче, но типичный: запрос «se audit» показывается и по инструменту /tools/seo-audit.html (11 показов, позиция 77,3), и по статье «Почему SEO-аудит бесполезен» (3 показа, позиция 40,3). Инструмент и статья конкурируют за один запрос. Лечится ссылками: статья объясняет, инструмент проверяет; в статье поставьте ссылку на инструмент с анкором «проверить сайт», в инструменте — на статью с анкором «как читать аудит».
Чек-лист аудита перелинковки
- Собрать граф.Краулер (Screaming Frog, Netpeak Spider, SiteAnalyzer) или выгрузка из GSC и Вебмастера. Выход: таблица «страница → входящие, исходящие». Если краулера нет, начните с GSC: отчёт о ссылках покажет топ внутренних ссылок и страницы, на которые ссылаются чаще всего.
- Найти сирот и тупики.Отфильтровать нули. Выход: список страниц, которым нужна ссылка, и страниц, с которых вес не уходит.
- Посчитать дубли.Пары «источник → цель» больше одной. Выход: список ссылок на удаление или переписывание.
- Проверить анкоры.Доля анкоров без слов из заголовка цели. Выход: список на перепись. У меня 64 ссылки.
- Сверить каннибализацию.Запрос → два URL и больше. Выход: список пар и решение по каждой: развести, объединить, оставить.
- Проверить деньги-страницы.Сколько ссылок ведёт на услуги и инструменты и с какими анкорами. У меня 156 ссылок из 39 статей, но 39 ссылок ведут в контакты и «обо мне».
- Замерить до и после.Показы и позиции через 4–8 недель. Не клики: на малом трафике они шумят. Что считать результатом: рост показов по целевым запросам, вход страницы в топ-20 и рост числа запросов, по которым она показывается. Позиции без показов ничего не доказывают: страница либо не в индексе, либо не отвечает на запрос.
Что сделать за вечер
Если на полный аудит нет времени, начните с четырёх вещей. Порядок не случайный: сначала дешёвое и обратимое, потом ссылки.
- Перепишите 64 анкора.Это самый быстрый выигрыш: новых ссылок не добавляете, сигнал улучшаете. Список собирается за один проход по графу: ссылка, цель, анкор.
- Добавьте по 2–3 ссылки двум сиротам.«Индексация сайта» должна получить ссылки из материалов про обход и краулинговый бюджет. «Проверке позиций в Google» нужны ссылки из статьи про SEO-аудит и из технического чек-листа.
- Развяжите семь тупиков.По одной ссылке вниз по смыслу: с краулингового бюджета на индексацию, с hreflang на миграцию, с источников Алисы на цитирование.
- Поставьте 5 ссылок на приоритетную страницу.Не двадцать из хвоста, а пять с сильных страниц: AI-видимость (PR 2,58), LLM для B2B (2,21), чек-лист техаудита (1,53), краулинговый бюджет (1,05), миграция (0,31). Этого достаточно, чтобы страница получила вес и попала в граф.
Вес не «перетекает» сам. Он делится там, куда вы поставили ссылки. И чем раньше вы посчитаете, куда именно, тем дешевле обойдётся перелинковка.
Не закрывайте страницы от индексации «чтобы перелить вес»: noindex убирает адрес из выдачи, но не отменяет обход и ссылки на странице. Для слияния есть 301, для разведения нужны структура и анкоры.
Хотите, посчитаю граф вашего сайта и покажу, где теряется вес? Напишите в Telegram или через контакты.
Частые вопросы
Модель одна. PageRank — историческое название алгоритма, «ссылочный вес» — обиходное. Google не публикует значения, а краулеры считают свою версию: Link Score в Screaming Frog, Internal PageRank в Netpeak Spider. Сравнивать числа между инструментами нельзя, внутри одного можно.
Жёсткого лимита нет. Каждая дополнительная ссылка уменьшает долю каждой цели. В моём блоге медиана 4 ссылки на статью, максимум 31. Если у вас 50 ссылок в статье, это не штраф, но вес каждой будет маленьким.
В документации Google нет правила, что ссылка в футере весит меньше. В модели вес делится по ссылкам, а не по блокам. Футер может считаться шаблонным блоком и учитываться иначе, но это не правило, которое можно проверить. Проверяйте на своём сайте: если ссылка нужна читателю, ставьте её в текст.
Нет, если интенты разные. Canonical нужен для одинаковых или очень похожих страниц; для Google это подсказка. Если две статьи отвечают на разные вопросы, canonical не сделает одну из них главной. Нужно разводить темы или объединять через 301.
Показы через 2–4 недели, позиции через 4–8. На малом сайте быстрее, на большом дольше. Без GSC и логов эффект не проверить: «стало лучше» ничего не измеряет.
Источники
- Google Search Central: ссылки и анкоры (обновлено 31.12.2025).
- Яндекс Вебмастер: структура сайта.
- Search Console: отчёт Links.
- Яндекс Вебмастер: раздел «Ссылки» (30.05.2024).
- Google: эволюция nofollow (2019).
- Google: канонические URL.
- Screaming Frog: Link Score.
- Netpeak Software: Internal PageRank.
- Brin S., Page L. The Anatomy of a Large-Scale Hypertextual Web Search Engine, 1998; формула и коэффициент затухания: PageRank, Wikipedia.