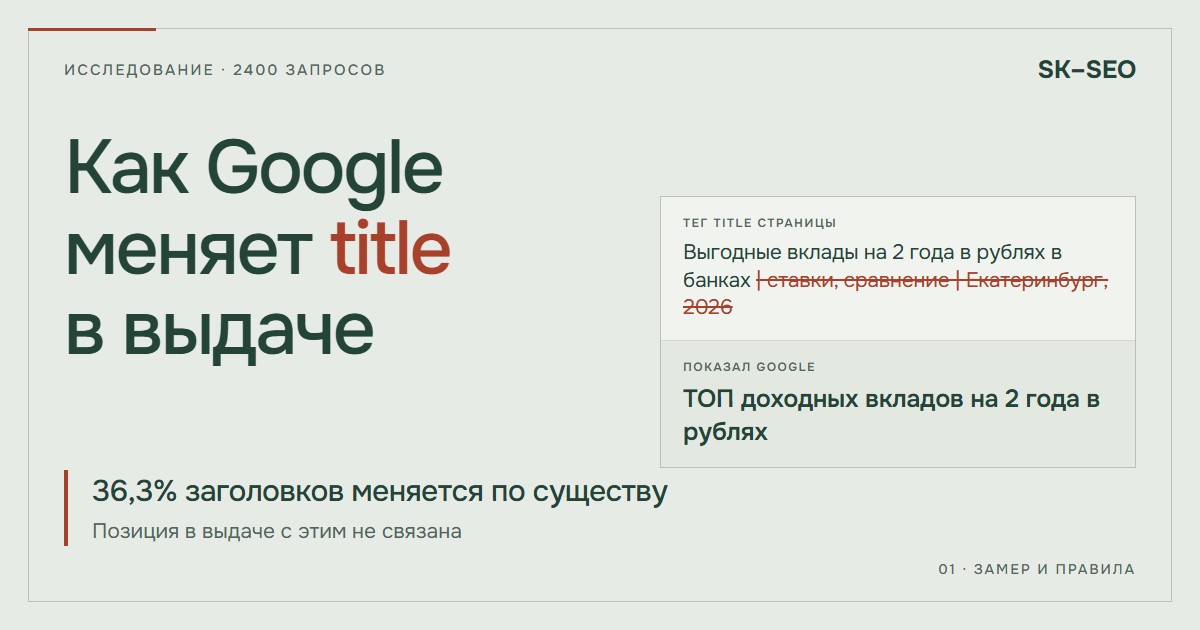
Страница bankinform.ru написала в теге <title>: «Выгодные вклады на 2 года в рублях в банках | ставки, сравнение | Екатеринбург, 2026». Google на пятом месте по запросу «вклад на 2 года» показал другое: «ТОП доходных вкладов на 2 года в рублях».
Я сопоставил title страниц с заголовками, которые Google показал в поиске: 2400 запросов, 16 ниш, Москва, поиск с компьютера, позиции 1–50. После очистки осталось 88 660 пар «страница — заголовок в выдаче». В 47,2% случаев Google сохранил заголовок или только обрезал его по ширине. В 16,5% изменил только название сайта — убрал или добавил его. В остальных 36,3% изменился сам текст заголовка: например, Google подставил H1, убрал окончание или переставил слова.
Чтобы проверить связь с позицией, внутри каждого запроса я сравнил страницы из топ-20 с результатами на позициях 21–50. Если замены встречаются в обеих группах одинаково часто, случайный уровень — 50 сравнений из 100. У меня вышло 50,2, то есть связи с позицией не видно.
Один и тот же тег, три разных результата
Три страницы, три результата: заголовок заменён, оставлен как есть и обрезан.
Выгодные вклады на 2 года в рублях в банках | ставки, сравнение | Екатеринбург, 2026
ТОП доходных вкладов на 2 года в рублях
ТОП доходных вкладов на 2 года в рублях
Таунхаусы до 5 млн. руб. в Подмосковье
Таунхаусы до 5 млн. руб. в Подмосковье
Таунхаусы до 5 млн. руб. в Подмосковье
Как выбрать первую кофемашину: 5 главных вопросов при покупке для дома
Как выбрать первую кофемашину: 5 главных вопросов …
Как выбрать свою первую кофемашину: 5 ключевых вопросов перед покупкой
Что Google говорит о заголовках в выдаче
Я прочитал документацию Google Search Central «Influencing Title Links in Google Search» и два поста блога — «An update to how we generate web page titles» от 24 августа 2021 года и «More information on how Google generates titles» от 17 сентября 2021 года. Все три текста открывал 14 октября 2026 года. Ниже пересказ и таблица случаев; цитат почти нет.
Откуда Google берёт заголовок
Google формирует заголовок результата автоматически, чтобы помочь пользователю понять содержание страницы. В документации перечислены девять возможных источников:
- содержимое тега
<title>; - главный видимый заголовок на странице;
- заголовочные элементы, например
<h1>; - тег
og:title; - другой текст, выделенный стилями как крупный и заметный;
- прочий текст страницы;
- текст внутренних ссылок на странице (анкор);
- текст внешних ссылок, ведущих на эту страницу;
- разметка
WebSite.
- Содержимое тега titleИспользуется чаще всего
- Главный видимый заголовок на странице
- Заголовочные элементы, например H1
- Тег og:title
- Другой крупный и заметный текст (по стилям)
- Прочий текст страницы
- Якорный текст ссылок на самой странице
- Тексты ссылок, которые ведут на страницу
- Разметка WebSite
Если файл robots.txt запрещает Google читать страницу, но на неё ведёт ссылка с другого сайта, Google может сформировать заголовок по тексту этой внешней ссылки — анкору. Изменения на странице Google заметит только после повторного обхода и обработки, на это уходит от нескольких дней до нескольких недель. Заменить заголовок конкретного сайта вручную Google не может.
Когда Google заменяет ваш title
В документации перечислены типичные проблемы, при которых Google ищет заголовок в других местах. Я свёл их в таблицу вместе с примерами самого Google.
| Случай | Что происходит на странице | Что делает Google |
|---|---|---|
| Половина пустая | Часть текста в теге отсутствует: «| Site Name» | берёт недостающее из заголовков и крупного текста страницы: «Product Name | Site Name» |
| Устаревший title | Страница из года в год обновляется, а в теге старый год: «2020 admissions criteria», видимый заголовок «2021 admissions criteria» | подставляет год из видимого заголовка |
| Неточный title | Тег не отражает содержимое, например статичный список товаров на странице с динамическим наполнением | сокращает до общего: «Giant stuffed animals, teddy bears, polar bears» превращается в «Stuffed animals» |
| Один шаблон для нескольких страниц | Одинаковый тег у части страниц сайта: три страницы с названием сериала без номера сезона | достаёт различающую часть из крупного заголовка: «Season 1 - …», «Season 2 - …» |
| Нет главного заголовка | Несколько одинаково крупных и заметных заголовков | может взять первый из них |
| Несовпадение письменности | Страница на хинди, а тег латиницей или по-английски | выбирает текст, который совпадает по языку и письму с основным содержимым |
| Повтор названия сайта | Название сайта в теге повторяет то, что уже показано рядом в выдаче | может убрать название из заголовка |
| Пустой title или его нет | Тега нет вовсе или он не заполнен | собирает заголовок из других источников |
Что Google рекомендует писать
- Каждой странице нужен свой title в теге
<title>, описательный и краткий. Общие слова вроде «Главная» или «Профиль» ничего не говорят пользователю. - Ограничения длины нет, но в выдаче заголовок обрезается по ширине устройства.
- Не набивайте тег ключами. Фраза «Foobar, foo bar, foobars, foo bars» только выглядит спамом.
- Не повторяйте один и тот же шаблонный текст в тегах разных страниц. Если у всех страниц магазина title «Дешёвые товары», пользователь не отличит одну от другой.
- Название сайта ставьте коротко в начало или в конец через разделитель: дефис, двоеточие или вертикальную черту.
- Покажите, какой текст на странице главный: сделайте его заметнее остального (крупнее, первым в видимом
<h1>), чтобы несколько одинаково выделенных заголовков не путали систему. - Пишите тег на том же языке и тем же письмом, что и основной текст страницы.
- Не пишите цену авиабилетов в теге: она меняется быстро, и Google, скорее всего, не покажет её в заголовке (это есть в документации).
Как часто, по словам Google
В сентябре 2021 года Google писал, что тег title используется примерно в 87% случаев (до правок системы около 80%). Почему не в 100%: с 2012 года Google использует текст за пределами тега, если считает, что тег может плохо описывать страницу. Бывают пустые теги, один и тот же тег на всех страницах и страницы вообще без title. В августовском посте цифра осторожнее: тег используется более чем в 80% случаев.
Зависит ли заголовок от запроса
Здесь Google высказался прямо. В августовском посте 2021 года сказано, что раньше заголовок мог меняться в зависимости от запроса, а с новой системой этого в целом больше не происходит: заголовок должен описывать документ вне зависимости от конкретного запроса.
Очень длинные заголовки и название сайта
Для очень длинного заголовка система, по словам Google, может выбрать наиболее релевантную часть, а не брать начало и обрезать более полезное. Название сайта она в некоторых случаях может добавить, если считает это полезным. Это согласуется с двумя приёмами из моих данных, о которых речь ниже.
Чего Google не раскрывает
- Как именно система решает, что тег «не описывает страницу». Критериев и порогов в документации нет.
- Что считать «очень длинным» заголовком и по какому признаку выбирается «наиболее релевантная часть». Порогов нет.
- Какая длина безопасна. Сказано только, что лимита нет, а обрезка идёт по ширине. Цифры дальше мои.
Как я сравнивал заголовки
Для каждого результата выдачи я сопоставляю два текста. Первый: заголовок, который Google показал в выдаче (я получил через XMLRiver, сервис сбора поисковой выдачи; Москва, google.ru, поиск с компьютера, 2 октября 2026 года). Второй текст — поля самой страницы: title и заголовки H1, H2 и H3 (главный, второй и третий уровни). Выдача и запросы те же, что в исследовании про триплеты. Каждой паре я присваиваю класс, то есть категорию того, что стало с заголовком: совпал, обрезан по ширине, убрано название сайта, подставлен H1, отрезан хвост и так далее.
В анализ вошли только страницы с успешным ответом сервера (код HTTP 200) и непустым тегом title. Я исключил YouTube (там Google показывает оригинальное название видео, а моя загрузка получила русский автоперевод) и страницы защиты от ботов с заголовками вроде «Проверка безопасности» или «Выключите VPN». Из 107 103 строк выдачи в анализе осталось 88 660 (82,8%). Что дала перезагрузка страниц в браузере, показано в разделе «Что показала перезагрузка в браузере».
- 01 / ЗАПРОСЫ2 400 запросов16 ниш
- 02 / ВЫДАЧА107 103 строкиПозиции 1–50
- 03 / СТРАНИЦЫ104 987 строкHTML получен для 98,0%
- 04 / ФИЛЬТРУсловия включенияHTTP 200 · title не пустой; исключены YouTube и антибот-страницы
- 05 / СВЕРКА88 660 пар82,8% · title ↔ H1/H2/H3 → класс изменения
Где на шкале лежит 50,2
Что Google делает с заголовком
Из каждых 100 заголовков примерно 47 Google оставляет как есть или обрезает, 16,5 правит только в названии сайта и 36 меняет по существу. С позицией замена не связана — по крайней мере, в моих данных этого не видно.
- Совпал (отличаются только знаки)17,0%
- Обрезан по ширине (многоточие)30,2%
- Изменено только название сайта16,5%
- Подставлен H113,0%
- Укорочен или дополнен14,5%
- Слова переставлены5,2%
- Не объясняется сохранёнными полями3,1%
- Взят H2 или H3 (доля меньше одной ячейки)0,5%
| Что произошло | Как я это распознаю | Доля пар |
|---|---|---|
| Совпал (отличаются только знаки) | после нормализации регистра, кавычек и тире строки равны или сходство не ниже 0,92 | 17,0% |
| Обрезан по ширине | в выдаче заканчивается многоточием, видимая часть — начало тега | 30,2% |
| Изменено только название сайта | убран или добавлен короткий сегмент (до пяти слов) в начале или конце | 16,5% |
| Подставлен H1 | заголовок в выдаче совпадает с H1 страницы | 13,0% |
| Укорочен или дополнен | часть тега отброшена без многоточия (12,5%) либо заголовок стал короче или длиннее (ещё 2,0%) | 14,5% |
| Слова переставлены | те же слова в другом порядке: чаще бренд или слоган уходят вперёд | 5,2% |
| Не объясняется сохранёнными полями | заголовок взят из других источников: og:title, якорей, разметки WebSite, прочего текста; разбор в разделе про перезагрузку в браузере | 3,1% |
| Взят H2 или H3 | заголовок в выдаче совпадает с одним из подзаголовков | 0,5% |
Цифры можно сравнивать с чужими замерами, но осторожно: у каждого своё определение «изменил». Мои три уровня и ближайшие чужие цифры — в таблице.
| Что считать изменением | Моя доля | С чем сравнить |
|---|---|---|
| Любое отличие, кроме обрезки по ширине | 52,8% | Zyppy (2022): переписано 61,6% (80 959 тегов, 2370 сайтов); способ счёта в публикации не раскрыт |
| По существу: без обрезки и без названия сайта | 36,3% | Ahrefs (2021): 33,4% (953 276 страниц из топ-10); мелкие различия и бренд за отличие не считал |
| Тег использован как есть: совпал, обрезан или отличается только названием сайта | 63,7% | Google (2021): тег используется примерно в 87% случаев; как именно считал, не раскрыто |
Мои цифры рядом с чужими замерами
Любое отличие, кроме обрезки по ширине
Изменено по существу
Тег использован как есть
Мой уровень «по существу» (36,3%) почти совпадает с Ahrefs (33,4%): они тоже не считали отличием мелкие знаки и название сайта. Zyppy насчитал больше, и я не могу сказать, какие отличия они считали. С цифрой Google 87% сопоставима только строка «как есть» (63,7%), да и то условно: Google не раскрывает, что для него «использован как есть».
Граница между названием сайта и смысловой частью у любого классификатора размыта. Я проверил её независимой разметкой (описание в методике) и пересчитал данные при более широком правиле: доля содержательных замен тогда 31,4% вместо 36,3%. Все выводы ниже от выбора границы не меняются.
Позиция и запрос
Доля содержательных замен в разных полосах выдачи близка: 35,2% в позициях 1–3 и от 36,0% до 37,2% в остальных. Сравнение топ-20 с позициями 21–50 внутри каждого запроса даёт 50,2 из 100 (50 — случайный уровень; 95%-й доверительный интервал — 49,8–50,5; 2369 запросов). Связи замены с позицией не видно.
Доля пар, где заголовок изменён по существу (без обрезки по ширине и без замены только названия сайта).
Зависимость от запроса я проверил напрямую. Из 13 951 страницы, попавшей в выдачу минимум по двум запросам, у 262 (1,9%) Google показал разные заголовки, если не считать обрезку одного и того же. Среди страниц, найденных по трём и более запросам, такая доля 2,5%; по пяти и более 3,7%; по десяти и более (858 страниц) 6,5%. Среди страниц, у которых в анализе есть минимум две пары: 36,0% изменены по существу во всех запросах, 62,3% ни в одном и только 1,6% в части запросов.
Один и тот же URL в разных запросах
- Изменён по существу во всех запросах
- Не изменён ни в одном
- Изменён в части запросов: 1,6%
Это согласуется с тем, что Google написал прямо: раньше заголовок мог меняться в зависимости от запроса, а новая система в целом этого больше не делает (блог от 24 августа 2021 года). Ahrefs проверил это иначе, сравнив частотные и редкие запросы, и разницы не нашёл. Один день и 2400 запросов не исключают, что у отдельных страниц заголовок всё-таки зависит от запроса.
Подстраивает ли Google заголовок под запрос по смыслу? Для пар, где он менял заголовок по существу, показанный вариант содержал больше слов запроса, чем тег, лишь в 6,7%, меньше в 24,1%, поровну в 69,2%. То есть замена обычно не приближает заголовок к запросу.
Ниши и агрегаторы
По нишам доля замен по существу от 30,3% (общепит) и 31,0% (IT-услуги) до 46,4% (финансы). У агрегаторов и маркетплейсов она выше: 46,6% против 34,5% у остальных сайтов. Моя догадка: у крупных площадок чаще динамические страницы с общим заголовком в статическом коде.
Пять приёмов Google: что именно он делает с заголовком
Пять приёмов объясняют почти все замены. Каждый показываю на реальной странице из выдачи.
Пять приёмов: что было в теге и что показал Google
Тег titleСтяжка пола за день от 750 рублей за м2 под ключ в Москве и Московской области
Показал GoogleСтяжка пола за день от 750 рублей за м2 под ключ в …
Тег titleУтеплители для наружных стен дома - Кнауф Пенопласт
Показал GoogleУтеплители для наружных стен дома
Тег titleБалконы
Показал GoogleОстекление балконов и лоджий под ключ
Тег titleНатяжные потолки в Саратове 🔥 от 200 руб.
Показал GoogleНатяжные потолки в Саратове от 200 руб.
Тег titleЛучшие портативные электростанции — рейтинг топа 2025
Показал GoogleЛучшие портативные электростанции в 2026 году
1. Обрезает по ширине
Самая частая операция (30,2% пар) — обрезка с многоточием. В поисковой выдаче Google на компьютере видимая часть обрезанных заголовков: медиана 49 знаков, у десятой части 42 и меньше, у десятой части 53 и больше. Ширина считается в пикселях, поэтому слова с широкими буквами съедают место быстрее.
Стяжка пола за день от 750 рублей за м2 под ключ в Москве и Московской области
Стяжка пола за день от 750 рублей за м2 под ключ в …
Стяжка пола – от 750 руб. за м2, стяжка за день.
Что реально теряется, показывает таблица ниже. Заголовки до 50 знаков обрезаются в 1,5% случаев, от 56 до 60 знаков уже в 37,6%, выше 60 знаков доля стабилизируется в пределах 37,6–39,8%. Остальные длинные заголовки Google сокращает иначе: отрезает хвост или заменяет.
| Длина title, знаков | Пар | Обрезан «…», % | Как есть или только название сайта, % |
|---|---|---|---|
| до 50 | 17 249 | 1,5 | 83,3 |
| 51–55 | 6 144 | 14,9 | 72,4 |
| 56–60 | 7 215 | 37,6 | 39,0 |
| 61–65 | 7 681 | 38,5 | 29,0 |
| 66–70 | 7 127 | 37,6 | 28,5 |
| 71–80 | 12 261 | 39,8 | 18,2 |
| 81–100 | 16 753 | 39,6 | 8,8 |
| больше 100 | 13 752 | 39,5 | 0,8 |
Доля случаев в зависимости от длины тега
- Обрезан с многоточием
- Как есть или только название сайта
Видимая часть обрезанного заголовка
26 757 заголовков с обрезкой
Обрезка ещё и теряет слова запроса: у 18,9% обрезанных заголовков в видимой части меньше слов запроса, чем в теге, и в среднем исчезает 36% этих слов. Ключевую фразу я бы держал в первых 40 знаках: у десятой части обрезанных заголовков видно не больше 42. Это мой совет.
2. Срезает название сайта и хвост
Название сайта Google убирает или добавляет в 16,5% пар. Чаще всего это короткий сегмент после разделителя в конце тега.
Утеплители для наружных стен дома - Кнауф Пенопласт
Утеплители для наружных стен дома
Разделитель влияет на судьбу хвоста. У заголовков до 60 знаков при вертикальной черте «|» Google меняет название сайта в 51,8% случаев, при тире или дефисе в 37,8%, без разделителя только в 6,8%. Среди всех заголовков с «|» (любой длины) в выдаче черта сохраняется лишь в 18,2% случаев, заменяется на тире в 6,7% и пропадает вместе с хвостом в 75,3% (часть этих случаев обрезка по ширине до разделителя). Это совпадает с наблюдением Zyppy (2022), что «|» Google убирает чаще, чем дефис или тире.
Как Google обходится с названием сайта и чертой «|»
Как часто Google меняет название сайта (теги до 60 знаков)
Что происходит с «|» в заголовке в выдаче
- Черта сохранена
- Заменена на тире: 6,7%
- Пропала вместе с хвостом
Иногда отрезается длинный хвост с описанием. Google прямо описывает этот приём: для очень длинного заголовка он может выбрать наиболее релевантную часть, а не обрезать конец. В моих примерах это первая смысловая часть до дефиса. Деталь счёта: класс «хвост отрезан» по построению ловит только случаи, когда в выдаче остаётся начало тега. Если бы Google выбирал середину, такая пара попала бы в другой класс.
Отзывы о газовых варочных панелях Korting - читайте отзывы владельцев и выбирайте лучшие газовые варочные поверхности Кортинг
Отзывы о газовых варочных панелях Korting
Юридическая помощь юридическим лицам в Тамбове - цены на услуги в Тамбовской региональной коллегии адвокатов
Юридическая помощь юридическим лицам в Тамбове
Что отрезается чаще всего? Среди 21 203 отброшенных хвостов лидируют названия площадок и рубрик: «Википедия» встречается в отброшенных хвостах в 1,6% случаев при 0,4% во всех тегах (в 4 раза чаще), «блог» в 2,3% при 1,3%, «Zoon» в 0,8% при 0,3%. Коммерческие слова («купить», «цена», «доставка», «отзывы» и подобные) есть в 30,4% отброшенных хвостов и в 40,2% всех тегов, то есть в хвостах реже среднего. Два слова встречаются в хвостах чуть чаще: «отзывами» (1,1% при 0,6%) и «ценами» (1,0% при 0,7%). Специально коммерческие слова Google не вырезает.
- «википедия» Во всех тегах 0,4% · В отброшенных хвостах 1,6%
- «блог» Во всех тегах 1,3% · В отброшенных хвостах 2,3%
- «отзывами» Во всех тегах 0,6% · В отброшенных хвостах 1,1%
- «Zoon» Во всех тегах 0,3% · В отброшенных хвостах 0,8%
- «смотреть» Во всех тегах 0,4% · В отброшенных хвостах 0,8%
- «портал» Во всех тегах 0,4% · В отброшенных хвостах 0,8%
- «лемана» Во всех тегах 0,5% · В отброшенных хвостах 0,9%
- «дзен» Во всех тегах 0,6% · В отброшенных хвостах 1,0%
- «видео» Во всех тегах 0,8% · В отброшенных хвостах 1,2%
- «ценами» Во всех тегах 0,7% · В отброшенных хвостах 1,0%
3. Берёт H1 вместо тега
В 13,0% пар Google заменяет тег на H1. Именно так произошло в примере из начала статьи. Чаще всего это случается с длинными тегами: 58,3% подмен приходится на теги длиннее 70 знаков.
Балконы
Остекление балконов и лоджий под ключ
Остекление балконов и лоджий под ключ
Поступи в ДВФУ
Дизайн - Подать документы - ДВФУ
Дизайн
Иногда Google берёт заголовок вообще не из тега и не из H1. Таких пар 3,1%, и они не объясняются сохранёнными полями (якоря, og:title, прочий текст страницы, о чём Google пишет в документации).
Онлайн-школа Фоксфорд
Курсы программирования для детей: обучение с нуля
Школа программирования для детей
4. Убирает эмодзи и переставляет слоган
Эмодзи в теге Google убирает почти всегда: в выдаче значок остаётся лишь у 19,7% заголовков, где он был в теге. Попутно он может переставить части.
Натяжные потолки в Саратове 🔥 от 200 руб.
Натяжные потолки в Саратове от 200 руб.
Доставка пиццы в Новосибирске 🍕 - Сыр, томат и аромат
Сыр, томат и аромат: Доставка пиццы в Новосибирске
Вкусная и горячая пицца
5. Обновляет год
Google прямо пишет, что исправляет устаревший год в теге, если в видимом заголовке год новее. В моих данных таких страниц 80 (год в теге меньше года в H1): в 10 случаях Google показал год из H1, в 40 оставил год из тега, в остальных 30 года в заголовке нет или он другой.
Лучшие портативные электростанции — рейтинг топа 2025
Лучшие портативные электростанции в 2026 году
Лучшие портативные электростанции в 2026 году
Рейтинг лучших роботов-пылесосов в 2025 году
Рейтинг лучших роботов-пылесосов в 2025 году
22 лучших робота-пылесоса в 2026 году
Какие заголовки Google трогает чаще
Чаще всего Google переписывает длинные title, title с эмодзи, с перечнем ключей, с шаблонным повтором и те, что расходятся с H1. Связи доли замен с позицией в выдаче не видно.
Проверка случаев из документации Google
Для каждого официального случая я придумал измеримый признак и посмотрел, как часто при нём заголовок изменён по существу. OR (отношение шансов) сравнивает шансы замены у страниц с признаком и без него, одновременно учитывая остальные признаки. OR = 1 означает одинаковые шансы; значение выше 1 — шансы выше у страниц с признаком, ниже 1 — ниже. OR нельзя читать как отношение процентов, поэтому рядом с ним я показываю доли замен.
| Мой признак | Случай из документации | Заменён: с признаком / без | Страниц с признаком | Отношение шансов |
|---|---|---|---|---|
| Половина пустая или короче 10 знаков | половина пустая | 51,8% / 36,3% | 328 | 3,7 |
| Устаревший год в теге | устаревший | 28,7% / 36,3% | 80 | 0,57 (0,20–1,61) |
| Три и больше запятых или повтор слова в теге | неточный (перечень ключей) | 52,7% / 32,8% | 15 566 | 1,36 |
| Один и тот же тег у трёх и больше URL домена | повторяющийся шаблон | 76,5% / 36,0% | 784 | 11,5 (4,1–31,7) |
| Несколько разных H1 | нет главного заголовка | 28,9% / 36,5% | 2 542 | 0,69 |
| Тег и текст страницы в разных алфавитах | несовпадение письменности | 62,0% / 36,1% | 787 | 2,13 |
| Название сайта в теге | повтор названия сайта | 38,9% / 35,8% | 14 608 | 1,02 (по существу эффекта нет) |
- Один тег у 3+ URL домена Без признака 36,0% · С признаком 76,5% · 784 стр.
- Тег и текст в разных алфавитах Без признака 36,1% · С признаком 62,0% · 787 стр.
- Половина тега пустая или короче 10 знаков Без признака 36,3% · С признаком 51,8% · 328 стр.
- Три и больше запятых или повтор слова Без признака 32,8% · С признаком 52,7% · 15 566 стр.
- Название сайта в теге Без признака 35,8% · С признаком 38,9% · 14 608 стр.
- Несколько разных H1 Без признака 36,5% · С признаком 28,9% · 2 542 стр.
- Устаревший год в теге Без признака 36,3% · С признаком 28,7% · 80 стр.
В четырёх случаях связь в данных совпала с направлением из документации: неполный title, перечень ключей, повторяющийся шаблон и несовпадение письменности связаны с большей долей замен. Для названия сайта заметной разницы в содержательных заменах нет, хотя Google часто меняет само название. Несколько H1 связаны с меньшей долей замен — это обратный результат. По устаревшему году 80 страниц. Страницы с одним тегом на трёх и более URL домена (784) принадлежат 44 доменам и 49 уникальным заголовкам: это крупные порталы и сервисы (Авито, Т-Банк, Google, Яндекс, Госуслуги, 2ГИС, Инвитро), где один заголовок стоит на всех страницах раздела. Величину эффекта (11,5, интервал 4,1–31,7) не стоит читать как «шаблонные теги Google заменяет в 11 раз чаще». Направление согласуется с документацией.
Что нашлось сверх документации
| Признак | Заменён: с признаком / без | Страниц | Отношение шансов |
|---|---|---|---|
| Title длиннее 70 знаков | 51,4% / 22,0% | 43 244 | 3,1 |
| Эмодзи в теге | 66,1% / 35,2% | 3 125 | 3,3 (2,0–5,2) |
| Цена в теге (число и «₽» или «руб.») | 48,6% / 35,8% | 3 706 | 1,6 |
| Год в теге | 47,7% / 35,2% | 8 107 | 1,4 |
| Три и больше частей через разделители | 49,4% / 34,5% | 10 633 | 1,25 |
- Эмодзи в теге Без признака 35,2% · С признаком 66,1%
- Title длиннее 70 знаков Без признака 22,0% · С признаком 51,4%
- Перечень ключей (3+ запятых или повтор слова) Без признака 32,8% · С признаком 52,7%
- 3+ части через разделители Без признака 34,5% · С признаком 49,4%
- Цена в теге Без признака 35,8% · С признаком 48,6%
- Год в теге Без признака 35,2% · С признаком 47,7%
Длина — самый распространённый признак: 48,8% тегов длиннее 70 знаков. В модели, которая одновременно учитывает длину и другие характеристики, эмодзи связаны с более высокими шансами содержательной замены (OR 3,3). Это связь, а не доказанная причина: эмодзи часто стоят в перегруженных тегах вроде «✅ Бесплатная доставка ✅». Проверка метода: в 7,5% тегов с эмодзи Google убрал только значок, такие пары у меня считаются неизменёнными. Название сайта в теге почти не меняет вероятность замены по существу (38,9% против 35,8%, отношение шансов 1,02), но название Google убирает или добавляет сам: в 20,8% пар с названием сайта в теге и в 15,6% без него, а у заголовков до 60 знаков 40,4% против 18,7%.
Символы в теге: что Google оставляет, а что убирает
Возьмём два тега с одним значком в каждом. У Agent.ru стоит ✈, и Google показал заголовок целиком: значок остался. У Five-Sport значок 🏃 пропал, а вместе с ним слово «купить» и название сайта: Google подставил H1.
Дешевые авиабилеты найти и купить онлайн | ✈ Agent.ru
Дешевые авиабилеты найти и купить онлайн | ✈ Agent.ru
Женские кроссовки для бега купить 🏃 Five-Sport.ru
Женские кроссовки для бега
Женские кроссовки для бега
Чтобы проверить, как это устроено в целом, я взял 15 групп символов: от запятой и вертикальной черты до эмодзи и знака процента. Для каждой группы считал две вещи. Первая: как часто символ остаётся в показанном заголовке. Вторая: как часто заголовок изменён по существу.
Здесь есть ловушка. Запятые, двоеточия и разделители чаще встречаются в длинных тегах, а длинные теги Google заменяет чаще при любых символах. Если сравнить все теги подряд, заголовок с запятой заменён по существу в 46,4% случаев. Но на тегах до 60 знаков с запятой заменено 17,1%, без запятой 16,5%. Поэтому дальше сравнение идёт на коротких тегах плюс регрессия с поправкой на длину (восемь полос длины) и с группировкой по сайту: так один шаблонный сайт не выдаёт себя за закономерность.
Чаще всего Google сохраняет знак вопроса (80,0% тегов, где он стоит), плюс (62,0%) и цифры (60,1%). Реже всего остаются эмодзи (13,1%) и вертикальная черта (13,1%). У черты причина понятна: она стоит перед названием сайта, и Google срезает хвост целиком. Среди 13 763 тегов с « | » без обрезки по ширине черта осталась в 12,9%, превратилась в тире в 16,3%, а разделителя не осталось вовсе в 70,8%.
На тегах до 60 знаков почти все символы ничего не меняют: заменён по существу примерно каждый шестой заголовок (от 6,9% до 21,7% в разных группах, при этом у большинства символов доля лежит рядом с 16,5%), с символом или без. Вертикальная черта, двоеточие, запятая и кавычки дают шансы около единицы: 0,97, 1,01, 1,02 и 0,93. Знак вопроса (0,63; интервал 0,55–0,72) и дефис с пробелами (0,80; 0,71–0,91) связаны с меньшей долей замен. Цифры (1,20) и рубль (1,33; 1,08–1,63) связаны с чуть большей. Возможно, вопрос и число несут смысл заголовка, и Google не видит причин их трогать. Это моя догадка.
- Эмодзи Без символа 16,3% · С символом 31,9% · 609 тегов
- Слэш Без символа 16,5% · С символом 21,7% · 300 тегов
- Цифры Без символа 16,4% · С символом 17,4% · 5 870 тегов
- Кавычки Без символа 16,6% · С символом 17,3% · 1 434 тегов
- Запятая Без символа 16,5% · С символом 17,1% · 2 924 тегов
- Круглые скобки Без символа 16,6% · С символом 17,0% · 653 тегов
- Двоеточие Без символа 16,5% · С символом 16,9% · 4 573 тегов
- Рубль (₽, руб.) Без символа 16,6% · С символом 16,9% · 821 тегов
- Вертикальная черта | Без символа 16,8% · С символом 15,4% · 4 495 тегов
- Длинное тире – — Без символа 16,9% · С символом 15,0% · 4 428 тегов
- Вопросительный знак Без символа 16,8% · С символом 11,8% · 1 463 тегов
- Восклицательный знак Без символа 16,7% · С символом 10,2% · 344 тегов
- Дефис с пробелами « - » Без символа 17,5% · С символом 10,9% · 4 129 тегов
- Процент Без символа 16,6% · С символом 8,6% · 93 тегов
- Плюс Без символа 16,7% · С символом 6,9% · 231 тегов
Единственный символ с сильной связью — эмодзи. На коротких тегах заменено 31,9% против 16,3%, а шансы замены с поправкой на длину и сайт выше в 3,2 раза (интервал 2,1–5,0). Я проверил, не прячется ли за этим несколько шаблонных сайтов. Значки встречаются в 3 125 парах на 583 сайтах. У 273 сайтов есть и теги с эмодзи, и теги без них: в среднем по этим сайтам с эмодзи заменено 64,0%, без эмодзи 41,2%, и у 151 из 273 сайтов доля с эмодзи выше. У остальных 122 она такая же или ниже, поэтому связь есть, но не у каждого сайта.
Положение значка тоже различается. В начале тега заменено 86,1% (294 пары, 113 сайтов), в середине 65,5% (2 599 пар, 413 сайтов), в конце 38,9% (157 пар, 58 сайтов). Отдельные значки расходятся сильнее: у 🔥 заменено 95,5% (17 сайтов), у 🏆 99,0% (29 сайтов), у ✈ 12,3% (19 сайтов), у ❤ 20,9% (15 сайтов). За каждым значком стоит от 8 до 50 сайтов, так что проценты по значкам отражают привычки нескольких шаблонов, а не правило для самого значка.
Где в теге стоит значок
Отдельные значки (в выборку вошли значки с 60 и больше парами и 8 и больше сайтами)
Это связь, а не причина. Значок в начале и в середине тега чаще сопровождается заменой всего заголовка, поэтому первым на удаление я бы поставил его. Число и знак вопроса Google чаще оставляет.
Длина title и частота содержательных замен
Для каждой длины: доля пар, где заголовок остался как есть или изменилось только название сайта (тёмно-зелёная часть); обрезан по ширине (серая); изменён по существу (терракотовая).
Минимум замен по существу приходится на 41–50 знаков (12,4%). До 30 знаков доля замен снова растёт (20,7%), и половина этих замен (52%) приходится на заголовок из других источников. В модели с контролем остальных признаков «короче 30 знаков» эффекта не даёт (OR 0,82; интервал 0,62–1,10); значим только очень короткий тег, до 10 знаков, или тег, который начинается с разделителя (328 страниц). После 55 знаков растёт и доля обрезки, и доля замен: при 56–60 знаках по существу меняется 23,4%, а ещё 37,6% обрезается.
Как совпадение title и H1 связано с заменой
Среди 82 669 страниц с H1 у 8,6% title равен H1 дословно, у 42,2% содержит H1 целиком, у 48,7% не содержит (ещё у 0,5% H1 содержит title). Доля замен по существу при этом различается сильно:
| Связь title и H1 | до 55 / 56–70 / больше 70 знаков | Страниц |
|---|---|---|
| Title равен H1 дословно | 1,9% / 3,5% / 13,3% | 7 142 |
| Title содержит H1 целиком (но длиннее) | 8,2% / 22,1% / 48,1% | 34 905 |
| Title не содержит H1 целиком | 22,4% / 39,2% / 58,6% | 40 222 |
- Title равен H1
- Title содержит H1
- Title не содержит H1
до 55 знаков
56–70 знаков
больше 70 знаков
Ещё у 400 страниц H1 содержит title (title короче H1), в таблицу они не вошли.
Разница сохраняется и при сравнении заголовков одинаковой длины: среди title до 55 знаков содержательная замена была у 1,9% страниц, где title равен H1, и у 22,4% страниц, где title не содержит H1 целиком. Модель учитывает одновременно длину, эмодзи, перечень ключей и повторяющийся шаблон. В ней OR для совпадения title и H1 равен 0,09 (95%-й интервал 0,07–0,12), а для title, содержащего H1, — 0,55 (0,50–0,61).
Моё объяснение такое: Google берёт заголовок из нескольких источников, и когда они совпадают по смыслу, системе проще выбрать один вариант. В документации Google такого объяснения нет. Zyppy (2022) тоже отмечает связь совпадения title и H1 с меньшей долей замен в своём исследовании.
Как писать title: правила по данным
Правила ниже я вывел из тех же данных: у страниц, которые им следуют, Google реже переписывает заголовок. Позиции и клики я не мерил, так что речь только о том, что человек увидит в выдаче.
Главный официальный совет не меняется: сначала нужен хороший HTML-тег title, потому что именно его Google использует чаще всего. Дальше то, что подсказывают данные.
Как выглядит title, который Google чаще оставляет (длина в знаках)
- до 50 знаков: обрезка 1,5%
- 51–55: 14,9%
- 56–60: 37,6%
- 61–70: 37,6–38,5%
Семь правил
Семь правил: как часто Google меняет заголовок по существу
Соблюдают 26,4% страниц
Соблюдают 96,5% страниц
Соблюдают 82,4% страниц
Соблюдают 99,1% страниц
Соблюдают 88,0% страниц
Соблюдают 99,1% страниц
Соблюдают 99,6% страниц
Все семь правил соблюдает 23,5% страниц (20 872 из 88 660).
| № | Правило | Что в данных |
|---|---|---|
| 1 | До 55 знаков; ключевую фразу в начало (мой совет) | Соблюдают 26,4% страниц. Среди них по существу меняется 14,5%, не меняется 85,5% |
| 2 | Никаких эмодзи | Соблюдают 96,5%. Эмодзи: 66,1% замен против 35,2% |
| 3 | Без перечня ключей: не больше двух запятых, слова не повторяются | Соблюдают 82,4%. С перечнем 52,7% замен против 32,8% |
| 4 | Свой title на каждой странице, без общего шаблона | Соблюдают 99,1%. Шаблонные теги Google заменял в 76,5% случаев (784 страницы, 44 домена) |
| 5 | Не больше двух частей через разделители | Соблюдают 88,0%. С тремя и больше 49,4% замен против 34,5% |
| 6 | Тот же язык и алфавит, что у текста страницы | Соблюдают 99,1%. Расхождение: 62,0% замен против 36,1% |
| 7 | Не короче 10 знаков и не начинается с разделителя | Соблюдают 99,6%. Нарушение: 51,8% замен против 36,3% |
Эти правила я не записывал до расчёта, а вывел из регрессии на тех же данных, так что общий эффект может быть завышен. Зато направление каждого правила совпадает с документацией Google или с чужими замерами (Zyppy, Ahrefs). Все семь соблюдает 23,5% страниц (20 872 из 88 660). Для них по существу меняется 11,7% заголовков, а 88,3% остаются прежними, обрезанными или с правкой только названия сайта. У остальных страниц эти доли 43,9% и 56,1%. Чем больше нарушений, тем выше доля замен:
Доля заголовков, изменённых по существу, по числу нарушенных правил из семи. На 4–5 нарушениях всего 122 страницы.
Самое заметное различие в результатах связано с длиной title: правило до 55 знаков соблюдают 26,4% страниц; среди них 85,5% заголовков не менялись по существу. Если не знаете, с чего начать, начните с длины. Но это совет по связи в данных: что сокращение само даст такой результат, я не доказывал.
Название и H1 пишите как один смысл
Сильнее всего с меньшей долей замен связана ситуация, когда title совпадает с H1. Совпадение не обязательно должно быть дословным: если title включает H1 и содержит к нему уточнение, замена была у 34,0% страниц против 44,9% у title без полного H1 (OR 0,55 — шансы примерно вдвое ниже). При дословном совпадении доля составила 4,3% против 44,9% (OR 0,09 — примерно в 11 раз ниже). Если H1 длинный и вы выбираете более короткую формулировку для title, сохраните основную фразу из начала H1 в начале title.
Название сайта: коротко и в конце
Google рекомендует ставить название сайта в начало или в конец через разделитель. Данные добавляют две детали. Во-первых, Google убирает или добавляет название сайта чаще при «|», чем при тире или дефисе (у заголовков до 60 знаков 51,8% против 37,8%). Но даже при тире или дефисе название менялось примерно в каждом третьем случае — гарантии сохранения нет. Во-вторых, на замену по существу название сайта в теге почти не влияет (OR 1,02), но само название Google убирает или добавляет часто: у заголовков до 60 знаков с названием в теге в 40,4% случаев. Не рассчитывайте, что бренд в конце тега непременно доедет до выдачи.
Числа, годы, цены
- Число в title и в H1. Если число есть в теге, но нет в H1, в показанном заголовке числа нет у 58,4% страниц (14 870 пар). Если число есть и в теге, и в H1, числа нет у 12,2% (10 443). Часть исчезновений — обрезка по ширине, поэтому ставьте число в начало.
- Год. Год в теге связан с большей долей замен: 47,7% против 35,2%. Если год вам нужен, обновляйте его и в теге, и в H1 одновременно: Google описывает случай, когда берёт год из заголовка, но в моих данных он делал это лишь в 10 случаях из 80.
- Цена. Наличие цены в теге связано с большей долей замен (48,6% против 35,8%; OR 1,6). Для авиабилетов Google пишет, что, скорее всего, не покажет цену.
Число из тега доезжает до выдачи, если оно есть и в H1: доля пар, где числа в показанном заголовке нет
Заголовки по типам страниц
Ниже реальные заголовки, которые Google показал без единого изменения при title, равном H1. Они иллюстрируют схемы, которые проходят: короткие, один смысл, без хвостов. Копировать их дословно не нужно.
| Тип страницы | Заголовок (title равен H1) | Схема |
|---|---|---|
| Категория интернет-магазина | «Кроссовки для бега по асфальту мужские» five-sport.ru/collection/muzhskie-krossovki-dlya-bega/dlya-asfalta · позиция 9 | товар + главное уточнение; без «купить» и без названия магазина |
| Каталог или подборка | «Таунхаусы до 5 млн. руб. в Подмосковье» townhouse.ru/ot-3-do-5-mln-rublej · позиция 10 | что + критерий + место; число и география в первых 40 знаках |
| Страница-документ или услуга | «Дополнительное соглашение к договору поставки» documentoved.ru/documents/contracts/dogovor_postavki/dopolnitelnoe-soglashenie-dogovor-postavki · позиция 1 | название объекта без добавок |
| Статья-вопрос | «Почему холодильник работает, но не охлаждает?» high-level.ru/blog/articles/pochemu-kholodilnik-rabotaet-no-ne-okhlazhdaet.html · позиция 8 | вопрос читателя дословно, знак вопроса не мешает |
| Список или подборка по месту | «Салоны красоты в центре Москвы» kudago.com/msk/list/salony-krasoty-v-centre-moskvy · позиция 5 | что + где |
Как переписать плохой title
Возьмём реальный заголовок из выдачи и посмотрим, что с ним сделал Google.
Купить септик для туалета под ключ по низким ценам ✅ Бесплатная доставка ✅ Установка под ключ за 1 день
Купить септик для туалета под ключ по низким ценам …
Септики для туалета
Чего ждать от правил
- Они не гарантируют, что Google оставит ваш title: даже при нуле нарушений по существу меняется 11,7%.
- Влияние на CTR смотрите на своём сайте в Search Console, сравнивая CTR страниц до и после правки (так советует и Ahrefs): клики и показы в замер не входят.
Как проверить свои страницы
Проверка состоит из нескольких шагов: выгрузить title и H1, проверить семь признаков, сравнить title с заголовком в выдаче по главным запросам и затем отслеживать CTR.
- 01 / ВЫГРУЗИТЬTitle и H1Собрать для страниц сайта и отметить нарушения семи правил.
- 02 / СВЕРИТЬЗаголовок в выдачеСравнить с тегом и отделить подмену от обрезки и названия сайта.
- 03 / ВЫБРАТЬСтраницы вышеНачать с них, если нужно расставить приоритет.Мой совет
- 04 / ДОЖДАТЬСЯПовторного обходаОт нескольких дней до нескольких недель.По документации Google
- 05 / ИЗМЕРИТЬCTR в Search ConsoleСравнить те же запросы до и после правки.Проверка на своём сайте
- Выгрузите title и H1 всех страниц краулером. Отметьте страницы, где тег длиннее 55 знаков, не совпадает с H1 по смыслу, содержит эмодзи, три и больше запятых или повторяющиеся слова, или одинаков у трёх и больше URL.
- Сверьте с выдачей. По одному-двум главным запросам страницы посмотрите, какой заголовок показывает Google, и сравните с тегом. В Ahrefs Site Audit есть готовый фильтр «Page and SERP titles do not match (страница и заголовок в результатах поиска не совпадают)»; в расширенном фильтре можно исключить мелкие различия: обрезку и добавление названия сайта.
- Сначала правьте страницы, которые стоят выше. Это мой совет: у страницы на третьем месте заголовок видят чаще, чем у страницы на сороковом.
- Дождитесь переобхода. По документации Google, нужно от нескольких дней до нескольких недель. Можно запросить повторный обход в Search Console.
- Смотрите CTR до и после в Search Console по тем же запросам. Так вы увидите, изменился ли CTR после правки. Сравнение «до и после» само по себе не доказывает, что изменение вызвала именно правка: на показатель также влияют сезонность, позиции и другие изменения на сайте.
Методика описана в конце статьи, по ней подсчёт можно воспроизвести.
Что показала перезагрузка в браузере
Страницы, которые не отдали title обычным запросом, и страницы с «не объяснёнными» заголовками я открыл в Chromium. После выполнения скриптов источник нашёлся у 39,1% таких заголовков, а в анализ вернулись 2 689 пар. Связь замены с позицией осталась прежней: 50,1 из 100.
Что вошло в анализ
| Этап | Строк | От всех строк |
|---|---|---|
| Строк выдачи Google | 107 103 | 100,0% |
| Для страницы есть запись (HTML получен) | 104 987 | 98,0% |
| У страницы есть тег title | 99 641 | 93,0% |
| Ответ 200, заголовок не из страницы защиты | 94 104 | 87,9% |
| Без YouTube (в анализе) | 88 660 | 82,8% |
- 5 346 страниц без тега title. У 97,5% из них в HTML нет и H1: заголовки появляются после выполнения JavaScript. Среди них крупные сайты: Reddit (592), Domclick (448), ВсеИнструменты (189), VK (317 строк у vkvideo.ru и vk.ru), Эльдорадо (122). Обычный HTTP-запрос не находит тег у 5,9% страниц, браузер у 0,5%.
- 2 649 страниц закрыты от обычного запроса. Ответы 403 (1 419), 429 (254), 503 (219), 404 (191), 401 (185). Чаще всего это Яндекс (511), Zoon (204), Wildberries (166), Спортмастер (164), Ozon (122), Аэрофлот (60).
- 2 116 строк (2,0%) без загруженного HTML.
- 5 449 строк YouTube исключены: Google показывает оригинальное название видео, а загрузка получила автоперевод.
- Страницы защиты от ботов с заголовками «Проверка безопасности», «Выключите VPN» и подобными вычищены по списку.
Откуда взялся заголовок, который не объяснялся полями
В Chromium открыто 10 383 страницы. Для каждой сохранены title, og:title, twitter:title, H1–H3, атрибут lang, названия из разметки WebSite и Organization, якорные тексты ссылок на саму страницу, самый крупный видимый текст (по вычисленному font-size) и начало текста. Заголовок Google сверяется с этими полями в порядке таблицы: пара относится к первому совпавшему источнику.
| Источник заголовка | Пар | Доля из 2 791 |
|---|---|---|
| og:title | 260 | 9,3% |
| Название сайта из разметки WebSite | 62 | 2,2% |
| Якорный текст ссылки на страницу | 167 | 6,0% |
| Тег title после выполнения скриптов | 131 | 4,7% |
| H1–H3 после выполнения скриптов | 176 | 6,3% |
| Самый крупный текст страницы | 130 | 4,7% |
| Другой текст страницы | 166 | 5,9% |
| Источник найден | 1 092 | 39,1% |
Откуда Google взял заголовок, которого не было в сохранённых полях
Что нашлось среди 2 791 пары (шкала до 12%)
Из 2 791 пары источник нашёлся для 1 092 (39,1%). Чаще других совпадает og:title: 9,3% пар. Якорный текст ссылки совпал в 6,0% пар, самый крупный текст страницы, о котором пишет Google, в 4,7%. Без источника осталось 1 699 пар: 1,9% всех пар вместо прежних 3,1%.
Страницы, вернувшиеся в выборку
Страницы без тега title и закрытые от обычного запроса чаще стоят в топе: без тега 7,2% строк на позициях 1–3 и 4,6% на позициях 31–50, закрыто 7,7% против 4,5%. Наверху больше крупных динамических площадок и агрегаторов. После выполнения скриптов в анализ вернулись 2 689 пар с 1 908 страниц. Заголовок Google меняет у них по существу чаще: в 44,4% случаев против 36,3% в основной выборке. Среди вернувшихся пар 33,2% обрезаны по ширине, 16,2% укорочены, 14,5% не объяснены, у 14,1% изменено название сайта.
| Полоса | Пар в анализе | Доля строк выдачи в анализе | Доля замен по существу | Границы, если остальные строки все без замен или все с заменой |
|---|---|---|---|---|
| 1–3 | 6 409 | 89,2% | 35,1% | 31–42% |
| 4–10 | 14 904 | 90,5% | 37,4% | 34–43% |
| 11–20 | 20 426 | 90,2% | 36,8% | 33–43% |
| 21–30 | 20 093 | 89,9% | 36,3% | 33–43% |
| 31–50 | 29 517 | 89,4% | 36,5% | 33–43% |
Вместе с вернувшимися страницами в анализе 91 349 пар (85,3% строк выдачи), доля замен по существу 36,6%. Сравнение топ-20 с позициями 21–50 внутри запроса даёт 50,1 из 100 (95%-й доверительный интервал — 49,8–50,4; 2369 запросов), в основной выборке 50,2. Если все строки, не вошедшие в анализ, не менялись вовсе или менялись все, доля по любой полосе остаётся между 31% и 43%.
Как это считалось
Здесь определения классов, фильтры, модели и ограничения. Раскройте блок, чтобы проверить, как получены числа.
Показать методику: данные, классы, фильтры, модели, проверки
Данные
Выдача. Google через XMLRiver: Москва, google.ru, поиск с компьютера, до 50 позиций, 5 страниц по 10 результатов, 2 октября 2026. 2400 запросов в 16 нишах (те же, что в исследовании про триплеты); 107 103 строки, 65 846 уникальных URL. Заголовок берётся из поля title ответа (его отдаёт сервис; обрезка многоточием приходит уже в ответе).
Страницы. Тексты скачаны обычным HTTP-запросом, для закрытых страниц браузером (CloakBrowser, 9 866 страниц). Из HTML сохранены title, description, h1, h2, h3, основной текст. Связь по нормализованному адресу (без www, без завершающего слэша): 104 987 из 107 103 строк.
Перезагрузка в браузере. Chromium (Playwright), 10 383 страницы: те, что не отдали title обычным запросом или закрыты от него, и страницы пар «не объяснено». Сохранены title, og:title, twitter:title, H1–H3, lang, названия из разметки WebSite и Organization (JSON-LD), якорные тексты ссылок на саму страницу, пять самых крупных видимых текстов с размером шрифта и первые 15 000 знаков текста. Заголовок Google считается найденным, если он равен полю после нормализации, входит в поле или содержит его (от 8 знаков) либо сходство по difflib не ниже 0,85. Перезагруженные пары классифицируются теми же правилами, что и основная выборка.
Классы соответствия
Перед сравнением я нормализую строки, то есть привожу их к одному виду: перевожу в нижний регистр, заменяю «ё» на «е», убираю кавычки, меняю длинные тире на дефис и схлопываю пробелы. Сходство строк считается как доля совпавших символов (функция difflib из стандартной библиотеки Python). Порядок проверки:
- Совпал: заголовки равны после нормализации; при сходстве не ниже 0,92 (difflib) — «совпал, отличаются знаки».
- Обрезан: заголовок оканчивается на «…» или «...», а его основная часть является началом тега (или тега без первого или последнего сегмента).
- Название сайта: заголовок равен тегу после отбрасывания одного-двух крайних сегментов (разделители: « - », «|», «: », «·», «»», « / »), и каждый отброшенный сегмент не длиннее пяти слов.
- Частично: один содержится в другом; если короткий не меньше 60% длинного — «partial», иначе «укорочен» (если в выдаче короче) или «дополнен».
- Переставлен: не меньше 90% слов одного набора входят в другой.
- H1: заголовок равен H1, содержит его или сходство не ниже 0,85.
- H2/H3: совпадает с одним из подзаголовков (длиной больше пяти знаков).
- Прочее: всё остальное.
К классу «изменён по существу» я отношу partial (частичное совпадение), укороченный или дополненный заголовок, перестановку слов, подстановку H1 или H2/H3 и прочие изменения. «Любое отличие, кроме обрезки» включает все случаи, кроме полного совпадения и обрезки. Правила я проверил чтением по 10 случайных примеров каждого класса, а затем независимой разметкой (ниже).
Проверка классов независимым разметчиком
Чтобы измерить точность классов, я взял 300 пар (по 30 из каждого из десяти классов), скрыл свои метки и отдал пары языковой модели Codex с тремя исходами: «как есть или обрезан», «только название сайта», «по существу». Определения я написал сам, к ним добавил одно правило: смотреть только на пару, причины не гадать. Ответ совпал с моим исходом в 75,3% пар (каппа Коэна 0,57: умеренное согласие, каппа вычитает совпадения по случайности). В пересчёте на реальные доли классов в данных совпадение 84,3%.
Расхождения лежат почти целиком на границе между названием сайта и смысловой частью. В моём классе «по существу» оказалось 25 пар, где разметчик увидел срезанное название сайта: хвосты вроде «— Институт русского языка им. А.С. Пушкина», «РБК Спорт», «КонсультантПлюс». В обратную сторону 10 пар из моего класса «название сайта» он отнёс к «по существу»: там срезан не бренд, а смысловой хвост, например «заказать разработку».
Я пересчитал данные при более широком правиле: названием сайта считается любой срезанный первый или последний сегмент после разделителя, какой бы длины он ни был. Доля содержательных замен тогда падает с 36,3% до 31,4%, а доля «только название сайта» растёт с 16,5% до 21,4%. Содержательные замены поэтому лучше читать как диапазон 31–36%. Выводы статьи от выбора границы не меняются: связь с позицией по-прежнему нулевая (50,1 из 100, интервал 49,8–50,4), эмодзи дают 60,4% против 30,4%, теги длиннее 70 знаков 42,4% против 21,0%, а от 11,4% при нуле нарушений правил доля замен растёт до 77,0% при четырёх и пяти.
Фильтры
Оставлены пары, где страница ответила кодом HTTP 200 (успешный ответ сервера; также включены страницы, полученные через браузер), title непуст, это не YouTube и не страница защиты. Страницей защиты считается заголовок, найденный по списку (403 — доступ запрещён; 404 — страница не найдена; 5xx — ошибка сервера; «forbidden», «access denied», «just a moment», captcha (проверка пользователя), «проверка безопасности», «выключите VPN», «killbot», «упс», «идёт проверка», «авторизация», «вход» и подобные), либо H1 с такими словами. Фильтр дорабатывался: после доработки оценка эффекта «шаблона» составила OR 11,5 (в первой версии около 32; история фильтра в файле результатов).
Модели
Связь с позицией. Для каждого запроса я рассчитал AUC — показатель того, насколько хорошо факт замены помогает отличить страницы из топ-20 от страниц на позициях 21–50 (минимум по четыре страницы в каждой группе). AUC = 0,5 соответствует случайному угадыванию. Значения усреднил по 2369 запросам; результат — 0,502, или 50,2 из 100 (95%-й интервал 49,8–50,5, рассчитанный по нормальному приближению).
Признаки. Логистическая регрессия одновременно оценивает связь 15 признаков с шансами содержательной замены. В модель вошли признаки из таблиц 5 и 6, наличие H1 и две категории длины title: больше 60 и меньше 30 знаков. Расчёт статистической неопределённости учитывает, что страницы одного домена могут быть похожи (всего 88 660 пар «страница — заголовок»). У признака «нет H1» отношение шансов 0,77 (0,61–0,97). Общий итог по правилам (таблица 8, рис. по нарушениям) — доли, без модели.
Зависимость от запроса. Для страниц, показанных по двум и более запросам, сравниваются основные части заголовков в выдаче; «разные» — если ни одна не является началом другой.
Слова запроса. Для сопоставления слов запроса и заголовка я беру первые пять букв каждого слова и сравниваю полученные основы.
Рамки замера
- Один день наблюдений, поиск с компьютера, Москва, один сервис выдачи.
- Классы определены правилами; независимая разметка 300 пар дала совпадение 75,3% (каппа Коэна 0,57).
- Признаки правил выведены из регрессии на тех же данных.
- Данные наблюдательные: клики и позиции после правки title в замер не входят.
Источники и дата прочтения
Официальные: Google Search Central, Influencing Title Links, блог Google от 24.08.2021 и блог Google от 17.09.2021. Сравнение: Ahrefs, 6 Important Insights About Title Tags (16 ноября 2021, 953 276 страниц из топ-10) и Zyppy, Google Rewrites 61% of Page Title Tags (опубликовано 12 июля 2022, обновлено 6 октября 2026; 80 959 тегов). Все пять страниц прочитаны 14 октября 2026.
Данные и код. Данные и скрипты расчёта лежат в рабочем каталоге исследования.
Частые вопросы
Google формирует заголовок результата из нескольких источников. Чаще всего он использует текст title, но может взять главный заголовок страницы (H1), тег og:title, заметный текст или текст ссылок на страницу. Если title пустой, одинаковый на многих страницах, плохо описывает содержимое или не совпадает с языком страницы, Google может выбрать другой источник. В замере на 88 660 парах заголовок сохранился или был только обрезан в 47,2% случаев; в 16,5% изменилось только название сайта, а в 36,3% — сам текст заголовка.
На компьютере Google обрезает заголовки по ширине в пикселях, а не по фиксированному числу знаков. У половины обрезанных заголовков видимая часть была не длиннее 49 знаков; в 80% случаев она составляла от 42 до 53 знаков. Обрезка встречалась у title до 50 знаков в 1,5% случаев, при длине 51–55 знаков — в 14,9%, при 56–60 — в 37,6%. Ключевую фразу я бы ставил в первые 40 знаков — это мой совет, порога из данных тут нет. Правило из статьи — до 55 знаков.
В моём замере, когда title и H1 совпадают, Google заменяет заголовок реже, но это ещё не доказывает, что причина в самом совпадении. Если title дословно равен H1, Google менял его по существу в 4,3% случаев; если title не содержит H1 целиком — в 44,9%. Часть разницы объясняется способом подсчёта: подстановка H1 не выглядит заменой, когда title уже равен H1. Даже если исключить подстановки H1, доли остаются разными: 4,1% и 24,5%.
Связи между заменой заголовка и позицией в моих данных не видно. Если сравнить топ-20 с позициями 21–50, получится 50,2 из 100 (95%-й доверительный интервал — 49,8–50,5; случайный уровень — 50). Кликабельность (CTR, доля кликов от показов) в замер не входит: клики и показы смотрите в Search Console по своим страницам.
В выборке разные заголовки у одной страницы встречались редко. Из 13 951 страницы, показанной по двум и более запросам, различия (без учёта обрезки) были у 262 — 1,9%. Среди страниц, найденных по десяти и более запросам, доля составила 6,5%. Это результат одного замера; у отдельных страниц заголовок всё же может меняться в зависимости от запроса.
Чтобы заметить изменения, Google должен заново обойти страницу и обработать её содержимое. По документации это занимает от нескольких дней до нескольких недель. В Search Console можно запросить повторный обход. Заголовок в выдаче я бы проверял через две-три недели; это мой совет, в замере такого нет.