Семантический триплет — запись одного утверждения в трёх частях: субъект → связь (предикат) → объект. Субъект — о ком или о чём говорится; связь — что о нём утверждается; объект — другая сущность или значение. Например: «Apple производит iPhone» → «Apple → производит → iPhone».
Такими тройками удобно представлять знания в графах данных. Но сама форма записи не доказывает, что утверждение истинно, а её наличие в тексте не означает, что Google использует число триплетов как сигнал ранжирования. Именно эту SEO-гипотезу я и проверял.
Мой алгоритм использовал более широкий рабочий формат: в третье поле мог попасть не только объект, но и значение, срок или частота. Поэтому из предложения «Оплата списывается каждые 7 дней» он получал запись «оплата → списывается → каждые 7 дней». Ниже такие автоматически извлечённые записи для краткости называются триплетами.
Я сравнил страницы Google по 2400 запросам. Сначала проверил, больше ли триплетов на тысячу слов у страниц из топ-20, чем у страниц с мест 21–50. Затем посмотрел, чем отличаются страницы, на которые ссылаются «Обзор от ИИ» Google и «Быстрый ответ Алисы AI». Сначала идут выводы и действия для аудита; цифры и методика спрятаны в раскрывающихся блоках.
Что такое триплет и что я измерял
Для замера программа искала в предложениях субъект, связь и зависимый от неё объект или значение. Число таких записей на 1000 слов я называю плотностью триплетов.
Это не число истинных фактов. Программа может обрезать объект, перепутать роли, потерять условие или выписать строку из предложения без проверяемого утверждения. Поэтому я отдельно проверяю точность извлечения и не выдаю машинную запись за факт.
Рабочая запись из реального предложения со страницы letbefit.ru: «Оплата списывается каждые 7 дней». Третье поле здесь содержит частоту, а не отдельную сущность.
Масштаб автоматического разбора — отдельный результат исследования
1 000 358 кандидатов в триплеты программа извлекла из 58 644 уникальных текстов. Один и тот же URL мог встречаться по разным запросам. Всего этим текстам соответствуют 96 231 прочитанная пара «запрос — страница»; после исключения текстов короче 100 слов в основной анализ вошли 84 848 пар.
Каждый URL разбирался один раз, одинаковые ключи внутри страницы склеивались. Экстрактор разбирал весь основной текст страницы: длинные тексты делились на куски до 12 000 символов только по границам предложений (предложение длиннее куска резалось жёстко). В просмотренной литературе я не нашёл сопоставимого открытого SEO-замера связи такого показателя с позициями Google; это граница поиска, а не доказательство мирового первенства.
1 000 358 — объём автоматического разбора, а не число подтверждённых фактов. На отдельном эталоне из начала страниц языковая модель признала полностью верными 44,6% записей; человек эту выборку не размечал, а хвосты длинных страниц на точность не проверялись.
Четыре понятия, которые нельзя смешивать:
| Понятие | Что это | Измерено ли здесь |
|---|---|---|
| Утверждение в тексте | Что страница сообщает: «оплата списывается каждые 7 дней» | Число проверяемых утверждений оценила языковая модель, надёжность низкая (спойлер «Исследование под капотом») |
| Извлечённый триплет | Рабочая запись «субъект → связь → объект или значение», которую составила программа | Да, 1 000 358 кандидатов |
| Плотность триплетов | Сколько триплетов приходится на 1000 слов страницы | Да, основной показатель |
| Полнота ответа читателю | На сколько вопросов покупателя страница отвечает | Да, на шесть вопросов по каждому из 120 запросов (оценка языковой модели) |
Триплет, ключевое слово и название: в чём разница
Одно и то же предложение можно описать тремя способами. Ключевое слово говорит, о чём текст. Название (имя, компания, бренд, город) говорит, что или кто упомянут. Триплет говорит, что именно утверждается.
Ключевые слова
Показывают темы и запросы, к которым относится текст.
Названия
Показывают, кто или что названо.
Триплет
Показывает утверждение и связь между его частями.
Поэтому больше названий в тексте не значит больше утверждений: страница может упомянуть десять городов и ничего не сообщить о цене доставки в них. В нашем замере эти показатели вели себя по-разному: чем больше названий на 1000 слов, тем реже страницу цитировал ИИ (×0,84), а плотность триплетов была связана с цитированием слабо (×1,10). Это различие связей не доказывает причинного влияния ни одного из показателей.
Главный результат: топ богаче триплетами на один пункт из ста, оснований для общего норматива нет
Из 2400 собранных запросов в основной показатель вошли 2378 (у остальных не хватило читаемых страниц). Девять показателей я записал до расчёта: общая плотность триплетов и плотность триплетов с объектом действия («доставляем обеды»), сколько разных объектов и глаголов-связей встречается, доли триплетов с числом, ценой, сроком, единицей измерения и с самоописанием «мы». Все девять лежат между 49,8 и 51,0: четыре показателя про плотность и разнообразие чуть выше 50, пять показателей про состав у самой линии.
Если у верхних позиций есть универсальная норма плотности, страницы из топ-20 должны стабильно выигрывать у страниц с позиций 21–50 того же запроса.
51,0 из 100 по плотности триплетов. При близкой длине страниц — 50,3 (диапазон 49,8–50,8), а в модели с учётом длины и ссылок — ×1,00 (0,96–1,04).
Этот замер не даёт оснований назначать единый норматив триплетов на 1000 слов для аудита или ТЗ.
Исследование не доказывает, что факты бесполезны, что триплеты никогда не связаны с позицией или что странице не нужны ответы на вопросы покупателя.
Google, Москва, 02.10.2026, позиции 1–50, сравнения внутри запроса. Плотность и разнообразие: 2378 запросов, доли: 2052. Диапазоны погрешности (расчёт на случайных подвыборках запросов) у пяти показателей про состав внутри зоны 49–51, у четырёх показателей про плотность и разнообразие верхняя граница доходит до 51,0–51,5; полная таблица с диапазонами в разделе «Исследование под капотом».
Чтобы убедиться, что расчёт вообще умеет находить различия, я прогнал ту же процедуру на признаках, которые связаны с позицией заведомо: длина текста даёт 54,5, число ссылающихся доменов сайта 54,0. Разница по плотности триплетов (51,0) примерно в 4,5 раза меньше, чем по длине (1,0 пункта против 4,5). Это проверка самого расчёта. Насколько хорошо программа извлекает триплеты — отдельный вопрос, ответ на него в разделе про точность.
Откуда берётся этот пункт. Страницы топа длиннее (медиана 772 слова против 658), и разница сосредоточена среди самых длинных страниц: в слоях по длине 100–300, 300–800 и 800–2000 слов результат 49,4, 49,8 и 49,9, а от 2000 слов 52,8 (51,1–54,5). Если сравнивать страницы близкой длины (число слов различается не больше чем на 20%), результат 50,3 (49,8–50,8). Без агрегаторов (YouTube, Ozon, Википедия и подобные сайты) 50,6 (50,1–51,1). В модели, где учтены длина текста и ссылки сайта, плотность триплетов с попаданием в топ-20 не связана: шансы ×1,00 на стандартное отклонение, диапазон 0,96–1,04. Независимый пересчёт другим кодом даёт тот же результат: 51,0 (50,6–51,5).
Данные не дают основания вводить норматив «триплетов на 1000 слов»: оценка различия мала — 51,03 из 100, диапазон 50,61–51,45. Это сравнение уже ранжирующихся страниц, а не измерение причин роста. Проверять стоит не плотность ради числа, а то, хватает ли на странице подтверждённых ответов.
Сколько триплетов на странице целиком: ТОП1, ТОП3, ТОП5, ТОП10, ТОП20 и позиции 21–50
Плотность на 1000 слов нужна, чтобы честно сравнивать страницы разной длины. Но в аудите обычно спрашивают другое: сколько триплетов у страницы целиком. Ниже медианы по группам позиций: половина страниц выше этого числа, половина ниже. В скобках диапазон средней половины страниц (от 25% до 75%). Считано по 84 848 пригодным парам «запрос — страница».
| Группа позиций | Страниц | Слов на странице | На странице | На 1000 слов |
|---|---|---|---|---|
| ТОП1 | 1 869 | 804 (376–1 470) | 15 (6–28) | 19,1 (11,1–25,8) |
| ТОП3 | 5 761 | 812 (385–1 468) | 15 (6–30) | 19,5 (11,4–26,6) |
| ТОП5 | 9 671 | 827 (404–1 460) | 15 (6–30) | 19,7 (11,7–27,1) |
| ТОП10 | 19 398 | 813 (405–1 446) | 15 (6–31) | 19,8 (11,8–27,3) |
| ТОП20 | 38 347 | 772 (381–1 410) | 14 (5–29) | 19,5 (11,4–27,2) |
| Позиции 21–50 | 46 501 | 658 (335–1 281) | 12 (4–27) | 19,2 (10,8–27,2) |
Google, Москва, 02.10.2026. Группы вложены друг в друга: ТОП5 включает ТОП3, ТОП10 включает ТОП5. Триплетов на странице целиком — все триплеты, которые программа извлекла из полного основного текста. Слово здесь — слово или число из очищенного текста страницы (меню и разметка не считаются); для основного результата я проверил и более грубый способ, где словом считается любой фрагмент между пробелами: плотность 50,9 вместо 51,0, а абсолютные медианы слов получаются выше (811 вместо 772 для ТОП20).
Что видно. На странице целиком у типичного результата из первой десятки 15 триплетов, у ТОП20 в целом 14, у позиций 21–50 — 12. Разница в 1–3 триплета сопровождается разницей в длине: страницы топа в среднем длиннее на 115–170 слов. На 1000 слов медиана практически одна: 19–20 триплетов во всех группах. Разброс внутри каждой группы в разы больше разницы между группами: у четверти страниц ТОП1 всего 6 триплетов или меньше, у другой четверти 28 или больше. Поэтому по числу триплетов нельзя ни отобрать лидера, ни поставить цель копирайтеру. Это описание выдачи, а не норматив.
Цитирование в ответах ИИ: что отличает процитированные страницы
Для всех 2400 запросов я собрал блок «Обзор от ИИ» Google (Москва, десктоп, 4 октября 2026), для 800 запросов (по 50 на нишу) блок «Быстрый ответ Алисы AI» Яндекса (Москва, 4 октября). Блок Google нашёлся у 2230 запросов (93%), блок Алисы у 368 из 798 ответивших (46%). Из 13 097 ссылок блоков Google 8096 (62%) ведут на страницы позиций 1–50 нашей выдачи. В Яндексе из 6439 ссылок блока лишь 1476 (23%) стоят в органическом топ-10 того же запроса: Алиса чаще берёт источники вне топ-10.
Что показали данные, коротко.
- В исследованной выборке высокая позиция сильно связана с цитированием. В Google процитировано 60% страниц с позиций 1–3, 32% с 4–10, 6% с 11–20 и 2% с 21–50. Это наблюдаемая связь, а не доказательство обязательной последовательности «сначала попасть в топ, потом получить цитату».
- Отдельные признаки первого абзаца связаны с цитированием. При равной позиции отдельно проверялись длина 40–100 слов, определение в первом предложении и понятность без остального текста. Их совместный эффект без обязательной цифры не оценивался, поэтому складывать полученные для разных признаков и систем числа в один диапазон нельзя.
- Не связаны с цитированием: цифра в первом абзаце. Не связаны и место триплетов в начале, в абзацах или списках, и «прирост информации» (новые факты, которых нет у других страниц). Слабая связь одна: чем больше триплетов в последней пятой части текста, тем чуть реже цитируют (Google ×0,95, Яндекс ×0,88). Связаны отрицательно: названия — имена людей, компании, города, бренды (чем их больше на 1000 слов, тем реже цитируют).
- Триплеты: плотность слабо связана с цитированием: в Google шансы выше в 1,1 раза, в Алисе AI в 1,2 раза (если плотность выше на типичный разброс между страницами). С позицией в обычной выдаче Google она почти не связана.
- «Одна мысль в абзаце»: результат зависит от судьи-модели, норматив из него строить нельзя.
Как читать. × — отношение шансов цитирования, а не прирост вероятности: в расчёте для Google учтены позиция, длина текста и ссылки, для Яндекса — позиция и длина. Для непрерывных показателей (например, плотности) сравнение сделано на одно стандартное отклонение; для признаков «есть/нет» — между страницами с признаком и без него. ×1 соответствует отсутствию связи. Два числа — 95% доверительный интервал: если он включает 1, уверенное направление не установлено. Положительная или отрицательная связь — не эффект правки текста.
Показать подробные карточки по каждому признаку
Главное — позиция. В Google процитировано 59,8% страниц на позициях 1–3, 31,7% на 4–10, 6,3% на 11–20 и 1,8% на 21–50. В органическом топ-10 Яндекса 55,3% на позициях 1–3 и 39,2% на 4–10. Поэтому признаки ниже сравниваются при одной позиции, длине текста и ссылочной массе сайта (отношение шансов; для Яндекса без ссылочной массы). Для признаков «есть или нет» это множитель шансов при наличии признака, для непрерывных (плотность триплетов, сущности, цифры на 1000 слов, доля «одной идеи») — на одно стандартное отклонение. Значение 1 — связи нет, 1,1 — шансы процитированности выше в 1,1 раза; это множитель шансов, а не прирост вероятности. Регрессия Google рассчитана на 51 202 страницах с полным набором контролей.
Выборки: Google 1954 запроса и 69 978 страниц, из них процитировано 8096 (11,6%); Яндекс 337 запросов и 2543 страницы органического топ-10, процитировано 1127 (44%). Основным, заранее заданным признаком был «золотой параграф» целиком, и он связи не показал. Остальные признаки вторичные и проверялись без поправки на множественность сравнений. Строгую поправку (p меньше 0,0036 на 14 признаков Google) выдерживают первый абзац 40–100 слов, определение в первом предложении и плотность триплетов; сущности выдерживают её в отдельной проверке на 600 запросах.
Первый абзац 40–100 слов
Шансы выше в 1,14 раза (1,07–1,23). На местах 4–10 процитировано 30,9% страниц с таким абзацем и 26,3% без него.
Шансы выше в 1,19 раза (1,01–1,41).
Направление то же в обеих системах; у Яндекса значимость слабая (p=0,04).
Определение в первом предложении («— это», «является», «представляет собой»)
1,20 (1,07–1,33). В полосе 4–10: 33,1% против 27,5%.
1,32 (1,03–1,68).
Плюс чуть сильнее, чем у длины абзаца.
Самодостаточный первый абзац: без «выше», «ниже», «как сказано», не начинается с местоимения
1,24 (1,08–1,43). В полосе 4–10: 28,5% против 23,5%.
1,34 (0,98–1,82), на границе значимости.
Направление то же, интервал для Яндекса широкий.
«Золотой параграф» целиком: 40–100 слов, цифра, определение и самодостаточность одновременно
1,18 (0,87–1,60). Такой абзац есть всего у 1,2% страниц.
1,06 (0,53–2,09).
Убедительной связи не обнаружено. Это был заранее назначенный основной признак, но он встречается лишь у 1,2% страниц, а диапазоны оценки широкие — данных недостаточно для сильного вывода ни о пользе, ни об отсутствии эффекта.
Цифра в первом абзаце
0,97 (0,87–1,08).
0,92 (0,72–1,18). Страницы с большим числом цифр на 1000 слов цитируются реже: 0,65 (0,49–0,88).
Цифры в первом абзаце с цитированием не связаны. В Яндексе страницы с большим числом цифр цитируются реже; это наблюдательная связь, причину она не объясняет.
«Одна мысль в абзаце» (оценка моделей-судей, три судьи, 239–284 сравнения «процитированная — непроцитированная страница»)
По большинству голосов 1,25 (0,99–1,58). У отдельных судей от 0,98 до 1,50.
По большинству голосов 1,22 (1,03–1,45). У отдельных судей от 1,10 до 1,22.
В Google большинство судей однозначной связи не дало (интервал включает 1), в Яндексе связь слабая положительная. Результат зависит от судьи, согласие судей умеренное (каппа 0,43–0,61): показатель разведочный, норматива из него не строят.
Плотность триплетов алгоритма (на тысячу слов)
1,10 на стандартное отклонение (1,06–1,13).
1,16 (1,08–1,24) на 6031 странице 357 запросов; среди страниц органического топ-10 1,09 (1,01–1,18). Извлечение то же, что для Google.
Небольшой плюс при той же позиции, длине и ссылках. С позицией в обычной выдаче Google плотность почти не связана.
Именованные сущности на 1000 слов
0,84 (0,77–0,91): связь отрицательная. Порог «15 на 1000 слов» проходят 29% процитированных и 37% непроцитированных страниц.
0,81 (0,63–1,06): связь не установлена.
Совет «насыщайте текст сущностями» данные не подтверждают.
Новизна: доля триплетов, которых нет на других страницах запроса
0,97 (0,93–1,00); число таких триплетов на 1000 слов 1,01 (0,97–1,05).
Доля новых триплетов 1,06 (0,99–1,13); число новых триплетов на 1000 слов 1,15 (1,06–1,24), отчасти это плотность. Среди страниц органического топ-10: 1,10 (1,00–1,20) и 1,07 (0,98–1,17).
Положительной связи для этого показателя новизны не найдено (интервал для доли новых триплетов на границе единицы). Считали только дословные совпадения лемматизированных триплетов, поэтому показатель грубый: он не охватывает «прирост информации» во всех трактовках.
Где в тексте стоят триплеты (в начале, в конце, в абзацах, в списках)
Последняя пятая часть текста 0,95 (0,91–0,98); первые 300 слов 1,01, первая пятая часть 1,02, абзацы 0,98, списки и таблицы 1,03.
Последняя пятая часть текста 0,88 (0,82–0,95); начало, абзацы и списки без связи (0,96–1,06); первые 300 слов 1,13 (1,05–1,22); в органическом топ-10 последняя пятая часть 0,89 (0,80–0,98), первые 300 слов 1,08 (0,99–1,18).
Связана только концовка: чем больше триплетов в последней пятой части текста, тем чуть реже цитируют. Остальные показатели места с цитированием не связаны.
Позиция и цитирование связаны в этой выборке. В «Обзоре от ИИ» Google процитировано 60% страниц с позиций 1–3 и около 2% страниц с позиций 21–50. Это не задаёт обязательный порог попадания в топ: исследование наблюдательное и не проверяло причинный эффект позиции или правок страницы.
При равной позиции с цитированием связаны три признака первого абзаца: длина 40–100 слов, определение в первом предложении («X — это …») и понятность без остального текста. На местах 4–10 процитировано на 4,6–5,6 процентного пункта больше страниц с каждым из них. Сочетание этих трёх признаков без цифры отдельно не считалось, а полный «золотой параграф» с цифрой связи не показал. Это согласуется с давним правилом про прямой ответ в начале.
Не стоит делать ради цитирования: набивать начало цифрами, увеличивать число названий (имён, брендов, городов), переставлять факты ближе к началу, вводить норматив плотности. Для этих приёмов надёжного практического эффекта данные не устанавливают: оценки слабые и близки к уровню «разницы нет». Не убирайте нужные названия и не меняйте порядок фактов только ради предполагаемого цитирования.
Границы: данные описывают Google и Яндекс (Москва); блоки ChatGPT, Perplexity и Gemini в замер не входят. Это наблюдение, а не эксперимент: связь не доказывает, что правка текста сдвинет цитирование.
Разбор по нишам, типам запросов и сайтов
Общий результат отвечает на вопрос об универсальном нормативе, но может скрывать отдельные случаи. Поэтому после основного расчёта я разрезал данные по нишам, формулировкам запросов и заранее выделенным широким платформам, а затем проверил направление на независимом наборе новых запросов. Это разведка после просмотра данных: она показывает, куда смотреть SEO-специалисту, но не доказывает причину позиции.
Плотность в 16 нишах: основной корпус и повтор
Что видно по всем нишам. В основном корпусе 95% диапазон выше 50 у общепита, красоты, образования, спорта и ремонта, а целиком ниже — у финансов. В повторе на новых запросах диапазон плотности выше 50 только у общепита. Направление точечной оценки совпало в 6 нишах из 16; в остальных оно перешло через линию 50. Это наблюдение помогает выбрать, где проверять ответы конкурентов, но не доказывает, что плотность меняет позицию.
Как использовать разрез. Для общепита ниже есть отдельный список вопросов и медианы. Для красоты, образования, товаров для дома и других ниш цифры годятся только как подсказка, какие ответы сравнить с лидерами. Финансовый результат не означает, что фактов должно быть меньше: в повторе он сменил сторону. Числовой норматив ни для одной ниши вводить нельзя.
Общепит выдержал повтор. В топ-20 выше плотность, число разных объектов и связей. Это единственная из 16 ниш, где все четыре показателя повторились с диапазоном выше линии 50.
Вопросы и цена/заказ. У верхних страниц стабильно больше текста и кандидатов в триплеты на странице целиком. Плотность на 1000 слов почти не отличается.
На широких платформах и на остальных сайтах повторился абсолютный объём. Страницы топа длиннее и содержат больше записей; универсального преимущества плотности нет.
В корпусе нет страниц за пределами топ-50 и нет проверенной разметки «услуга / каталог / статья». Поэтому здесь есть ориентиры уже ранжирующихся страниц, но нет порога входа в топ-50.
Общепит: единственный нишевой сигнал, который повторился целиком
В основном корпусе медианная длина страниц общепита почти одинакова: 511 слов в топ-20 и 509 на позициях 21–50. На этом фоне верхняя группа содержит больше разных утверждений на тот же объём текста. На новых запросах направление сохранилось по всем четырём показателям.
| Показатель на 1000 слов | Медианы топ-20 / 21–50 | Основной корпус | Повторный замер |
|---|---|---|---|
| Все кандидаты в триплеты | 18,4 / 15,2 | 55,9 (54,2–57,5) | 54,6 (50,7–58,3) |
| С объектом действия | 6,5 / 5,8 | 55,0 (53,3–56,8) | 55,0 (51,1–58,6) |
| Разные объекты | 16,4 / 14,1 | 56,0 (54,3–57,7) | 54,7 (50,6–58,7) |
| Разные связи | 12,7 / 10,9 | 55,2 (53,5–56,9) | 54,0 (50,0–57,8) |
Что делать SEO-специалисту в общепите. Не добивать текст до числа 18,4. Сначала сравнить с лидерами ответы о составе и весе блюда, размере порции, цене и условиях её изменения, минимальной сумме, зоне и интервалах доставки, времени приготовления, хранении и ограничениях. Добавлять только собственные подтверждённые значения. Число 18,4 — контрольный ориентир ниши, а не требование и не обещание роста.
Разрез выбран после основного анализа. Различия по доле чисел, сроков и единиц измерения в первом корпусе не подтвердились отдельно на новых запросах; превращать их в рекомендации нельзя.
Вопросы и запросы про цену: важнее охват, а не плотность
Что повторилось у разных формулировок запросов
«Как», «что», «сколько» и подобные
- Топ-20
- 978 слов · 19 триплетов
- 21–50
- 849 слов · 17 триплетов
- Топ-20
- 936 слов · 18 триплетов
- 21–50
- 806 слов · 16 триплетов
Повторилось: больше текста и записей на странице целиком; плотность одинаковая.
Цена или заказ в запросе
- Топ-20
- 712 слов · 12 триплетов
- 21–50
- 601 слово · 10 триплетов
- Топ-20
- 692 слова · 12 триплетов
- 21–50
- 583 слова · 10 триплетов
Повторилось: больше текста и записей на странице целиком; плотность почти одинаковая.
Практический вывод. Для вопроса или коммерческого запроса проверяйте не «триплеты на тысячу слов», а список закрытых задач. Для цены это сама цена или диапазон, что входит, от чего меняется, минимальный заказ, доплаты, оплата и возврат. Для вопросительного запроса — прямой ответ, порядок действий, исключения и источник. Если нужные ответы уже есть, удлинять страницу ради медианы не нужно.
Широкая платформа и обычный сайт: повторяется тот же рисунок
В исследовании заранее выделены домены, которые встречаются минимум в 40 запросах и шести нишах: маркетплейсы, соцсети, крупные издатели и другие широкие платформы. Это единственный проверяемый «тип сайта» в данных. Отдельного классификатора страниц «услуга / каталог / статья / карточка» нет.
| Группа сайтов | Основной корпус: топ-20 / 21–50 | Повтор: топ-20 / 21–50 | Плотность |
|---|---|---|---|
| Широкие платформы | 739 / 447 слов; 11 / 6 триплетов | 672 / 447 слов; 10 / 6 триплетов | 14,8 / 14,0; в повторе 15,0 / 14,5 |
| Остальные сайты | 778 / 701 слово; 15 / 14 триплетов | 770 / 684 слова; 15 / 13 триплетов | 20,5 / 20,4; в повторе 20,7 / 20,9 |
И у платформ, и у остальных сайтов верх выдачи чаще содержит больше материала и больше извлечённых утверждений на странице целиком. Плотность не даёт переносимого преимущества. Для аудита это означает: ищите недостающий ответ или условие, а не свободное место, куда можно вставить ещё одну конструкцию «субъект — связь — объект».
Ориентир топ-50: для диагностики, не для проходного балла
Если считать каждый URL один раз, средняя половина уже ранжирующихся страниц топ-50 лежит в следующих пределах:
| Показатель | Четверть ниже | Медиана | Четверть выше |
|---|---|---|---|
| Слов в основном тексте | 333 | 644 | 1218 |
| Кандидатов в триплеты на странице | 4 | 12 | 26 |
| Кандидатов на 1000 слов | 10,6 | 19,2 | 27,4 |
Значение ниже первой четверти — повод проверить, не потерялись ли важные ответы, но не команда дописать текст. В самом топ-50 около 8% пригодных пар не содержат ни одного извлечённого триплета, поэтому обязательного минимума данные не показывают. Чтобы найти именно порог входа в топ-50, нужен следующий замер: добавить релевантные проиндексированные страницы за пределами первых 50 результатов и сравнить их с ранжирующимися.
Полный расчёт: analysis_segments_D2.py, results_segments_D2.csv и RESULTS_SEGMENTS_D2.md. Формулировки запросов определены прозрачными словарными правилами; группы пересекаются. Все разрезы в этом разделе вторичны относительно заранее заданного анализа.
Как использовать это в аудите
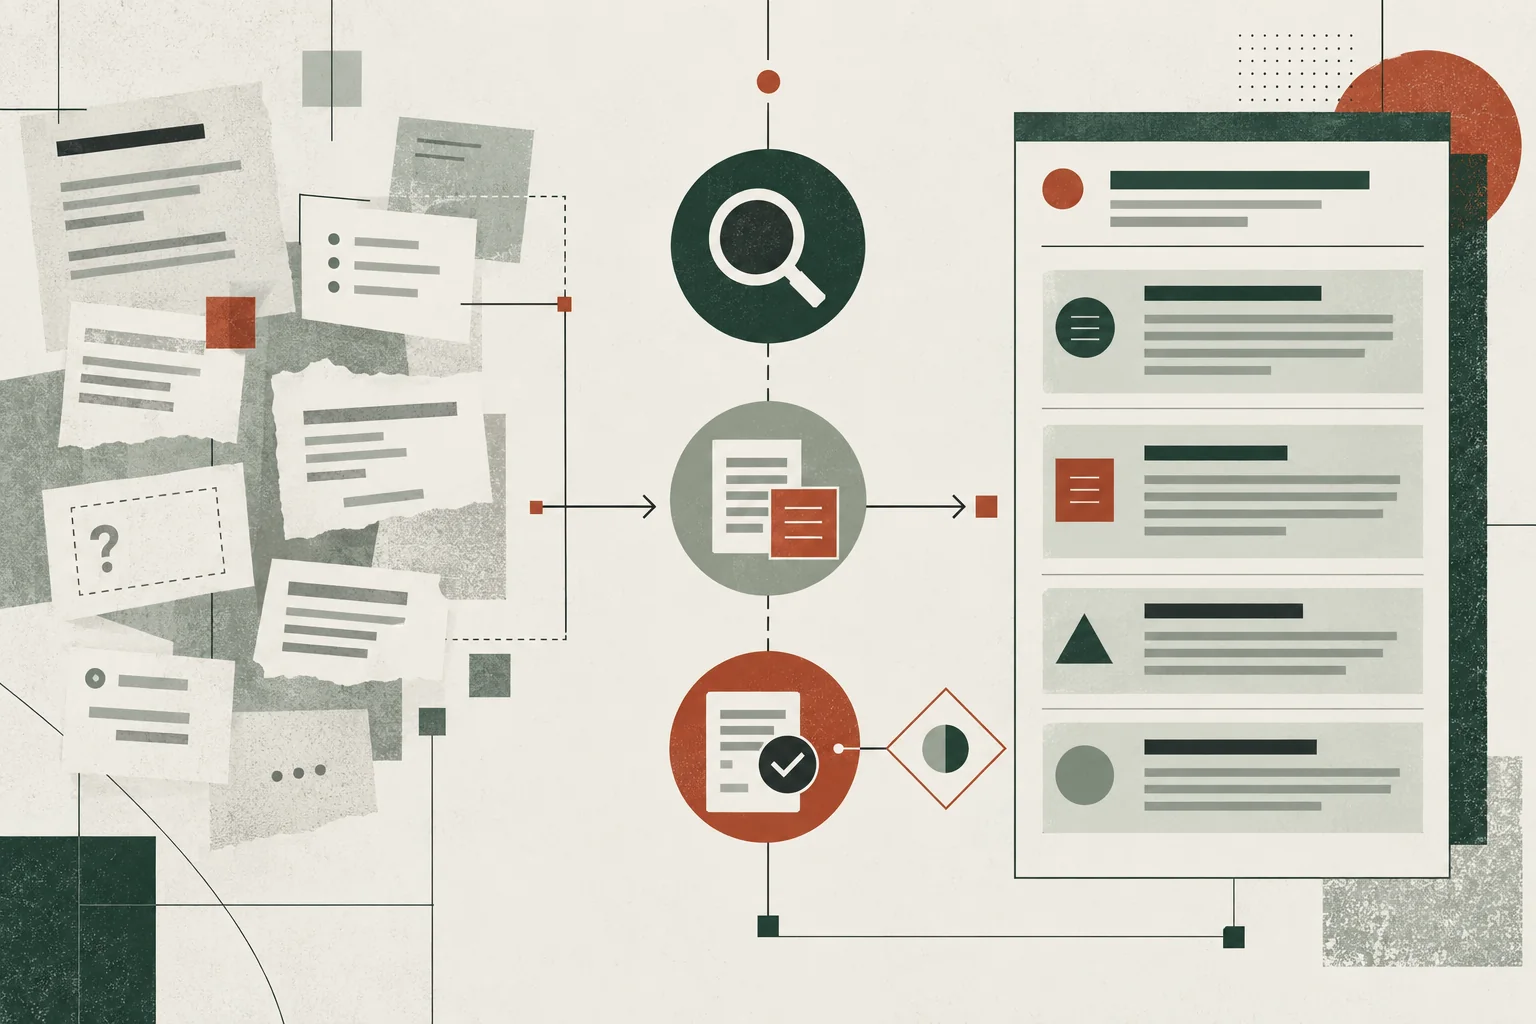
Замер не даёт оснований вводить единый норматив плотности триплетов: преимущество топ-20 около одного пункта из ста и исчезает при учёте длины страницы. Рабочая процедура другая: она сравнивает страницу с лидерами по вопросам покупателя и выдаёт список обоснованных правок. Это редакторская процедура: роста позиций она не обещает, она закрывает вопросы покупателя.
- Выберите сопоставимые страницы
Лидеры — 3–5 страниц того же типа (услуга с услугой, каталог с каталогом) из топ-10 вашего запроса, а если подходящих мало, из топ-20. Агрегаторы и маркетплейсы не берите. Для информационных запросов шаги те же, меняются вопросы: определение, порядок действий, ограничения, источники.
- Выпишите вопросы, на которые они отвечают
Цена и от чего она зависит, срок и что его меняет, оплата, доставка, гарантия и кто её даёт, масштаб (стаж, число клиентов). Способы выписать: вручную или через нейросеть (инструкция).
- Проверьте свою страницу целиком
Включая таблицы, сноски и блоки под кнопками. Цены и характеристики из HTML-таблиц снимайте отдельно или вставляйте таблицу целиком: при выделении основного текста они теряются. Ответ может быть на странице, но в другом месте.
- Для каждого пробела примите решение
Нужна ли эта информация вашему предложению? Чем вы её подтвердите (прайс, договор, документ)? Если подтвердить нечем, пробел остаётся пробелом.
- Запишите правку в ТЗ
Конкретно: что указать, где, с каким условием и чем подтверждено. Чужие значения не переносите.
Разбор на реальных страницах
Запрос «доставка вкусной еды», Google, Москва, 2 октября 2026. Для компактности взяты два лидера, letbefit.ru (13-е место) и nam-nyam.ru (16-е); в рабочем разборе их 3–5. Колонка «Что у вас» — учебный пример, вымышленный.
Как превратить ответ лидера в проверяемую задачу для своей страницы
Когда и как списывается оплата?
letbefit.ru: «Оплата списывается каждые 7 дней»; «На 5-й день действия вашего рациона питания мы списываем оплату за следующую неделю»
«Оплата онлайн»
Указать периодичность списания и предупреждение. Значения согласовать с бухгалтерией, не копировать.
Какая минимальная сумма заказа?
nam-nyam.ru: «Минимальная сумма заказа составляет 4000 рублей»
Не указана
Запросить собственный порог у отдела продаж и указать его с условием.
Куда доставляют и в какие интервалы?
letbefit.ru: «Мы осуществляем бесплатную доставку питания по Москве […] и МО»; «Выбирайте любой удобный двухчасовой интервал […]»
«Быстрая доставка»
Заменить «быстрая» на зону, цену и интервалы, которые вы реально выдерживаете.
Какие свойства блюд заявлены и чем подтверждены?
letbefit.ru: «Мы гарантируем, что каждое блюдо рассчитано по КБЖУ и не содержит сахара […]»
«Натуральные продукты»
Выбрать свойство, которое можно подтвердить документом (состав, лаборатория), и написать его вместе с подтверждением.
Предложения лидеров — со страниц выдачи на 2 октября 2026, дословно с точностью до знаков очистки текста. Это сравнение вопросов, не оценка того, почему страницы стоят на этих местах.
Показать матрицу ответов трёх выбранных результатов топ-20 по пяти вопросам
Матрица фактов трёх выбранных результатов топ-20
Те же вопросы по трём страницам из топ-20 того же запроса (места 8, 9 и 13). Цитаты дословные с точностью до знаков очистки текста; «[…]» — пропуск. В каждой ячейке один из четырёх статусов: ответ найден (цитата отвечает именно на этот вопрос), частичный ответ (цитата закрывает только одну часть составного вопроса), тема есть, ответа нет (в проверенной цитате ответа нет; для страницы целиком это не доказано), не найдено в триплетах (страницу глазами не читал) и не проверено. Ячейку «не найдено в триплетах» нельзя считать подтверждённым отсутствием ответа и нельзя включать в подсчёт «у скольких конкурентов нет»; то же относится к «тема есть, ответа нет», пока страница не прочитана целиком.
Куда доставляют и сколько это стоит?
Не найдено в триплетах
Не найдено в триплетах
Ответ найден. «Мы осуществляем бесплатную доставку питания по Москве […] и МО»
Назвать зону и цену. Значения согласовать с логистикой
Через сколько привезут и в какие часы?
Не найдено в триплетах
Ответ частичный. Есть примерный срок и работа круглосуточно, но не указаны конкретные интервалы получения.
Частичный ответ. «Выбирайте любой удобный двухчасовой интервал […]» — указан интервал, но не срок доставки
Назвать срок и интервалы, которые вы реально выдерживаете
Когда приготовлено и сколько хранится?
Ответ найден. «Блюда готовятся в день отправки клиенту, без хранения на складе»; «[…] срок годности — 84 часа, хранить нужно в холодильнике»
Тема есть, ответа нет. «[…] курьеры используют специальные боксы, которые сохраняют тепло, поэтому все блюда приходят горячими» — это температура при получении, а не время приготовления
Частичный ответ. «Наши повара готовят в 2 смены — ночью для утренних заказов и днем для вечерних» — сказано, когда готовят, но не сколько хранится продукт
Указать, когда готовят и сколько хранится. Подтвердить документом
Когда и как списывается оплата?
Не найдено в триплетах
Не найдено в триплетах
Ответ частичный. Указана периодичность списания, но не способ оплаты и точный момент списания.
Если у вас подписка, указать период списания и предупреждение
Чем подтверждено качество?
Тема есть, ответа нет. «[…] на кухнях внедрена система ХАССП и чек-листы контроля на каждом этапе» — заявление о процессе, документ не показан
Тема есть, ответа нет. «Во всех блюдах чётко рассчитаны КБЖУ, а каждая порция большая и сытная» — заявление о свойствах
Тема есть, ответа нет. «Мы гарантируем, что каждое блюдо рассчитано по КБЖУ и не содержит сахара […]» — гарантия без подтверждающего документа
Заявлять только то, что подтверждено документом, и согласовать с юристом
Страницы и предложения: выдача Google, Москва, 2 октября 2026. Это сравнение вопросов, не объяснение позиций. В примере у трёх страниц качество вообще не подтверждено документом в этих предложениях; вывод относится только к ним.
Готовый фрагмент ТЗ копирайтеру (для учебного примера)
В блоке оплаты указать, когда списываются деньги и за какой период, и как клиент узнаёт о списании. В блоке доставки заменить «быструю доставку» на зону, стоимость и доступные интервалы. Если минимальная сумма заказа есть, указать её и условие бесплатной доставки; если нет, написать «без минимальной суммы». Каждое значение согласовать с отделом, который отвечает за него, и приложить подтверждение. Не использовать сроки, суммы и обещания конкурентов.
Что делать в четырёх ситуациях
| Ситуация | Что делать |
|---|---|
| Вопросы покупателя раскрыты, триплеты извлечены корректно | Ничего не наращивать. Плотность триплетов не цель |
| Вопросы не раскрыты, триплеты извлечены корректно | Запросить значения у бизнеса и добавить подтверждённые ответы |
| Алгоритм показывает пропуск, человек видит ответ на странице | Исправить извлечение (контекст, блоки, таблицы), а не страницу |
| Текст неоднозначен даже для человека | Править страницу ради читателя |
Что делать с пробелом: правила «если — то»
| Ситуация | Решение |
|---|---|
| Вопрос относится к вашему предложению, и у вас есть подтверждение | В ТЗ. Приоритет решает, мешает ли отсутствие ответа выбрать предложение, понять условия или оформить заказ |
| Вопрос относится к вашему предложению, подтверждения нет | Задача бизнесу, не копирайтеру: сначала получить значение и документ |
| Вопрос закрыт у большинства выбранных лидеров | В список вопросов для проверки. Частота у конкурентов приоритет не задаёт |
| Вопрос закрыт у одного-двух лидеров | Возможное преимущество: решение за владельцем предложения |
| Ответ на вашей странице есть, но покупатель его не увидит (свёрнут, далеко от цены или кнопки) | Перенос или якорная ссылка, а не новый текст |
| Ответ на виду, но его не нашёл только алгоритм | Ничего не менять на странице; править извлечение |
Решения в таблице редакторские. Заявления о составе и пользе публикуйте только при наличии документа (протокол испытаний, декларация) и согласуйте с юристом.
Образец: как отредактировать первый абзац
С цитированием при равной позиции связаны три признака первого абзаца: длина 40–100 слов, определение в первом предложении и понятность без остального текста. Ниже учебный пример. Он вымышленный: услуга, срок и условия придуманы, в вашем тексте их заменяют значениями, которые вы можете подтвердить документом.
| Было (21 слово) | Стало (46 слов) |
|---|---|
| Мы — команда профессионалов, которая много лет помогает клиентам. Установка окон у нас выполняется быстро, качественно и по доступным ценам. Подробности ниже. | Установка пластиковых окон — это монтаж оконного блока в проём с утеплением и герметизацией швов. В стандартной квартире мы устанавливаем окно за один день, а срок для нестандартных проёмов называем после замера. Стоимость зависит от профиля и числа створок; точную цену фиксируем в договоре после выезда мастера. |
Что изменилось и почему:
- Определение в первом предложении. Абзац начинается с «X — это …», и читатель (или модель) сразу получает смысл термина.
- Абзац понятен без остального текста. В нём нет «ниже», «как сказано выше» и местоимений вместо подлежащего.
- Условия стоят рядом с фактом. «За один день» относится к стандартной квартире, срок для нестандартных проёмов отложен до замера, цена привязана к договору.
- Убраны оценки без проверяемого содержания. «Быстро», «качественно» и «по доступным ценам» ничего не утверждают.
- Длина укладывается в 40–100 слов.
Это иллюстрация признаков из исследования. Данные показывают связь с цитированием, а не гарантируют ни цитирования, ни роста позиций.
Новизна: как добавить своё, а не пересказать конкурента
Пересказ меняет слова, но не сообщает ничего нового. Новая информация — то, чего нет на других страницах выдачи и что вы можете подтвердить. Исследование измеряло новизну грубо, по дословному совпадению триплетов, поэтому практический критерий здесь редакторский.
«Доставка занимает 2–3 дня»
«Привезём за два-три дня»
Новых данных нет«Из московского склада — 2 дня, из регионального — 5; срок считаем от оплаты; в сезон добавляется 1 день»
Новая информацияЗначения вымышленныеОткуда брать своё: прайс и договор (условия, исключения); внутренние данные (медианный срок за последние 90 дней, доля возвратов); ограничения («чего мы не делаем»); документы (протокол испытаний, лицензия, сертификат); кейсы с датой и цифрой. Проверьте, добавляет ли фрагмент новые данные, условия, ограничения, наблюдение или способ решения относительно выбранных материалов. Замена слов и названия компании сама по себе новой информации не создаёт.
Что делать и чего не делать
Делайте
- Сравнивайте страницу с лидерами по вопросам покупателя. Проверяйте, чего нет у вас, и записывайте правку с подтверждением.
- Ставьте условие рядом с фактом: в той же фразе, строке таблицы или сноске («Доставка бесплатна при заказе от 5000 рублей», а не «Доставка бесплатна»). Это редакторский совет для читателя страницы, а не требование алгоритма.
- Если автоматическое извлечение вам нужно, измерьте его точность на своих данных до первых выводов.
Не делайте
- Не вводите в ТЗ и отчёт норматив «триплетов на тысячу слов»: в среднем он топ от низа почти не отделяет (разница около одного пункта из ста).
- Не ставьте число триплетов в KPI: оно почти не отделяет топ от низа выдачи (разница около одного пункта из ста). У правил к этому добавляется низкая точность.
- Не копируйте чужие цены, сроки и гарантии. Переносите вопрос, а не значение.
- Не меняйте длину текста ради плотности: плотность топ почти не отделяет. Длина сама по себе тоже не цель: в прошлом замере при равном охвате темы её преимущество почти исчезало.
Как проверить эффект правок
- Зафиксируйте дату внедрения и сравните страницы с правками с похожими без правок (хотя бы по 10 страниц в каждой группе; порог редакторский).
- Главная метрика — звонки, заявки или конверсия страницы; позиции через 4–8 недель вторичны.
- Пороги и сроки редакторские. Перед отправкой текстов клиента в стороннюю модель проверьте условия NDA.
Границы выводов
- Это наблюдение, а не эксперимент: связь не доказывает, что причина именно в этом.
- Охват: Google и Яндекс, Москва; десктоп для Google; ChatGPT, Perplexity, Gemini в замер не входят.
- Совпадение утверждений разных сайтов оценено через долю общих триплетов (раздел о цитировании).
- Оценки точности извлечения, полноты ответа и «одной идеи» выставляли языковые модели; согласие судей приведено в разделах.
Протокол замера цитирований в ответах ИИ
Шесть шагов для повторяемого сравнения страниц с правками и контрольной группы.
- Запросы. 20–30 запросов: половина ведёт на страницы с правками, половина на похожие страницы без правок (контрольная группа).
- Условия не меняются. Система («Обзор от ИИ» Google, Алиса AI и так далее), регион, устройство, язык, вход в аккаунт одни и те же во всех прогонах.
- Сроки и повторы. Прогон до правок, через 4 и 8 недель. В каждый срок минимум три прогона по каждому запросу в разные дни: ответ ИИ от раза к разу меняется. В моём замере Алисы AI (40 запросов, три прохода 17 сентября 2026) блок был во всех трёх проходах у 32 запросов; посимвольно одинаковый текст дали только 8 из этих 32. Средний общий состав совпал на 60,5% по точным URL источников и на 51,4% по ссылкам внутри ответа.
- Что записывать по каждому ответу. Дату, запрос, есть ли блок ИИ, текст ответа или скриншот, список ссылок в порядке показа, есть ли среди них ваш адрес и какая именно страница, назван ли бренд без ссылки, какие конкуренты среди ссылок.
- Что считать. Долю запросов, где ваша страница есть среди ссылок; отдельно долю запросов, где бренд назван без ссылки. Сравнивать группу с правками и контрольную. На 20–30 запросах разница служит ориентиром, а не доказательством.
- Переходы. Для ИИ-блоков внутри поисковика наличие ссылки проверяйте отдельно от поискового трафика: Google включает клики из AI Overviews и AI Mode в общие данные Search Console для типа поиска Web и не выделяет их отдельным источником (документация Google). Переходы из отдельных чат-сервисов анализируйте по доступным источникам и реферерам; эти два случая не смешивайте.
Расхожие утверждения про триплеты: что именно проверено
Поисковики оценивают связи между сущностями
Проверено косвенноНапрямую это не наблюдается. Проверено следствие: плотность триплетов почти не отличает топ-20 от позиций 21–50 (51,0 из 100), связь «позиция — плотность» почти нулевая (−0,019; 0 означает «связи нет»).
Google описывает системы понимания значений слов и понятий (BERT, RankBrain) [1]. Ранжирования по числу триплетов эти описания не подтверждают.
Чем больше чётких утверждений, тем выше страница
Норматив не подтверждёнПлотность триплетов моего алгоритма: 51,0 из 100; преимущество топ-20 около одного пункта и исчезает при учёте длины страницы.
Публичного подтверждения я не нашёл.
Чёткие утверждения помогают нейросетям цитировать контент
Слабая связьПри той же позиции, длине и ссылках плотность триплетов даёт шансы выше в 1,10 раза (диапазон 1,06–1,13) в Обзоре от ИИ Google. Позиция связана с цитированием несравнимо сильнее (60% против 2%).
Google прямо пишет, что писать «особым образом» для ИИ не нужно.
Один абзац — одна идея
Однозначного ответа нетПо большинству трёх судей-моделей 1,25 (0,99–1,58) в Google и 1,22 (1,03–1,45) в Яндексе; у отдельных судей от 0,98 до 1,50.
Это редакторское правило.
Триплеты показывают, раскрыта ли тема
Почти не показываютСвязь плотности триплетов с полнотой ответа читателю внутри запроса слабая (0,14; 0 — связи нет, 1 — полное совпадение), у числа слов заметно сильнее (0,42).
В прошлом замере охват темы различал топ лучше других текстовых признаков (55,3 из 100 для сравнений «топ-20 против 21–50»).
[1] Google Search Central, «A guide to Google Search ranking systems», разделы о BERT и RankBrain.
Что говорят в сети и что показывают наши данные
Итог сверки: утверждения «поисковик ранжирует по триплетам» и «фактов на 1000 слов должно быть не меньше N» в наших данных не находят опоры, а пороги в 5, 12,5 и 30 утверждений на 1000 слов либо проходят почти все страницы, либо их проходит поровну топ и низ. Точные эффекты (642%, 4,2 раза, 4,8 раза, 400%) воспроизвести нельзя: источники не раскрывают выборку и методику. Смежные гипотезы о цитировании проверены здесь на Обзоре от ИИ Google и Алисе AI.
Показать 15 утверждений из сети с цитатами и вердиктами
Я собрал утверждения про триплеты, плотность фактов и «письмо под ИИ» из русскоязычных и английских источников (поиск 4 октября 2026): в файлах собрано 19 авторских утверждений на русском и 17 на английском, два критических разбора, заявления Яндекса и Google; ниже 15 карточек, которые можно сверить с данными. Страницы читали и цитировали по тексту, ключевые цитаты (руководство Google, справку Яндекса, HubSpot, Стокса) я сверил с открытыми страницами сам. Доказательства, на которые ссылаются авторы (патенты Google, утечка Content Warehouse API, собственные кейсы), указаны в карточках, а вердикт ставится по данным этой работы: органическая выдача Google, блок «Обзор от ИИ» Google и «Быстрый ответ Алисы AI» Яндекса (Москва). ChatGPT, Perplexity и Gemini в замер не входят.
HubSpot, Curt del Principe, обновлено 12.03.2026 (EN)
«While semantic triples are beneficial for SEO, they’re necessary for AEO.» Заявлен рост цитирований в ответах ИИ на 642%.
Собственный эксперимент, в котором триплеты шли вместе с другими правками; сама автор пишет, что работает сумма изменений.
Для органической выдачи Google почти не подтверждается: преимущество топа по плотности триплетов около одного пункта (51,0 из 100) и исчезает при учёте длины страницы. Для цитирования в Обзоре от ИИ Google связь слабая: плотность триплетов даёт 1,10 при той же позиции. Рост на 642% в ChatGPT и Perplexity этими данными не проверяется: они вне охвата.
Mike King, iPullRank, 13.08.2025 (EN)
«One of the most effective ways to support this is by writing in semantic triples: simple subject-predicate-object phrases that state facts clearly.» (цитата из сниппета выдачи)
Устройство графа знаний и векторного поиска; эксперимента или документации Google в этом блоке нет.
Слабо подтверждается для Обзора от ИИ Google: плотность триплетов 1,10 (1,06–1,13) при той же позиции. На позиции в обычной выдаче эффекта почти нет.
Market Brew, 24.09.2025 (EN)
«The more accurately search engines can identify these relationships, the better they can understand, categorize, and rank content.»
Ничего конкретного: ссылка на устройство графов знаний и на собственную модель поисковика.
Эта работа не проверяла чёткость связей. Здесь измерялась плотность автоматически извлечённых триплетов. Отдельная оценка чёткости связей и её влияния на позиции не проводилась.
SEOMATIK, без автора и даты (RU)
«Единственный способ — работать со смыслом напрямую: через сущности и триплеты.» Новая страница «без нового knowledge graph не индексируется».
Патенты Google, утечка Content Warehouse API, «наша практика»; цифр и эксперимента на странице нет.
Не подтверждается. Страницы, где моё извлечение не нашло ни одного триплета, стоят в топ-20 в 7,5% случаев, в топ-3 в 7,7%, на позициях 21–50 в 8,2%. Это не доказательство отсутствия графа у Google, но страницы без найденных «триплетов» индексируются и ранжируются.
Андрей Ставский, вебинар 04.05.2026 (RU)
«если насытить текст вот такими триплетами, то доля нейроответов в вашем сайте растёт драматически». Сам оговаривает: «Ну я везде не проверял».
Патенты Google, сверенные нейросетью с утечкой Content Warehouse API, собственные эксперименты; автор продвигает свой инструмент.
«Драматически» не подтверждается: плотность триплетов даёт 1,10 на стандартное отклонение в Google; признаки первого абзаца для Алисы 1,2–1,3. Позиция объясняет цитирование намного сильнее.
Александр Тригуб, 06.04.2026, обновлено 22.05.2026 (RU)
«Текст, насыщенный корректными триплетами, семантически богаче текста с тем же объёмом, но написанного просто под ключевые слова.» Страницы с «сущностной плотностью» ранжируются лучше при сопоставимых ссылках.
Патенты Google; автор сам пишет, что «патент — это не обязательно внедрённый алгоритм», а вес извлечения триплетов назван гипотезой.
Не подтверждается. Регрессия с поправкой на длину текста и число ссылающихся доменов даёт отношение шансов 0,96–1,07 на стандартное отклонение показателей про факты. Для плотности триплетов 1,00 (0,96–1,04); без поправки на число проверок заметны только плотность с объектом действия (1,05) и доля «мы» (1,07).
Илья Пронин, 08.08.2026 (RU)
«Использование структуры SPO … помогает поисковым роботам Google мгновенно извлекать факты из текста. Это повышает шансы статьи попасть в Featured Snippets … и Граф знаний.»
Ничего: ни патентов, ни теста, только пример «до/после».
Избранные ответы в этой выдаче не показываются: в ответах API по 59 случайным запросам блока избранного ответа нет, а Обзор от ИИ есть у 93% запросов. Попадание в Граф знаний со стороны не наблюдается.
Сергей Сивков, 25.04.2026 (RU)
«Минимум 5 конкретных фактов (цифр, имён, названий, сроков) на 1 000 слов.»
Работа Aggarwal et al. (2023) и отчёт GenOptima, названиями; сами работы в тексте не разобраны.
Порог не различает страницы. По оценке модели его проходят 97,5% страниц топ-20 и 97,4% страниц с позиций 21–50. Для цитирования в Обзоре от ИИ связь слабая.
Averi, Indy Sanders, 23.04.2026 (EN); aeocontent.ai, 14.02.2026 (EN)
«Pages with a fact-to-word ratio above 1:80 are 4.2x more likely to be cited by ChatGPT, Perplexity, and Google AI Overviews.» Второй источник: выше 5 утверждений на 1000 слов.
Источник цифры 4,2 на странице не указан; методика и выборка не показаны.
Порог 1:80 (12,5 утверждения на 1000 слов) проходят 74,5% страниц топ-20 и 74,3% страниц ниже: с позицией в Google он не связан. Связь с цитированием в Обзоре от ИИ слабая, а цифра 4,2 без выборки не проверяема.
GEO Scout, 29.03.2026, обновлено 14.06.2026 (RU)
«Рекомендация: стремитесь к плотности 3-5 citable claims на 100 слов.»
Собственный мониторинг сервиса, выборка и метод не раскрыты; автор продаёт этот мониторинг.
Такую плотность (30 и больше на 1000 слов) имеют 20,9% страниц топ-20 и 20,4% страниц ниже. Связи с позицией нет; с цитированием в Обзоре от ИИ плотность связана слабо (1,10).
GEO Course, Карим Смуди, 22.06.2026 (RU)
«используйте минимум 15 именованных сущностей на 1000 слов». Плотность сущностей будто бы повышает шанс попасть в ответ ИИ в 4,8 раза.
Wellows, BrightEdge, Futurepedia, Princeton GEO — по названиям.
Не подтверждается: чем больше именованных сущностей на 1000 слов, тем реже цитирование: 0,84 (0,77–0,91) в Google. Порог 15 проходят 29% процитированных и 37% непроцитированных страниц.
Searchbloom, 06.05.2026 (EN)
«Information Gain … is the single highest-leverage content move we've measured … average 400% lift in blended Traditional & AI search visibility.»
Собственные замеры агентства; патент Google 2018 года.
Не подтверждается в такой постановке: доля триплетов, которых нет на других страницах запроса, не связана с более частым цитированием (0,97; 0,93–1,00), а в топ-20 она даже чуть ниже, чем ниже по выдаче (AUC 47,7).
Patrick Stox, 02.07.2026, и iNevidimka, 29.07.2026 (EN)
«neither Google nor Bing uses the term 'semantic triples' publicly, and no engine has confirmed a triples-specific ranking or AI-citation signal.» Второй источник: триплеты «not a confirmed Google ranking factor».
Разбор открытых источников; кейс HubSpot назван пакетом изменений без контролируемого теста.
Согласуется в части отсутствия подтверждённого специального сигнала. В обычной выдаче связи плотности с позицией нет; в Обзоре от ИИ Google плотность триплетов связана с цитированием слабо (1,10).
Google Search Central, руководство (анонс 15.05.2026) (EN)
«You don't need to write in a specific way just for generative AI search.» «There's no requirement to break your content into tiny pieces for AI to better understand it.» «Structured data isn't required for generative AI search…»
Официальная документация Google (дату анонса брал из сниппета; тексты цитат сверил по открытой странице руководства).
Согласуется в главном: особая форма текста под поиск Google не требуется. Данные не показывают положительной связи для цифры в начале и места фактов; плотность сущностей связана с цитированием отрицательно. Наблюдательный замер не доказывает необходимости особого формата.
Яндекс Вебмастер, справка про ЭПОС (RU)
«Поскольку генеративные ответы в Поиске и ответы Алисы AI в чате строятся с опорой на результаты поиска, принципиально новых требований не возникает.» «Содержательность можно определить как сочетание высокой плотности смыслов и полноты раскрытия темы…»
Официальная справка Яндекса (текст открыт и сверен; даты на странице нет).
Согласуется: «плотность смыслов» у Яндекса — критерий содержательности, а не счёт триплетов. Ранжирование Яндекса не измерялось, ответы Алисы AI измерены (раздел о цитировании).
Исследование под капотом
Здесь методика, полные таблицы, дополнительные проверки, повторение на новых запросах, точность извлечения и ограничения. Раскройте, если нужно проверить результат или повторить расчёт.
Показать исследование: все показатели, проверки, повтор, точность, методика
Данные: типичная страница топа, медианы и коридор
Медиана — значение посередине: половина страниц выше, половина ниже. Считаю по страницам выдачи (страница в выдаче одного запроса — одно наблюдение): 38 459 в топ-20 и 46 597 на позициях 21–50.
| Медиана страницы | Топ-20 | Позиции 21–50 |
|---|---|---|
| Слов в основном тексте | 772 | 658 |
| Триплетов на странице | 14 | 12 |
| Триплетов на 1000 слов | 19,5 | 19,2 |
Страницы топа длиннее (772 слова против 658) и дают больше триплетов (14 против 12), но плотность на тысячу слов у обеих групп почти одинакова (19,5 против 19,2). Поэтому число триплетов и плотность — разные показатели, и один нельзя подменять другим.
Медиана скрывает разброс. В топе уживаются страницы и с тремя триплетами на тысячу слов (край 10%), и с 34,5 (край 90%). Ниже край 10%, четверть ниже, середина, четверть выше и край 90% для 38 459 страниц топ-20.
Google, Москва, 02.10.2026. Полоса — средняя половина страниц топ-20, штрих — медиана, по краям значения 10% и 90%. В подписи справа — медиана позиций 21–50.
Данные: средний результат по 16 нишам
Среднее по всем нишам прячет различия. Сначала о том, что значит число. Возьмём общепит: 55,9 означает, что в 55 сравнениях из 100 страница из топ-20 содержит больше триплетов на тысячу слов, чем страница с позиций 21–50 по тому же запросу. Если верхняя и нижняя группы не различаются, показатель лежит около 50. В медианах разница такая: 18,4 триплета на тысячу слов у топа против 15,2 ниже; по всем нишам вместе медианы почти одинаковы, 19,5 и 19,2.
Все 16 ниш на одной шкале:
Плотность триплетов, около 150 запросов в каждой нише. Отметка «целиком» значит, что весь интервал лежит по одну сторону от 50.
Коридор плотности триплетов по нишам
Те же пять точек, что и для всех ниш вместе: край 10%, четверть ниже, медиана, четверть выше и край 90% для страниц топ-20. Справа медиана позиций 21–50 и оценка «из 100». Единица — страница в выдаче одного запроса: одна страница может попадать в несколько запросов.
| Ниша | Край 10% | Четверть ниже | Медиана топ-20 | Четверть выше | Край 90% | Медиана 21–50 | Оценка из 100 |
|---|---|---|---|---|---|---|---|
| Общепит | 0,3 | 7,5 | 18,4 | 26,7 | 35,7 | 15,2 | 55,9 |
| Красота | 4,9 | 12,7 | 20,6 | 27,9 | 35,7 | 19,2 | 53,6 |
| Образование | 0,0 | 8,6 | 16,4 | 26,8 | 36,3 | 15,7 | 53,4 |
| Спорт | 0,0 | 10,4 | 18,8 | 26,4 | 32,6 | 16,6 | 53,0 |
| Ремонт | 6,3 | 11,3 | 18,6 | 26,8 | 33,1 | 18,2 | 51,7 |
| Товары для дома | 0,0 | 10,0 | 19,4 | 26,5 | 33,7 | 19,1 | 51,6 |
| IT-услуги | 7,8 | 13,8 | 19,9 | 26,4 | 32,4 | 19,6 | 51,5 |
| Бытовая техника | 3,1 | 12,1 | 20,6 | 28,8 | 35,4 | 20,6 | 51,5 |
| Окна | 6,3 | 14,0 | 21,2 | 28,4 | 35,5 | 20,5 | 51,4 |
| Автосервис | 4,5 | 12,4 | 21,1 | 28,6 | 35,7 | 20,4 | 51,0 |
| Медицина | 7,1 | 14,8 | 22,3 | 29,1 | 36,5 | 22,1 | 50,2 |
| Юруслуги | 6,2 | 13,6 | 21,0 | 28,2 | 35,3 | 21,1 | 49,2 |
| Туризм | 0,0 | 5,6 | 15,7 | 23,5 | 32,0 | 15,7 | 48,9 |
| Стройматериалы | 2,5 | 11,5 | 20,3 | 26,7 | 33,7 | 20,5 | 48,5 |
| Недвижимость | 1,0 | 9,7 | 17,6 | 26,3 | 34,1 | 18,2 | 48,3 |
| Финансы | 6,5 | 13,2 | 19,2 | 24,9 | 32,8 | 19,6 | 46,8 |
Триплетов на 1000 слов. Это описание выдачи ниши, а не норматив для копирайтера.
Шесть ниш с примерами
Топ плотнее: медиана 18,4 триплета на 1000 слов против 15,2. На новых запросах повторились плотность и разнообразие объектов и связей; различия по числам, срокам и единицам измерения отдельно не подтвердились.
Пример. Запрос «доставка вкусной еды», 78 из 100. На 16-м месте nam-nyam.ru: 33 триплеты на 1000 слов («мы — работать — 20 лет», «сумма заказа — составлять — 4000 рублей»). Повтор на новых запросах: 54,6, интервал не включает 50.
Медиана 20,6 против 19,2. Выше плотность и разнообразие триплетов, а доли чисел, цен и сроков около 50.
Пример. «техник массажа спины», 92 из 100: 27,5 триплета на 1000 слов у топа против 7,2 ниже. Повтор на новых запросах: знак сохранился, но интервал включает 50 (50,6).
Медиана 16,4 против 15,7. Доля триплетов с числом ниже 50 (48,6).
Пример. «онлайн школа отзывы реальные», 80 из 100: 18,9 против 10,2. Повтор: 51,5, интервал включает 50.
Наоборот: у топа триплетов на тысячу слов меньше, 19,2 против 19,6. Доля триплетов с ценой чуть выше 50 (53,0).
Пример. «кредит наличными для ип», 26,5 из 100: 11,8 у топа против 22,6 ниже. Повтор: знак не воспроизвёлся (50,7), интервал включает 50.
Медиана 15,7 против 15,7. Зато выше доли триплетов со сроком (53,2) и с самоописанием «мы» (52,8).
Пример. «путевки все», 22,3 из 100: 6,6 у топа против 25,4 ниже. Повтор: знак не воспроизвёлся (50,1), интервал включает 50.
Медиана 20,3 против 20,5. Чуть выше только доля триплетов с единицей измерения (51,7).
Пример. «какие бывают виды утеплителей», 25,1 из 100: 19,2 против 29,5. Повтор: 47,5, интервал включает 50.
Примеры — запросы с самым сильным отклонением в нише среди запросов, где в каждой группе не меньше 8 страниц (скрипт niche_examples.py). Исключение: для общепита взят запрос «доставка вкусной еды» (78,1), он на 0,6 слабее максимального («рацион сервис», 78,2), но разобран на реальных страницах ниже. Один запрос ничего не доказывает, он показывает, как выглядит число.
Если бы связи не было, с каждой стороны ожидалось бы меньше одной ниши (около 0,4), а здесь пять и одна. Но интервалы по нишам, вероятно, занижены: сайты повторяются в разных запросах, а я этого не моделировал. Часть отклонений может быть шумом. Даже в общепите «55 из 100» значит, что в 45 сравнениях из 100 выше стоит менее плотная страница: для порога на одну страницу этого мало. Норматив не вводите и в этих нишах; действуйте по процедуре ниже.
Данные: разбор реальной страницы nam-nyam.ru
Запрос «доставка вкусной еды», Google, Москва, 2 октября 2026. Страница nam-nyam.ru стоит на 16-м месте. Сверяю её с коридором общепита. База карты: 2164 читаемые страницы топ-20 общепита по всем запросам ниши (один URL может повторяться), включая 214 страниц без триплетов, поэтому края 10% для триплетов и плотности равны нулю; доли с числом, сроком и ценой считаются только по 955 страницам, где триплетов не меньше 10.
По карте страница в верхней четверти по числу триплетов и плотности (33,4 на 1000 слов при крае 90% в 35,7), а по долям чисел, сроков и цен за краем топа общепита. Но высокое значение не равно качественному раскрытию. Вот первые 8 из 33 триплетов страницы и их проверка по исходному предложению (метки выставила языковая модель, Claude):
| Триплет, как её выписали правила | Проверка | Что не так |
|---|---|---|
| сумма заказа — составлять — 4000 рублей | частично | Потеряно слово «минимальная» |
| 1 бонус — дарить — 1000 бонусов | неверно | В тексте «Мы дарим 1000 бонусов…»; субъект подменён соседним «1 бонус = 1 рубль» |
| 1 бонус — дарить — 1 рубль | неверно | Обломок формулы «1 бонус = 1 рубль», а не действие |
| Качество — заниматься — временем | неверно | Заголовок «Качество, проверенное временем!» склеился с предложением |
| Качество — заниматься — 20 лет | неверно | Субъект «мы»: «Уже более 20 лет мы занимаемся доставкой вкусной еды» |
| Качество — заниматься — доставкой вкусной еды | неверно | Субъект подменён заголовком; суть («занимаемся доставкой вкусной еды») угадывается только из исходника |
| служба доставкиАвтопарк — состоять — из более 30 специализированных автомобилей | частично | Заголовок «Своя служба доставки» склеен с предложением |
| мы — работать — 20 лет | частично | Потеряно «более» |
Метки выставила языковая модель по исходному предложению; выборка — первые 8 триплетов, не случайная. Подмена субъекта заголовком относится к неверным триплетам, как в рубрике во второй статье.
Для плотности. Высокая плотность могла получиться из-за склеенных заголовков и дублей одного факта. Правило: плотность выше края 90% или ниже края 10% — повод сначала проверить извлечение (склейки заголовков, таблицы, дубли), а страницу не трогать.
Для аудита. Из карты берите цитаты страницы, а не триплеты алгоритма: «Мы работаем более 20 лет […]», «Минимальная сумма заказа составляет 4000 рублей», «Автопарк состоит из более чем 30 специализированных автомобилей».
Данные: полнота ответа и число утверждений
Первая версия замера оценивала только триплеты алгоритма. Чтобы подойти ближе к тому, что нужно читателю, я добавил два показателя на той же выдаче Google (Москва, 2 октября 2026). Протокол записан до расчёта. Выборка: 120 запросов (7–9 на нишу), до шести страниц из топ-20 и до шести с позиций 21–50 на запрос, всего 1436 страниц (первые 2500 слов, без агрегаторов). Для каждого запроса модель заранее, не видя страниц, написала шесть вопросов покупателя: цена и от чего она зависит, срок или порядок, условия и ограничения, подтверждения, состав или характеристики, доверие. Затем Claude Sonnet по каждой странице оценил, отвечает ли она на каждый вопрос (2 — прямой ответ, 1 — частичный, 0 — нет), и перечислил проверяемые утверждения. Группу страницы (топ-20 или ниже) судья не знал.
Полнота ответа. Страница из топ-20 в среднем прямо отвечает на 1,5 вопроса из 6 и хотя бы частично затрагивает 3,6; страница с позиций 21–50 — на 1,4 и 3,3 (медиана в обеих группах: 1 прямой ответ и 4 затронутых вопроса). Ни на один вопрос не отвечает 9% страниц топа и 12% страниц ниже; на 5–6 вопросов из 6 отвечает 37% страниц топа и 30% нижних; на 3 и больше вопросов прямо отвечает 27% против 23%. В сравнениях «топ против низа» это 54,0 из 100 (51,0–57,1), выше случайного. Но страницы топа длиннее (в среднем 991 слово против 940 в пределах первых 2500), и длина сама даёт похожий сдвиг: 53,4 (50,6–56,3). Если сравнивать страницы, у которых число слов различается не больше чем на 20%, полнота 53,5, но интервал (48,9–57,9) включает 50, а прямых ответов 49,7. Вывод: небольшое преимущество топа по полноте есть, отделить его от длины текста этой выборкой нельзя.
Число утверждений. На 1000 слов поровну: 22,2 в обеих группах, оценка 48,3 (45,1–51,6). Страницы топа не плотнее проверяемыми фактами. Но сам показатель ненадёжен: второй судья (Codex) насчитал втрое больше утверждений (медиана 36 против 14 у Sonnet), корреляция по странице всего 0,53. Для сравнения групп годится только тенденция внутри одного судьи; нормативом в ТЗ его делать нельзя.
Надёжность оценки полноты. На 143 страницах (10% выборки) оценки Sonnet и Codex совпали в 80,5% ответов (каппа 0,70, взвешенная 0,84), корреляция полноты по странице 0,89. Это достаточно, чтобы доверять сравнению групп, но не достаточно, чтобы выдавать оценку модели за суждение читателя.
Вопросы придумала модель, а не покупатели; оценку ответа ставила модель, а не человек; читалась только Москва, Google и первые 2500 слов страницы. Разрез по нишам (в среднем 7–9 запросов на нишу) даёт разброс от 45,0 до 65,4 и выводов не допускает. Причинности это не показывает: страница могла закрывать больше вопросов потому, что она длиннее или старше, а не потому, что она в топе.
Два запроса-крайности и разброс по запросам
Начну с двух запросов, где картина самая выразительная. По запросу «без договора» (Google, Москва, 2 октября 2026 года) на третьем месте стоит КонсультантПлюс: около тысячи слов, девять извлечённых триплетов. На девятом месте страница a-sstroy.ru: около 1440 слов и 55 триплетов.
триплетов на 1000 слов
consultant.ru
триплетов на 1000 слов
a-sstroy.ru
По всей выдаче этого запроса так же. Медианная плотность на первых двадцати местах 18,2 триплета на тысячу слов, на местах 21–46 — 27,5. Если взять два случайных результата, один из топ-20, другой ниже, плотнее оказывается верхний лишь в 35 случаях из 100.
По запросу «техник массажа спины» всё наоборот: медианная плотность в топ-20 27,5 триплета на тысячу слов, ниже 7,2, и верхняя страница плотнее в 92 случаях из 100. Один запрос ничего не доказывает ни в одну сторону.
Доля сравнений «топ-20 плотнее», плотность триплетов на 1000 слов. Шкала здесь 0–100, поэтому отклонение среднего от 50 почти не видно. Показатель по запросам: медиана 50,8, у 15,5% запросов ниже 40, у 21% выше 60.
Поэтому дальше я проверяю то же на 2378 запросах (для долей с числом, ценой и подобных страниц хватило у 2052).
Девять показателей с интервалами
| Что считал | Топ-20 выше, из 100 | Интервал |
|---|---|---|
| Триплетов на 1000 слов | 51,0 | 50,6–51,5 |
| Триплетов с объектом действия на 1000 слов | 50,6 | 50,1–51,0 |
| Разных объектов на 1000 слов | 50,7 | 50,2–51,1 |
| Разных глаголов-связей на 1000 слов | 50,8 | 50,4–51,3 |
| Доля триплетов с числом | 49,8 | 49,3–50,4 |
| Доля с ценой | 50,3 | 50,0–50,6 |
| Доля со сроком | 50,0 | 49,5–50,5 |
| Доля с единицей измерения | 50,3 | 49,9–50,6 |
| Доля «мы» (сайт говорит о себе) | 50,4 | 49,9–50,9 |
Интервал показывает, как сильно число гуляло бы при другой выборке запросов. Границу 49–51 я выбрал до расчёта как зону практически малого среднего эффекта. Если интервал целиком лежит внутри неё, связь практически нулевая. Это не доказательство полного отсутствия связи, а оценка её размера.
С поправкой на число проверок (девять показателей сразу: случайные «открытия» при таком числе вероятны) от случайности отличаются четыре показателя про плотность и разнообразие (скорректированное p от 0,002 до 0,025), все выше 50 примерно на один пункт. Пять показателей про состав от случайности не отличаются. Подробности в разделе «Как это считалось».
Средние значения по полосам позиций показывают то же без статистики. Среди триплетов страниц на местах 1–3 числа содержат около 5,2%, цены — 0,6%, сроки — 2,2%. На местах 31–50: числа 5,4%, цены 0,7%, сроки 2,2%.
В среднем по 2378 запросам страницы топа богаче триплетами лишь на один пункт из ста (плотность 51,0), а по составу (числа, цены, сроки) не отличаются от страниц ниже. В отдельных нишах картина другая (см. раздел о нишах).
Мог ли результат получиться из-за ошибок измерения
Маленькую разницу легко получить или потерять из-за ошибки в расчёте или шума. Поэтому я проверял результат несколькими способами.
Видит ли измеритель настоящую разницу? Те же 2378 запросов, те же сравнения, но другой признак: длина текста. Здесь верх выдачи заметно отличается. Ещё один контроль — ссылочный профиль сайта: число ссылающихся доменов по данным Keys.so.
Тот же метод, те же сравнения; это проверка поведения расчёта, не точности извлечения. Длина текста: 54,5 (54,1–55,0); ссылающиеся домены: 54,0 (53,5–54,6). Ссылочный профиль найден у 18 309 из 24 416 сайтов.
Что, если добавить эффект искусственно? Я увеличил у страниц топ-20 уже измеренную плотность триплетов на 3, 5 и 10% и пересчитал тот же показатель. Эту проверку я придумал после основного результата, поэтому считаю её разведкой, а не заранее записанным критерием.
Для доли триплетов с числом, показателя более шумного, добавка +10% поднимает оценку до 51,4 (интервал 50,9–52,0).
Это показывает чувствительность расчёта к изменению признака. Гарантией обнаружения трёхпроцентного различия в числе настоящих фактов она не служит: я менял цифры после разбора, а не сами тексты.
Другие проверки устойчивости. Разница уменьшается: без агрегаторов и на страницах одной длины плотность даёт 50,6 (50,1–51,1) и 50,3 (49,8–50,8), а учёт длины и ссылок сводит связь к нулю (интервалы отдельных показателей при этом доходят до 51,4):
Без агрегаторов
Убрал 94 сайта (YouTube, Ozon, Яндекс.Маркет, Профи.ру, Википедия и подобные: сайт встречается минимум в 40 запросах и не менее чем в шести нишах), 22,9% позиций
50,0–50,6
Страницы одной длины
Оставил сравнения, где число слов различается не более чем на 20%
49,7–50,7 (интервалы доли «мы» и разнообразия связей доходят до 51,4 и 51,1)
Учёт сайта и длины
Модель: попадает ли страница в топ-20 в зависимости от показателя, длины текста и ссылочного профиля сайта
для плотности связи нет (×1,00); заметны плотность с объектом действия (×1,05) и доля «мы» (×1,07)
В модели длина и ссылки дают ожидаемый знак: шансы попасть в топ выше у более длинных страниц и у сайтов с большим числом ссылающихся доменов. В этой модели плотность и разнообразие триплетов не дали связи сверх длины и ссылок. Без поправки на множественность заметны плотность с объектом действия и доля «мы»; цифры в разделе «Как это считалось».
Как результат меняется после дополнительных проверок
Картина неоднородная. Плотность триплетов чуть выше 50, грубые счётчики (числа и слова с заглавной) чуть ниже, а поправка на точность алгоритма тянет плотность вниз.
Все значения — доля сравнений, где выше страница топ-20. Грубые счётчики: 49,0 числовых токенов, 48,0 слов с заглавной; интервалы целиком ниже 50, p после поправки около 0,0008. Дозагрузка закрытых страниц в браузере поднимает плотность с 50,1 до 51,0.
Страницы наверху богаче числами и названиями
Чуть беднее. Чисел на тысячу слов 34,1 у топ-20 и 36,3 ниже, слов с заглавной 19,7 и 21,3
Грубые счётчики не зависят от моего алгоритма: это числа в тексте и слова с заглавной буквы не в начале предложения (медианы указаны выше). Сами счётчики я определил заранее. Их разрезы посчитаны уже после результата, так что это разведка: без агрегаторов сдвиг уменьшается (48,6–49,8), для сравнений близкой длины остаётся (48,4–49,1). Причину сдвига не знаю. Возможно, страницы-каталоги и справочники, перегруженные числами и названиями, ранжируются ниже; это гипотеза.
Поправка на точность работает так. Мой алгоритм ошибается, причём чуть чаще на страницах топ-20. Если пересчитать плотность на приемлемые триплеты, оценка опускается. «Надёжным» я называю подмножество триплетов тех типов, где алгоритм ошибается реже всего: прямое дополнение с числом, сроком или иным объектом и конструкции «у нас есть X».
| Какая точность | Топ-20 | Позиции 21–50 | Плотность после поправки |
|---|---|---|---|
| Верно или приблизительно верно (мягкая) | 0,782 | 0,800 | 49,5–50,0 |
| Только полностью верно (строгая) | 0,433 | 0,457 | 48,0–48,7 |
| «Надёжное» подмножество, мягкая | 0,769 | 0,841 | 47,3–47,6 |
Диапазоны охватывают общую плотность триплетов, плотность записей с объектом действия, разнообразие объектов и разнообразие связей. Расчёт приближённый: значения нижней группы умножены на отношение точностей. Точность оценена по небольшой выборке, интервалы пересекаются.
Это оценка чувствительности, а не поправленный результат: основной результат (51,0) дан без поправки. Точность алгоритма оценена по началу страниц, поэтому поправка приблизительна; строгая точность сильнее зависит от судьи (в статье про извлечение это видно на модели Haiku).
Частичное повторение на новых запросах
Выдачу по 392 новым запросам я собрал 3 октября 2026 (основной замер — 2 октября) (по 25 на нишу, в «стройматериалах» нашлось только 17 подходящих) и прогнал тот же расчёт без изменений: 17 026 позиций, 13 342 прочитанные страницы выдачи (78%). В расчёт вошли 387 запросов для плотности и 327 для долей.
| Показатель | Основной замер | Повтор | Интервал повтора |
|---|---|---|---|
| Триплетов на 1000 слов | 51,0 | 50,3 | 49,3–51,3 |
| Триплетов с объектом действия на 1000 слов | 50,6 | 50,5 | 49,4–51,6 |
| Разных объектов | 50,7 | 49,9 | 48,8–50,9 |
| Разных глаголов-связей | 50,8 | 50,0 | 49,0–51,1 |
| Доля с числом | 49,8 | 50,5 | 49,0–52,0 |
| Доля с ценой | 50,3 | 50,1 | 49,4–50,8 |
| Доля со сроком | 50,0 | 49,6 | 48,3–50,8 |
| Доля с единицей | 50,3 | 51,0 | 50,2–51,9 |
| Доля «мы» | 50,4 | 50,6 | 49,2–51,9 |
Критерий повторения я записал заранее: интервалы пересекаются и оба либо задевают зону 49–51, либо исключают 50 в одну сторону, не менее чем у семи показателей из девяти. Он выполнен у всех девяти. Оговорки: выборка в шесть раз меньше основной, интервалы в среднем в 2,5 раза шире (2,2 пункта вместо 0,9), и целиком между 49 и 51 лежит лишь один (доля цены). К тому же 39% страниц повтора взяты из кеша основной выдачи, так что независимость неполная. По моей оценке, критерий выполнился бы и при реальном превосходстве топа около 5% (53,4 по шкале выше), поэтому повторение отличает результат от нуля только при крупных эффектах. Оно согласуется с основным результатом, но само по себе его не доказывает.
Насколько точны извлечённые триплеты
Всё выше я посчитал по триплетам, которые извлекает мой алгоритм. Насколько они верны, я проверил на отдельной выборке в 3154 триплеты. Каждую оценила языковая модель Claude Sonnet, не зная позиции страницы; 630 триплетов независимо оценил Claude Opus. Цифры взвешены по стратам пилота и относятся к его триплетам, не к основному корпусу. Пилот брался из начала страниц (экстрактор тогда видел первые 12 000 символов), поэтому для хвостов длинных страниц точность отдельно не оценивалась.
триплетов передают предложение точно (интервал 42,1–47,4%)
триплетов верны или приблизительно верны (интервал 76,9–81,5%)
триплетов сделаны из предложений, где проверяемого утверждения нет
Чаще всего обрезается объект триплеты, в том числе теряется условие. Пример со страницы КонсультантПлюс: «Если работник приступил к выполнению работ даже без заключения договора, это свидетельствует о возникновении трудовых отношений». Алгоритм записал так:
В тексте был союз «если»: это условие, а триплет читается как сообщение о состоявшемся событии.
На другой выборке, 400 случайных предложениях, строго верна лишь четверть триплетов (26%, интервал 20–34%). Выборки устроены по-разному: в первой триплета взвешены по типам, во второй предложения случайные. Поэтому приведены обе цифры, и сравнивать их друг с другом нельзя.
Для сравнения групп страниц эта неточность не так важна, если ошибается алгоритм одинаково на верхе и на низе. Строгая точность там почти одна: 43,3% в топ-20 и 45,7% ниже. Но при поправке на неё результат сдвигается вниз, как показано выше, поэтому я не называю разницу ни доказанным плюсом, ни доказанным нулём. Подробно о том, как устроена проверка качества извлечения, в статье про триплеты и методику оценки.
Полнота правил ещё ниже: на 400 предложениях они нашли 5% фактов строго и 18% мягко (подробнее в статье про извлечение триплетов). Поэтому замер говорит о плотности триплетов этих правил, а не о числе фактов на странице.
Совпадают ли факты на разных сайтах
В плане исследования было ещё три гипотезы: страницы, чьи факты подтверждают соседи по выдаче («консенсус»), чаще стоят в топ-20; страницы с уникальными фактами тоже; а консенсус даёт информацию сверх охвата темы. Чтобы проверить их, нужно понимать, когда два триплета на разных сайтах говорят об одном и том же. Я пробовал три способа:
- Совпадение начальных форм слов субъекта, связи и объекта. На пилоте из 100 запросов совпадение хотя бы между двумя сайтами нашлось у 2,1% сочетаний «субъект — связь — объект».
- Сравнение триплетов числовыми отпечатками смысла фразы (модель e5). На 450 парах, размеченных вслепую двумя моделями, «то же утверждение» поставили 11 и 13 раз из 450, ни одного ниже косинусной близости 0,90. Среди самых близких пар (0,94 и выше) совпадали 10 и 12 из 90.
- Сравнение целых предложений при строгом пороге близости 0,97. На отложенной разметке доля подтверждённых совпадений 0,69 (интервал 0,52–0,85, 29 пар), но на 200 контрольных запросах три других сайта подтвердили предложение лишь у 29 из 80 334 (0,036%).
Из этого не следует, что общих фактов на сайтах нет. Следует, что связка «автоматическое извлечение, числовой отпечаток и порог близости» в проверенной конфигурации измеримого сигнала не дала. Три способа сопоставления почти не находят совпадений, поэтому доля общих и уникальных утверждений проверена другим путём: через долю новых триплетов страницы (раздел о цитировании).
Повтор по нишам
В повторе знак сохранился у общепита (54,6), красоты (50,6), образования (51,5) и стройматериалов (47,5), но интервал не включает 50 только у общепита. У финансов (50,7) и туризма (50,1) знак не воспроизвёлся. Поэтому результат по нишам — разведка.
Насколько можно опираться на выводы
Преимущество топ-20 по плотности триплетов около одного пункта из ста и исчезает при учёте длины
Основной анализ на 2378 запросах; повтор по плотности на 387 новых запросах согласуется, но отличает только крупные эффекты
Качество извлечения (хвосты длинных страниц не проверялись) и пятая часть непрочитанных позиций
Знак результата различается по нишам
Разрезы по 16 нишам
Интервалы, вероятно, занижены из-за повторяющихся сайтов; разведка
Небольшой сдвиг к нижним позициям у чисел и слов с заглавной
Грубые счётчики, не зависящие от извлечения
Часть разрезов посчитана после результата
Извлечение моими правилами неточно
3154 триплеты, оценка модели
Судьи двух семейств (Claude и Codex), согласие умеренное
Независимая перепроверка результата
Чтобы исключить ошибку в собственном расчёте, плотность триплетов пересчитана другим кодом (критерий Манна — Уитни вместо моей библиотеки) на тех же 84 848 пригодных парах «запрос — страница» и другим способом сравнения. В основной контраст вошли 2378 из 2400 запросов. Результат тот же:
- топ-20 против позиций 21–50: 51,0 из 100 (50,6–51,5), как и в основном расчёте (2378 запросов, минимум четыре страницы в каждой группе);
- крайности, топ-3 против позиций 41–50: 50,8 (49,6–52,0); топ-10 против 11–20: 51,4 (50,7–52,0); число триплетов (не плотность) у топ-20 против 21–50: 53,8;
- корреляция Спирмена «позиция — плотность» внутри запроса: −0,019 (−0,026…−0,011); медианная плотность по группам позиций колеблется от 19,1 до 20,1 триплета на 1000 слов, максимум на местах 4–5, минимум на первом месте;
- контроль на тех же данных: число слов даёт 54,5 для топ-20 против 21–50 (в основном расчёте 54,6) и 57,1 для топ-3 против 41–50. То есть расчёт видит различие там, где оно есть.
Вручную просмотрено восемь случайных страниц (по четыре из каждой группы). Число слов в таблице признаков совпало с числом слов извлечённого текста у всех восьми. У шести страниц с триплетами я прочитал по пять триплетов рядом с исходными предложениями: большинство передаёт смысл («автомобиль — терять — глубину цвета», «мы — не ограничиваться — чтением ошибок»), но есть и дефекты, о которых говорит раздел про точность: одно предложение даёт три одинаковые триплеты («врач — не дать — иные рекомендации»), встречаются перекрученные («ширина Хрущёвского — сделать — балкона») и обрывки («80 лет — исполниться — в сентябре»). Плотность определяется стилем и типом страницы: в корпусе край 10% для страниц топ-20 лежит на 3,2 триплета на 1000 слов, а край 90% на 34,5, то есть разброс между страницами в десять раз больше любого различия между топом и низом (медианы 19,5 и 19,2). Привязку страниц к запросам проверил по сырой выдаче: имя файла совпадает с хешем запроса, на первой странице выдачи 80% результатов содержат основы слов запроса, на страницах 2–5 70–73%; у размытых запросов вторая страница выдачи может уходить в сторону (в примере по запросу про билеты там оказалась статья Forbes про пенсии), но систематической порчи нет. Число утверждений, насчитанное моделью вместо правил, тоже ничего не различает (48,3), так что вывод об отсутствии оснований для единого норматива не зависит от способа извлечения.
Как считались дополнительные измерения
Выборка. Запросы с не менее чем восемью читаемыми страницами в каждой группе (топ-20 и позиции 21–50), без пилотных и повторных запросов и без доменов-агрегаторов; 7 запросов на нишу и добор до 120 (seed 20261004). На запрос случайно до шести страниц из каждой группы; берутся первые 2500 слов основного текста. Итого 1436 страниц с оценкой (четыре страницы короче 100 слов исключены). Отдельные 12 запросов (36 страниц) использованы только для оценки стоимости пилота и в результат не входят.
Вопросы и судья. Шесть вопросов на запрос написаны моделью по тексту запроса и ниши, без доступа к страницам; файл вопросов заморожен до оценки страниц (начало SHA-256: 7c2ea86226f59f49). Судья — Claude Sonnet, пакеты по 12 страниц вперемешку по запросам и группам; о группе страницы он не знал. Шкала: 2 — прямой ответ, 1 — частичный, 0 — ответа нет. Полнота страницы = (число оценок 2 + 0,5 × число оценок 1) / 6. Проверяемые утверждения судья перечислял по определению: значение, срок, условие, ограничение, подтверждение или конкретное свойство, без повторов.
Расчёт. Сколько раз из 100 страница из топ-20 выигрывает у страницы с позиций 21–50 того же запроса, равенство наполовину, среднее по запросам, интервал — бутстреп по запросам (10 000, seed 20261010). Контроли в той же выборке: число слов (до 2500) и плотность триплетов алгоритма; отдельно сравнения, где число слов различается не более чем на 20%. Основной вывод только по полноте ответа, остальное вторичное, без поправки на множественность.
Надёжность. Второй судья — Codex, 144 случайные страницы (10%, seed 20261011), 143 с полным ответом. Согласие по оценкам 0/1/2: 80,5%, каппа 0,70, взвешенная 0,84. Число утверждений у Codex в среднем втрое больше (медиана 36 против 14), корреляция 0,53.
Отступления от протокола. Взято до шести страниц на группу вместо десяти и первые 2500 слов вместо 4000 (стоимость); решение принято до запуска судьи. Протокол и сводка результатов: файлы MEASURE_R2_PROTOCOL.md и RESULTS_R2.md.
Как это считалось
Запросы. 2400 запросов, по 150 на каждую из 16 ниш. 160 остались от предыдущего замера, 31 из пилота, остальные новые. Источники: Wordstat, расширение фраз Keys.so и фразы тематических сайтов из базы Keys.so (Google, Москва). Фильтры: порог базовой частотности 100 по Wordstat (это спрос в Яндексе, а не в Google), без латиницы, чужих городов, имён, навигации и обрывков; запросы одной ниши с близкими формулировками (коэффициент Жаккара по начальным формам слов не ниже 0,6) в список не брались. Из 153 889 сырых фраз осталось 30 478 кандидатов. Список зафиксирован до сбора выдачи. В нём есть широкие запросы вроде «пылесос лучший» и неоднозначные формулировки.
Выдача и страницы. Сервис XMLRiver, Google, Москва, десктоп, до 50 позиций, 2 октября 2026. Тексты скачаны обычным HTTP-запросом, основной текст выделен библиотекой trafilatura. Закрытые для обычного запроса страницы (заглушки, проверки на бота) открывались браузером, который не выдаёт себя за робота: одна попытка на страницу, капча не обходилась. Из 15 344 таких страниц получить текст удалось у 15 033, и доля прочитанных страниц выросла с 68,3% до 79,4% (80,3% в топ-20 и 78,7% ниже). В расчёт не входят два вида страниц: те, чей текст получить не удалось, и те, где текст получен, но короче 100 слов. Пропуск не означает, что фактов нет.
Извлечение. Правила поверх разбора Natasha (библиотека синтаксического разбора русского языка): глагол с подлежащим и дополнением, конструкции «X — это Y» и «у нас есть X». Правил я не менял после просмотра связи с позициями. Исправление от 4 октября 2026: в первой версии расчёта программа разбирала только первые 12 000 символов страницы, а слова считались по всему тексту, и плотность длинных страниц занижалась (затронуто 20,8% пар «запрос — страница»). Я переобработал страницы целиком и пересчитал все числа в статье; прежний результат был 50,2 (49,8–50,7). Окончательная версия (в статье везде она) делит длинные тексты на куски по границам предложений и считает слова в том же очищенном тексте, из которого извлекались триплеты. Промежуточная версия, где куски резались по абзацу или пробелу, а слова считались по фрагментам между пробелами, дала 50,9 (50,5–51,4): способ выбран ради корректности измерения (числитель и знаменатель относятся к одному очищенному тексту), а не ради результата: итог сместился на 0,1 пункта, и на выводы это не влияет.
Точность разбора. 3154 триплеты, стратифицированная выборка из пилота (37 групп, 100 запросов). Каждый триплет прочитал Claude Sonnet, не зная позиции; 630 триплетов прочитал второй читатель, Claude Opus (он строже: 0,71 против 0,77 по мягкой точности). Причины неточных триплетов из 1626 с меткой «приблизительно» или «неверно»: обрезанный объект (1054), потерянное число (213), перепутанные роли (159), расплывчатое подлежащее (117), потерянное отрицание (41). Согласие двух читателей-моделей неполное (коэффициент Коэна, мера согласия двух разметчиков с поправкой на случайные совпадения, 0,43 по четырём классам). Оценки зависят от разметчика, а интервалы не включают возможное систематическое смещение модельной разметки. На доле «обстоятельство» точность в топ-20 ниже (0,372 против 0,430); это единичное различие без поправки на множественные сравнения.
Статистика. Гипотезы и метрики записаны до расчёта. Единица анализа — запрос. Для каждого запроса с четырьмя и более читаемыми страницами в каждой группе считалась доля сравнений, где верхняя страница лучше (ничьи пополам), затем среднее по запросам. Интервал — бутстреп по запросам (5000 повторов), проверка случайности — перестановка меток внутри запроса (5000 повторов), поправка Холма на девять показателей (скорректированное p-значение 0,002 у плотности и разнообразия связей, 0,01 у разнообразия объектов, 0,025 у плотности с объектом действия и больше 0,17 у остальных пяти). В модели с учётом длины текста и ссылочного профиля отношение шансов на одно стандартное отклонение показателя 0,96–1,07; для плотности и разнообразия триплетов связи нет (1,00–1,02), кроме плотности с объектом действия (1,05, p = 0,006); из показателей про состав без поправки на множественность заметна доля «мы» (1,07, p = 0,007), доли чисел и сроков на границе (0,96, p около 0,09); для длины текста отношение шансов 1,12–1,21, для ссылающихся доменов 1,05–1,07. Интервалы отражают разброс состава запросов; сайты, повторяющиеся в разных запросах, дают отдельный источник зависимости, который процедура явно не моделирует. Для долей в сравнение вошли 2052 запроса, для остальных 2378: у страницы должно быть не менее 10 триплетов.
Данные и код. Данные и препринт планирую выложить на Zenodo; сейчас они не опубликованы.
Частые вопросы
Нет. В основном сравнении плотность автоматических записей дала 51,03 из 100 (95% интервал 50,61–51,45). У страниц близкой длины оценка — 50,32 (49,81–50,82): интервал включает равный уровень 50. В модели с поправкой на длину и ссылки отношение шансов составило 1,000 (0,964–1,038). Поэтому устойчивого преимущества, независимого от длины страницы, не обнаружено; универсального норматива эти данные не задают.
Семантический триплет — запись утверждения в форме «субъект → связь (предикат) → объект». Объектом может быть другая сущность или значение. Например: «Apple → производит → iPhone». В исследовании алгоритм использовал более широкий рабочий формат и иногда помещал в третье поле срок или частоту; это автоматически извлечённые кандидаты, а не подтверждённые факты.
Нет. Плотность триплетов, которые извлёк мой алгоритм, почти не отличает верх выдачи от низа (51,0 из 100); нужны ли посетителю факты, она не показывает.
Сравнить свою страницу с 3–5 лидерами по вопросам покупателя: цена и от чего зависит, срок и что его меняет, гарантия и кто её даёт. Для каждого пробела решить, нужна ли эта информация вашему предложению и чем вы её подтвердите. Результат — список обоснованных правок, а не новое число.
Типичная (серединная по списку) страница топ-20 содержит 772 слова и 14 триплетов, в позициях 21–50 658 слов и 12 триплетов. В первой десятке на странице целиком 15 триплетов (ТОП1, ТОП3, ТОП5 и ТОП10 дают одно и то же число). На тысячу слов это 19,5 и 19,2 триплета, поэтому число триплетов и плотность — разные показатели. Это описание выдачи, а не норматив.
В этих выборках обнаружена слабая положительная связь. При увеличении плотности на одно стандартное отклонение отношение шансов цитирования составило ×1,10 (95% интервал 1,06–1,13) для Google и ×1,16 (95% интервал 1,08–1,24) для Алисы AI. Модели учитывали позицию в выдаче и длину текста; для Google дополнительно учитывалось число ссылающихся доменов. Это множитель шансов, а не рост вероятности и не доказанный эффект правки страницы. В «Обзоре от ИИ» процитировано 60% страниц с позиций 1–3 и 1,8% страниц с позиций 21–50: в этой выборке позиция сильно связана с цитированием, но не доказана как обязательное условие.
Пробовал три способа: сравнение по начальным формам слов, сравнение по смыслу (числовые «отпечатки» фраз) и сравнение целых предложений. Сравнение целых предложений нашло подтверждение тремя другими сайтами у 0,036% предложений. Три способа строгого сопоставления одинаковых утверждений измеримого сигнала не дали. Отдельно проверен более грубый показатель новизны (доля триплетов, которых нет на других страницах запроса); он не равен сопоставлению фактов.
Частично. Алгоритм и параметры описаны в разделе «Как это считалось», методика извлечения и проверки качества — в отдельной статье. Данные и код пока не опубликованы.
Связь триплетов с органическими позициями Яндекса не проверялась: основной замер сделан для Google, Москва, десктоп, на один день. Для цитирования в Алисе AI плотность триплетов посчитана на 6031 странице 357 запросов: шансы выше в 1,16 раза на типичный разброс плотности (диапазон 1,08–1,24), а среди страниц органического топ-10 в 1,09 раза (1,01–1,18). Как и в Google, связь слабая. Новизна и положение триплетов для Алисы тоже посчитаны: доля новых триплетов ×1,06 (0,99–1,13), доля триплетов в последней пятой части текста ×0,88 (0,82–0,95); остальные четыре показателя положения без связи. Связи слабые.
Немного: в выборке из 120 запросов страница топ-20 прямо отвечала в среднем на 1,5 вопроса покупателя из 6, страница с позиций 21–50 — на 1,4. В 54 сравнениях из 100 топ выигрывал по полноте (интервал 51,0–57,1), но длина текста давала похожее значение — 53,4. Для страниц близкой длины интервал широкий (48,9–57,9) и включает 50; этой выборки недостаточно, чтобы отделить преимущество по полноте от длины текста. Вопросы придумала модель, ответы оценивала модель; это наблюдение, а не эксперимент.
Убедительной связи для полного набора признаков не обнаружено, но это не доказывает отсутствие влияния: такой абзац был лишь у 1,2% страниц; оценка Google — ×1,18 (0,87–1,60), Яндекса — ×1,06 (0,53–2,09), оба интервала включают ×1. Отдельно проверялись три признака: длина 40–100 слов — ×1,14 в Google и ×1,19 в Яндексе; определение в первом предложении — ×1,20 и ×1,32; понятность без остального текста — ×1,24 и ×1,34. Совместный эффект этих трёх признаков без цифры не оценивался — это не готовая формула для текста.
Взять 20–30 запросов (половину по изменённым страницам, половину по похожим неизменённым), зафиксировать систему, регион и устройство и сделать минимум три прогона в разные дни до правок, через 4 и 8 недель. По каждому ответу записывать ссылки в порядке показа, наличие вашего адреса и упоминание бренда без ссылки. Затем сравнить долю запросов с вашей страницей в изменённой и контрольной группах.
Разобрать вашу страницу по ответам на вопросы покупателя
Если нужно понять, каких ответов не хватает вашей странице по сравнению с лидерами выдачи, это SEO-аудит сайта. Как извлекать утверждения из текста и проверять их, разобрано в статье про извлечение триплетов.