По запросу «как получить справку о неполучении налогового вычета» на первом месте в выдаче Google стоит страница сайта ФНС на 244 слова. На втором месте статья на 625 слов, а под ней ещё 1 673 слова комментариев читателей. Всего на странице 3 496 слов.
Что из этого Google считает основным контентом страницы? С октября у него есть письменный ответ. Справка Google о полезном контенте называет качество основного контента одним из самых критичных факторов при оценке страницы, перечисляет, что в него входит, и описывает, по каким четырём признакам его оценивают живые асессоры. Это усилие, оригинальность, мастерство и точность.
У меня есть корпус из 2 400 запросов и 84 848 результатов выдачи Google, то есть 50 948 уникальных адресов (часть адресов стоит в выдачах нескольких запросов). Я проверил, различаются ли по этим признакам страницы первых двадцати мест и страницы позиций 21–50. Ниже я собрал то, на что можно опереться при разговоре с клиентом или командой. Это числа с границами, сайты с открытыми данными и способ повторить проверку на своих запросах.
- Выборка
- 84 848 результатов выдачи, 50 948 уникальных адресов
- Запросы
- 2400, шестнадцать ниш
- Группы
- топ-20 против позиций 21–50
- Регион
- Москва, google.ru, десктоп
- Дата съёма
- 02.10.2026, середина спам-апдейта
- Признаки
- шесть: списки, таблицы, числа, повторы, новые утверждения, доля основного текста
- Сравнение
- цитируемые «Обзором от ИИ»: 1141 запрос
- Проверка
- доли основного текста: 300 запросов, ручной аудит классификатора
- Ссылочное и возраст
- DR Ahrefs для 3000 доменов (71% результатов), регистрация по реестру зон, история Wayback
Короткий ответ
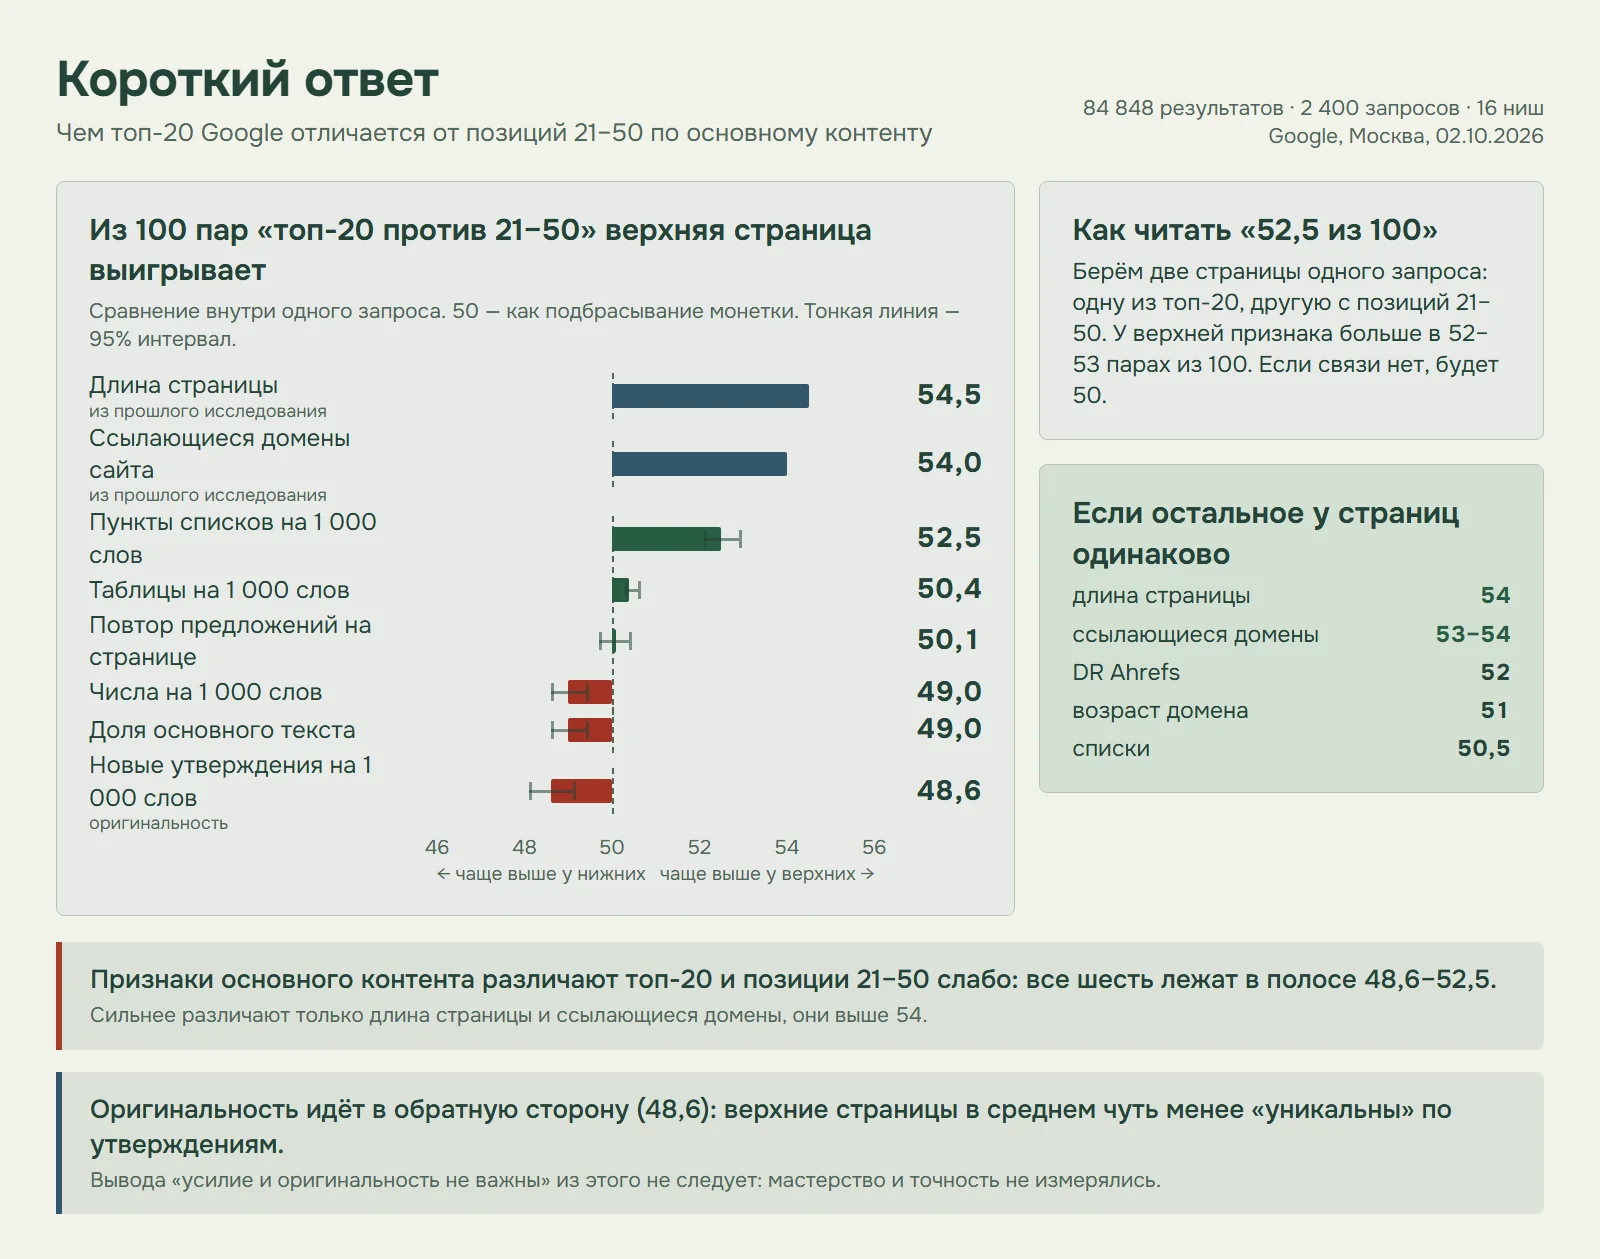
Отличается ли топ-20 от позиций 21–50 по признакам основного контента? Слабо. Из шести измеримых признаков самый заметный — доля пунктов списка. Страница из топ-20 имеет больше пунктов на 1 000 слов, чем страница позиций 21–50 того же запроса, в 52,5 случая из 100 (монетка даёт 50). Для сравнения, длина страницы в том же корпусе даёт 54,5 из 100, а число ссылающихся доменов сайта 54,0.
Оригинальность я измерял как долю утверждений, которых нет на других страницах той же выдачи. Здесь результат идёт в обратную сторону: 48,6 из 100. Верхние страницы в среднем чуть менее «уникальны» по утверждениям.
Сильнее признаков текста различают группы только длина страницы и ссылающиеся домены. Когда я добавил ссылочное и возраст домена, картина стала яснее. Когда у страниц уравнены остальные признаки, связь с позицией сохраняют длина и число ссылающихся доменов: более длинная страница пары, как и страница сайта с заметно большим числом ссылающихся доменов, оказывается в топ-20 примерно в 54 случаях из 100. DR Ahrefs и возраст домена после этого дают 52 и 51 из 100, то есть почти монетку. Расчёт с пояснениями в разделе про ссылочное.
Граница вывода. Я измерял то, что видно в тексте страницы. Мастерство и точность по корпусу измерить нельзя, картинки и ссылки в извлечённом тексте отсутствуют, а оценки асессоров, по прямому заявлению Google, в ранжирование напрямую не входят. Результат говорит, что эти измеримые черты слабо различают группы топ-20 и 21–50. Вывода «усилие и оригинальность не важны» из него не следует.
Что означают цифры в статье
Дальше везде одна шкала. Остальные обозначения нужны, если захотите проверить расчёт.
- 52,5 из 100
- Берём два результата одного запроса, один из топ-20, другой с позиций 21–50. В 52,5 парах из ста у верхнего значение признака больше. 50 — монетка. В таблицах эта шкала подписана AUC
- 95% интервал 52,1–52,9
- Диапазон, в котором, скорее всего, лежит настоящее значение, если собрать другие 2 400 запросов (границы считаются многократной пересборкой набора запросов). Если в интервал попадает 50, перевеса над монеткой нет
- Доля запросов с эффектом
- В скольких запросах из всех у топа значение выше, чем у позиций 21–50. Если связи нет, выйдет около половины
- Отношение шансов 1,02
- Тот же вопрос, что и «из 100», но при условии, что остальные признаки у двух страниц одинаковы. 1 значит «связи нет»; 1,17 соответствует примерно 54 из 100, 1,04 примерно 51 из 100. Разбор с годами и пунктами DR в разделе про ссылочное
- Медиана
- Типичная страница: у половины значение больше, у половины меньше
Что написано в справке Google
Документ называется «Creating helpful, reliable, people-first content» (developers.google.com/search/docs/fundamentals/creating-helpful-content). На странице стоит отметка «Last updated 2026-10-05 UTC». Я прочитал её сам 13 октября, не в пересказе.
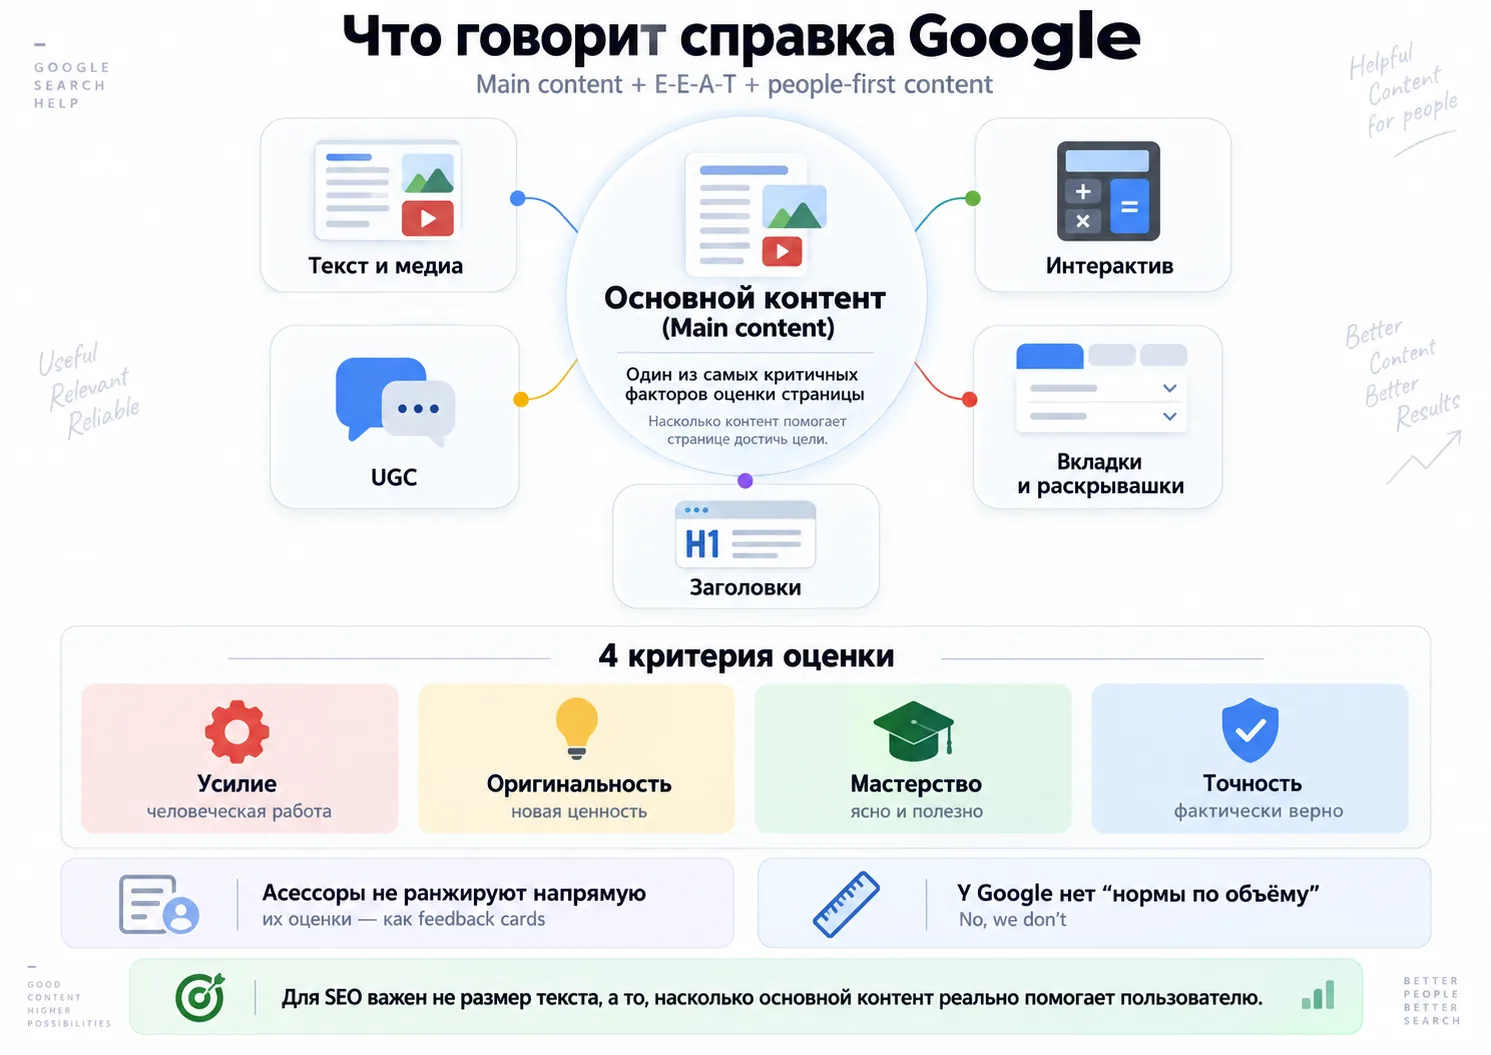
Главное в новом разделе: помимо E-E-A-T, руководство для асессоров называет качество основного контента одним из самых критичных факторов оценки страницы. Критерий такой: насколько эффективно контент помогает странице достичь своей цели и дать пользователю удовлетворительный опыт (перевод мой, оригинал в разделе «Как это считалось»).
Основным контентом Google называет любую часть страницы, которая прямо помогает ей достичь цели. В список входят:
- основной текст и медиа: статьи, изображения, аудио, видео;
- интерактивные функции: калькуляторы, онлайн-инструменты, игры, поиск по сайту;
- пользовательские вклады, если они прямо выполняют цель страницы: обсуждения на форуме, отзывы клиентов, комментарии (например, когда страница посвящена обсуждению вопроса пользователя);
- информация во вкладках и раскрывающихся блоках: характеристики товара, предупреждения по безопасности, отзывы пользователей;
- заголовки страницы и разделов.
Асессоров учат оценивать основной контент по четырём признакам. Усилие: сколько человеческой работы вложено в контент или в систему, которая его создаёт. Оригинальный анализ, ручной перевод стихотворения, собственная интерактивная карта для игры — высокое усилие; страницы, автоматически собранные из фидов, и большой объём текста от генеративной модели без ручной проверки и отбора — почти нулевое; ссылка на источник не заменяет собственного усилия. Оригинальность: даёт ли страница информацию или взгляд, которых нет на других сайтах. Мастерство: есть ли у страницы навык, нужный для удовлетворительного опыта (ясное изложение, качественное видео, работающие инструменты); не всякому контенту нужна узкая экспертиза. Точность: информационные страницы должны быть фактически верными, а в темах, влияющих на жизнь и благополучие людей (YMYL), контент должен быть высокоточным и согласованным с устоявшимся мнением экспертов.
Две цитаты из того же документа я использую дальше как опору.
Первая цитата о роли асессоров. «Search raters have no control over how pages rank. Rater data is not used directly in our ranking algorithms. Rather, we use them as a restaurant might get feedback cards from diners.» То есть оценки асессоров не входят в алгоритмы ранжирования напрямую: это карточки отзывов в ресторане, по которым Google проверяет, хорошо ли работают его системы. Связь признаков из руководства для асессоров с позицией видна только в данных, поэтому ниже я её считаю.
Вторая цитата о длине. В списке признаков контента, ориентированного на поисковик, стоит вопрос «Пишете ли вы под определённое число слов, потому что слышали, что у Google есть предпочтительный объём?» и ответ в скобках: «(No, we don't.)». Это пригодится в разговоре о длине, когда дойдём до данных.
Как найти основной контент на своей странице
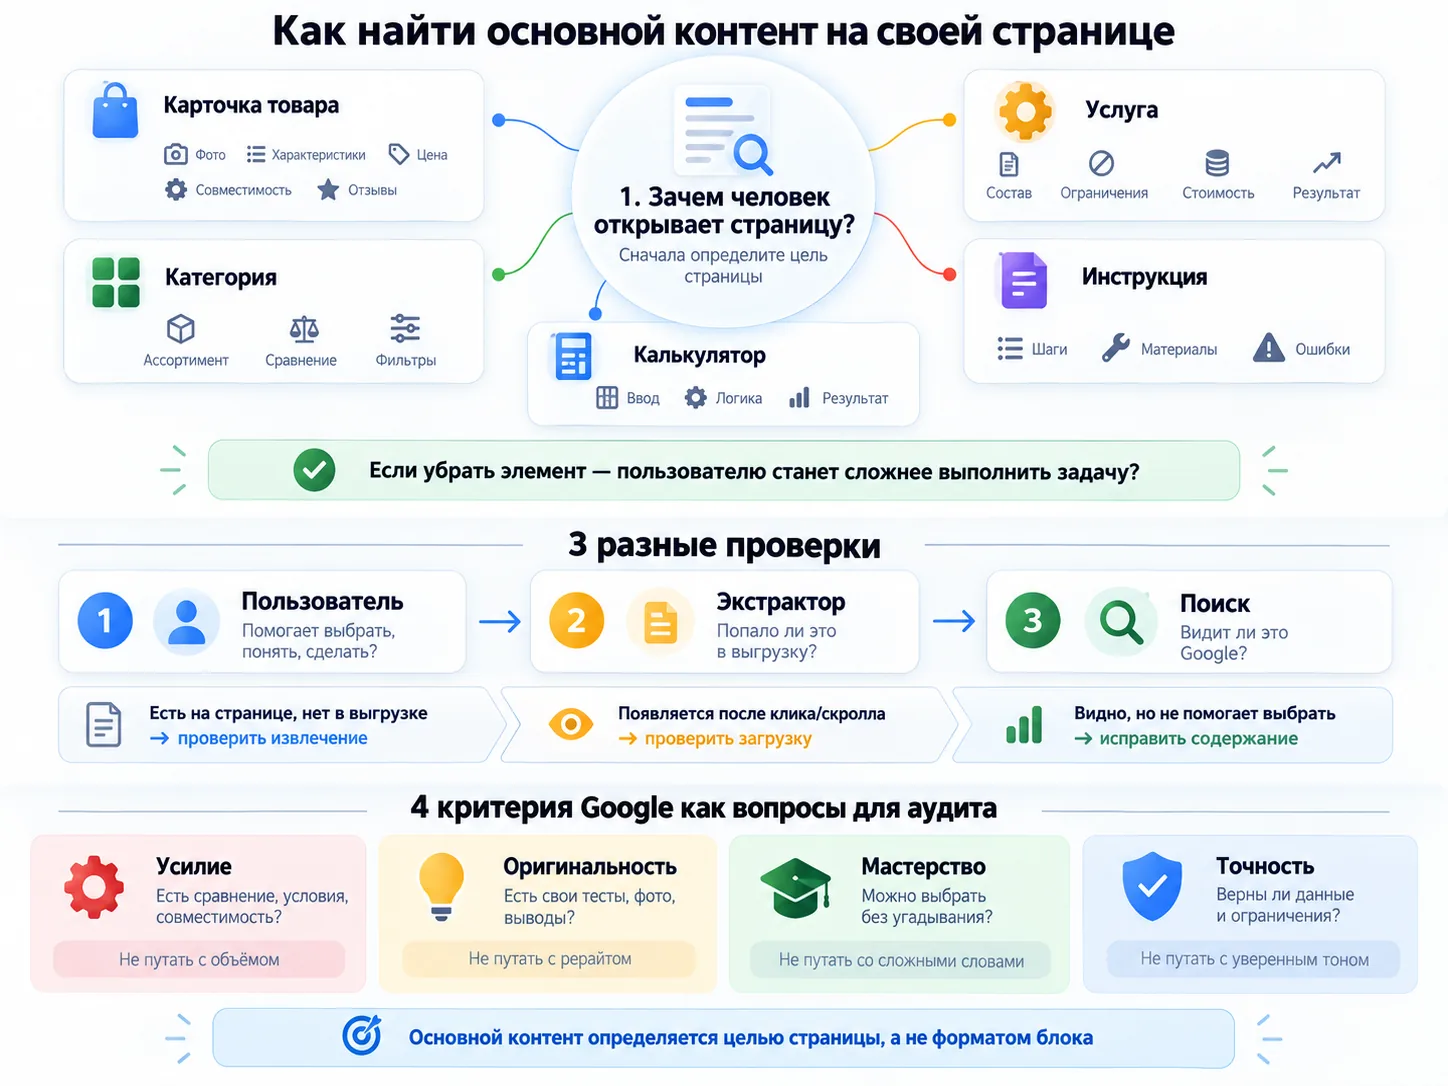
Определение Google функциональное: основной контент определяется целью страницы, а не форматом блока. Поэтому первый шаг аудита звучит так: одним предложением записать, зачем человек открывает страницу. После этого можно отбирать элементы. Таблица ниже — моя учебная интерпретация для пяти типов страниц, а не список Google и не универсальная классификация сайтов.
| Тип страницы | Что пользователь пришёл сделать | Что проверить как основной контент |
|---|---|---|
| Карточка товара | Понять, подходит ли товар, и решить, покупать ли | Фотографии, характеристики, комплектация, цена, совместимость, содержательные отзывы, функции выбора |
| Категория каталога | Найти подходящий вариант среди нескольких | Ассортимент, данные для сравнения, фильтры и результаты их работы |
| Страница услуги | Понять предложение и условия получения услуги | Состав работ, ограничения, стоимость или порядок расчёта, примеры результата, условия обращения |
| Инструкция | Выполнить задачу | Последовательность действий, нужные материалы, примеры, типичные ошибки и их исправление |
| Калькулятор | Получить расчёт и понять результат | Поля ввода, расчётная логика, результат, пояснения и ограничения |
Для каждого элемента из третьей колонки задайте один вопрос: если убрать этот элемент, пользователю станет сложнее выполнить основную задачу страницы? Что именно он потеряет? Это не автоматический классификатор, а отправная точка для ручного аудита.
Неосновной контент не означает ненужный. Меню, навигация и вспомогательные пояснения нужны, и удалять их ради доли основного текста не стоит. Полезность элемента и его участие в конкретной метрике нужно обосновывать по отдельности.
Три разные проверки: пользователь, экстрактор, поиск
Когда инструмент говорит, что на странице мало основного текста, под этим могут лежать три разные причины. Их нужно проверять по очереди, потому что ошибка в одной не говорит об ошибке в другой.
- Что помогает пользователю. Определите назначение страницы и оцените её содержимое: можно ли выбрать, сравнить, понять условия, выполнить действие.
- Что сохранил инструмент. Поставьте рядом страницу и извлечённый текст, найдите в обоих пять-десять важных фрагментов и отметьте потери. Отсутствие блока в выгрузке не означает его отсутствия на странице. Проверьте и настройки извлечения. В моей проверке доли основного текста на 300 запросах trafilatura работала с
include_comments=False, комментарии сознательно не попадали в основной текст. В установленной у меня версии 2.2.0 по умолчанию стоитinclude_comments=True. Для остальных расчётов корпуса явную настройку по сохранённым скриптам подтвердить не удалось. Поддержка блока инструментом ещё не гарантирует, что он правильно распознан на конкретном сайте. - Что доступно Google. Это отдельная техническая задача. В документации Google по отложенной загрузке (страница обновлена 10 декабря 2025 года, прочитана мной 13 октября 2026) сказано, что методы загрузки не должны зависеть от действий пользователя, таких как прокрутка или клик, потому что поиск не взаимодействует со страницей. Для проверки своих страниц документ советует найти нужный фрагмент в отрендеренном HTML через инструмент проверки URL в Search Console.
Диагностика сводится к трём ветвям:
- характеристики есть на странице, но нет в выгрузке: проверяем извлечение;
- характеристики появляются только после действия пользователя: проверяем загрузку и доступность поиску;
- характеристики доступны, но по ним нельзя выбрать товар: исправляем содержание.
Четыре характеристики Google как вопросы для аудита
Усилие, оригинальность, мастерство и точность сами по себе не дают ТЗ. Чтобы они работали, их нужно превратить в проверяемые вопросы. Ниже пример для страницы промышленного оборудования. Это вопросы для аудита, которые я предлагаю, а не измеренные факторы ранжирования.
| Характеристика | Что проверять на странице оборудования | Чем не подменять проверку |
|---|---|---|
| Усилие | Сравнены ли модели, разобраны ли условия эксплуатации, проверена ли совместимость | Числом абзацев, списков и таблиц |
| Оригинальность | Есть ли собственные измерения, фотографии испытаний, разбор нестандартного применения | Пересказом описания производителя другими словами |
| Мастерство | Может ли покупатель разобраться в параметрах и выбрать модель без угадывания | Сложной терминологией и декоративным оформлением |
| Точность | Проверены ли единицы измерения, комплектация, ограничения и соответствие документации | Уверенным тоном и большим числом цифр |
Оригинальность не требует изобрести неизвестный факт. Формальная переработка заменяет формулировки чужой инструкции синонимами. Собственный вклад проверяет инструкцию на конкретной модели, находит ограничение и показывает, как его учитывать. Уникальность формулировок, новизна извлечённых утверждений (один из шести признаков в моём замере) и оригинальная польза страницы — три разные вещи, и высокий результат по одной из них ничего не говорит о двух других.
Выдача по одному запросу
слова на странице nalog.gov.ru
906 слов на странице всего
слов статьи на nalogia.ru, ещё 1 673 слова комментариев читателей
3 496 слов на странице всего
Прежде чем смотреть на 84 848 результатов, разберём одну выдачу. Запрос «как получить справку о неполучении налогового вычета», Google, Москва, десктоп, 2 октября 2026 года, 34 читаемые страницы.
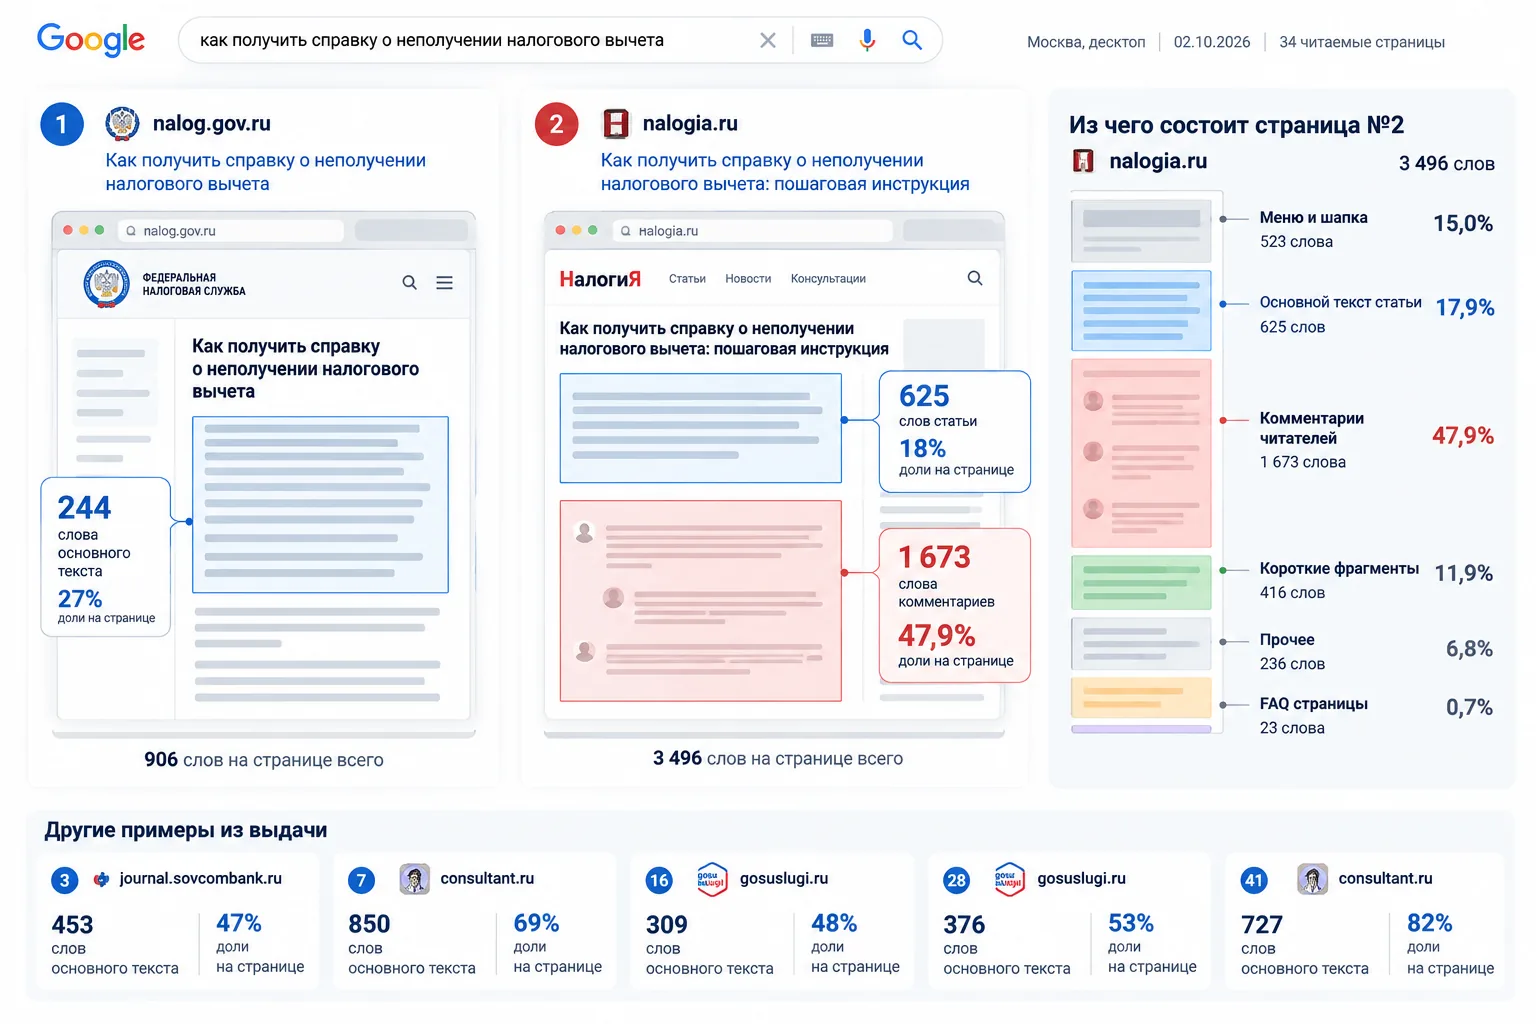
| Позиция | Сайт | Основной текст, слов | Вся страница, слов | Доля основного текста | Комментарии читателей | Раскрывающиеся блоки |
|---|---|---|---|---|---|---|
| 1 | nalog.gov.ru | 244 | 906 | 27% | 0% | 0% |
| 2 | nalogia.ru | 625 | 3 496 | 18% | 47,9% (1 673 слова) | 0% |
| 3 | journal.sovcombank.ru | 453 | 969 | 47% | 0% | 0% |
| 7 | consultant.ru | 850 | 1 224 | 69% | 0% | 0% |
| 16 | gosuslugi.ru | 309 | 641 | 48% | 0% | 45,2% |
| 28 | gosuslugi.ru | 376 | 707 | 53% | 0% | 41,4% |
| 41 | consultant.ru | 727 | 885 | 82% | 0% | 0% |
Основной текст здесь тот, который выделяет trafilatura, программа, извлекающая из страницы статью без меню и подвала. Слова в этом разборе посчитаны по сохранённой копии страницы для проверки доли основного текста; в общей таблице признаков подсчёт слов идёт по основному файлу корпуса, и на отдельных страницах он расходится на единицы слов (например, у nalogia.ru 625 слов в разборе и 618 в общей таблице). Столбцы «комментарии» и «раскрывающиеся блоки» получены разбором разметки HTML по названиям классов.
На первом месте страница ФНС в 244 слова. На втором статья на 625 слов, и это 18% страницы. Остальное — меню, шапка и ветка комментариев, 1 673 слова вопросов читателей и ответов на них, 47,9% страницы.
У двух страниц Госуслуг (позиции 16 и 28) около 45% и 41% страницы по разметке лежат в раскрывающихся блоках. Я открыл HTML и проверил содержимое. Там лежат списки похожих вопросов из справки, инструкции там нет. Основной текст страниц (309 и 376 слов) экстрактор выделил верно. Автоматическая разметка здесь ошиблась, и ниже я вернусь к тому, как это повлияло на результат.
Для Google различие важно. Определение основного контента включает пользовательские вклады, но только если они прямо выполняют цель страницы. Комментарии под статьёй о справке содержат вопросы читателей и ответы автора. Выполняют ли они цель страницы, из HTML не видно.
Поэтому долю основного текста я не принимаю за признак качества. Что она показывает на всём корпусе, видно дальше.
84 848 результатов выдачи и шесть признаков
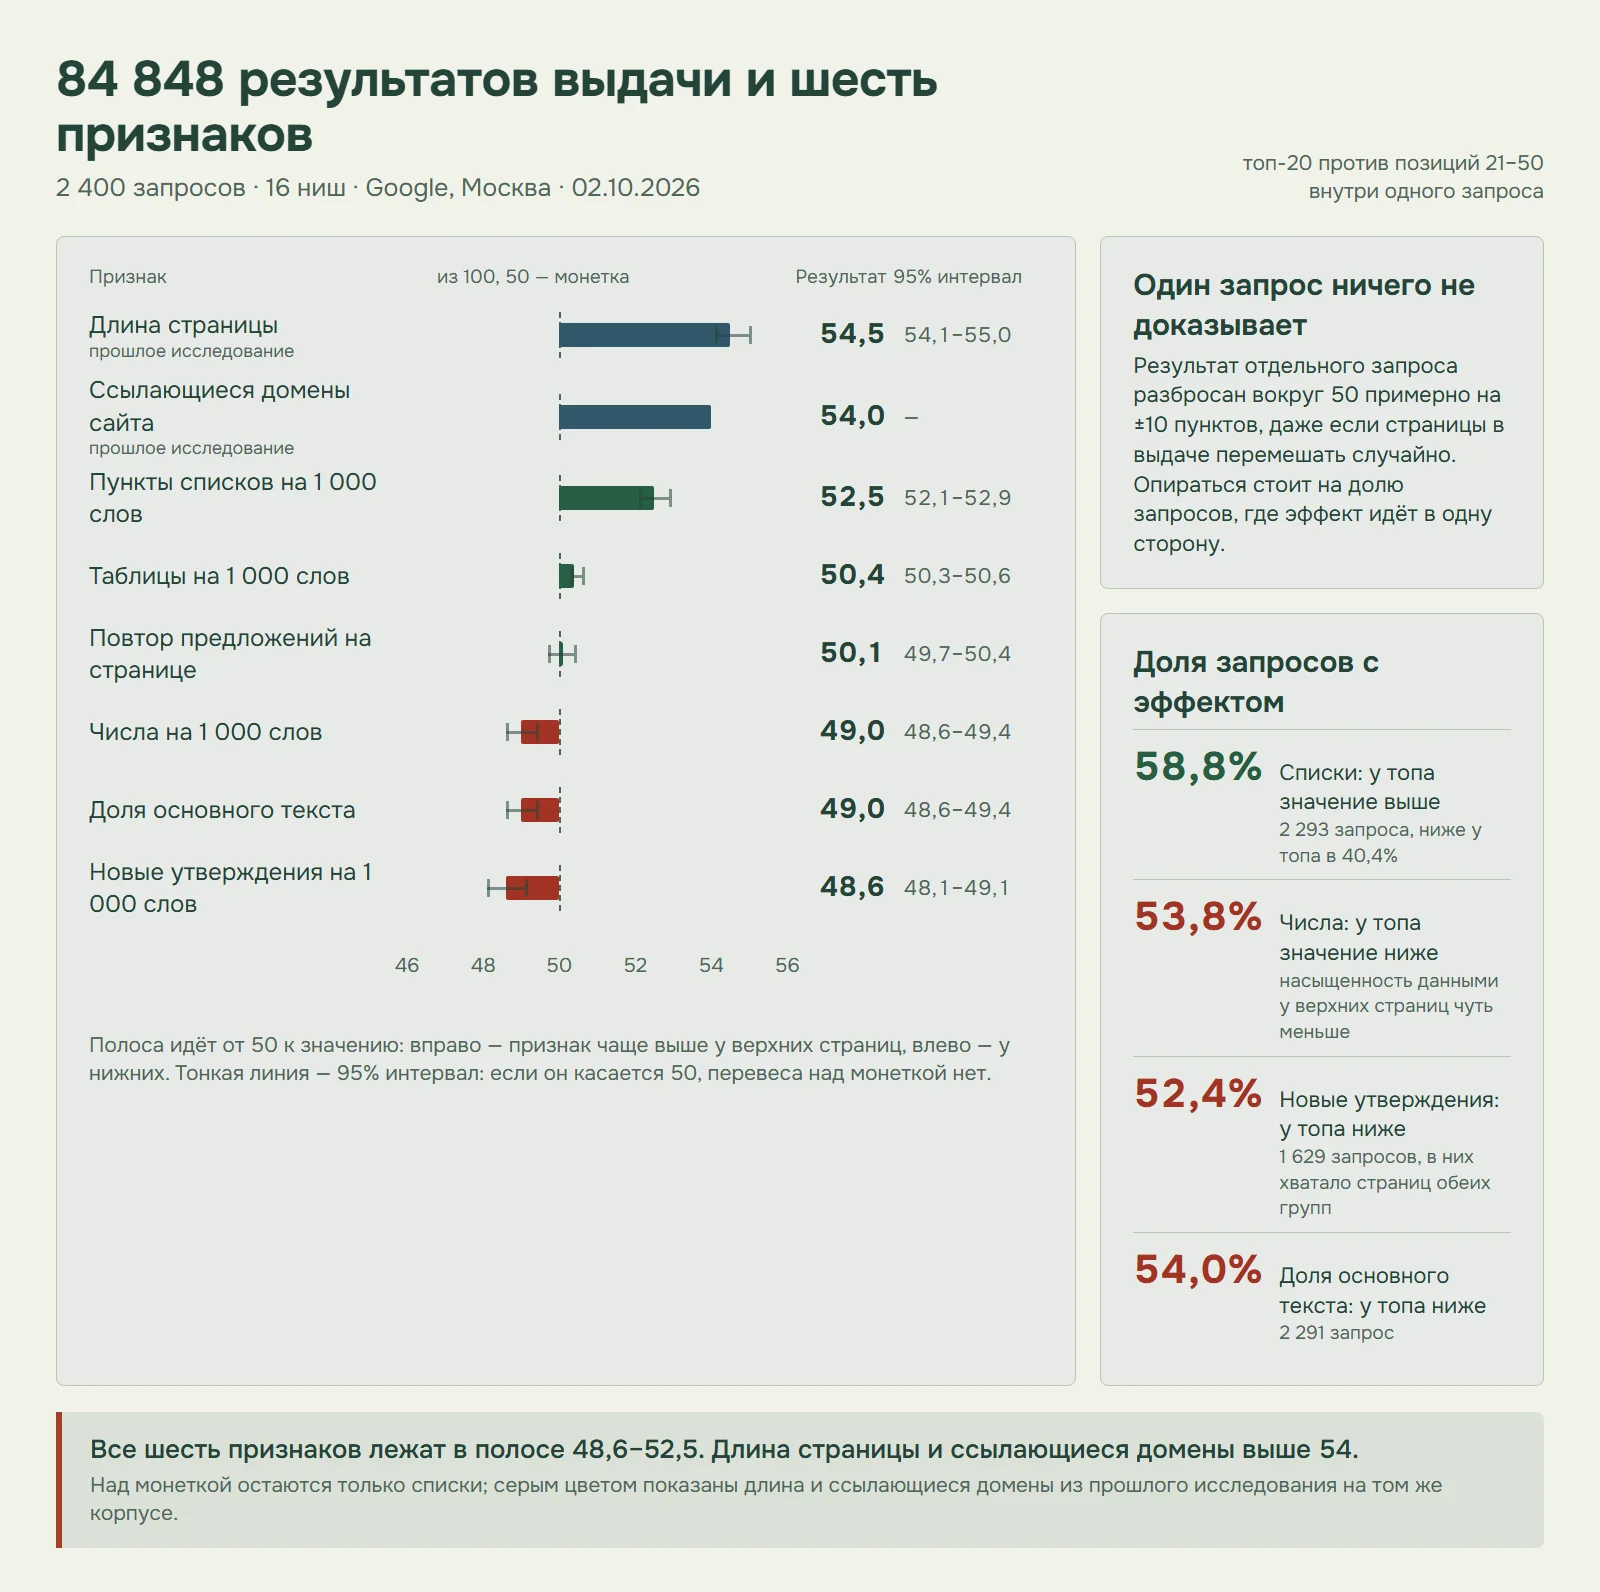
Корпус: 2 400 запросов в 16 нишах (от бытовой техники до юридических услуг), выдача Google, Москва, десктоп, 2 октября 2026 года. Для каждого запроса я сравнил страницы топ-20 и позиций 21–50. Результат читается просто. Число из 100 показывает, как часто у страницы из топ-20 значение признака выше, чем у страницы из 21–50 того же запроса. Монетка даёт 50, и разница в 1–2 пункта при такой выборке заметна статистически, но мала по существу.
| Признак | Что измеряет | Результат из 100 | 95% интервал |
|---|---|---|---|
| Пункты списков на 1 000 слов | структурная работа над страницей | 52,5 | 52,1–52,9 |
| Таблицы на 1 000 слов | то же, но у 91% страниц таблиц нет | 50,4 | 50,3–50,6 |
| Повтор предложений на странице | шаблонность текста | 50,1 | 49,7–50,4 |
| Числа на 1 000 слов | насыщенность данными | 49,0 | 48,6–49,4 |
| Доля основного текста | основной текст против всей страницы | 49,0 | 48,6–49,4 |
| Новые утверждения на 1 000 слов | записи «субъект — связь — объект», которых нет на других страницах выдачи | 48,6 | 48,1–49,1 |
Google, Москва, 02.10.2026, позиции 1–50, пары внутри запроса, ничьи пополам. 84 848 результатов выдачи, 2378 запросов в основном сравнении. Серым — длина и ссылающиеся домены из прошлого исследования на том же корпусе, цветом — самый сильный из шести новых признаков.
Что здесь видно.
Списки. Верхние страницы чаще структурируют текст списками. По позициям эффект плавный. На местах 1–3 в среднем 12,4 пункта списков на 1 000 слов, на местах 31–50 9,6. В 11 из 16 ниш 95% интервал целиком выше 50 (без поправки на множественные сравнения), ни в одной он не лежит целиком ниже; максимум в туризме (58,5). Но когда длина страницы и число ссылающихся доменов сайта уравнены, связь пропадает: списки дают около 50,5 из 100, то есть монетку (в статистической записи отношение шансов 1,02, интервал 0,98–1,05 включает единицу, «связи нет»). Видимо, списки сопровождают другие свойства сильных страниц и сами по себе позиции не объясняют.
Повторы и таблицы. Шаблонности по признаку «одинаковые предложения на странице» между группами нет (50,1, практически ноль). Таблицы тоже почти ничего не различают. Они есть примерно у 9% страниц, и признак в основном сообщает, есть таблица или нет.
Числа. Верхние страницы чуть реже насыщены числами (49,0). Идея «больше данных на странице — выше позиция» этим корпусом не подтверждается. Без агрегаторов результат уходит к 50 и составляет 49,7 (49,3–50,2).
Оригинальность. Признак смотрит в противоположную от ожидания сторону. Алгоритм из моего прошлого исследования извлекает из текста утверждения в виде записей «субъект — связь — объект». Для каждой страницы я считал, сколько таких записей на 1 000 слов нет ни у одной другой страницы той же выдачи. У верхних страниц их чуть меньше (48,6), в туризме 42,4, в финансах 44,8. Моё толкование такое. Страницы в топе больше похожи на соседей, потому что покрывают общий набор утверждений, которого ждёт запрос. Это гипотеза. Из результата не следует, что оригинальный контент вреден. Измерена новизна записей, которые находит алгоритм. Но он находит не всё, и в прошлом исследовании его точность на страницах топ-20 была ниже, чем на позициях 21–50 (0,77 против 0,84 по примерно 200 записям), что могло повлиять на признак.
Сводный индекс. Если свести усилие в один показатель (таблицы, числа, списки), он практически ничего не различает и даёт 50,3 (49,9–50,7).
Длина. Для масштаба: длина страницы в этом корпусе даёт 54,5, а число ссылающихся доменов 54,0, то есть больше любого из шести признаков. При этом первое место короче медианной страницы позиций 21–50 в 40,8% запросов из 1 823: «чем длиннее, тем выше» верно в среднем, но не в каждом запросе, а Google предпочтительного объёма не называет.
Почему одним ярким примером ничего не доказать
Прежде чем перейти к примерам, важная оговорка. Результат каждого отдельного запроса шумит. В запросе по 14 и 19 страниц, и при случайном порядке «из 100» разбросан вокруг 50 примерно на 10 пунктов (стандартное отклонение 9,8). На реальных данных разброс по запросам у списков 10,2, у чисел 10,5, у новизны 10,9, у доли основного текста 10,4. Поэтому в каждой выдаче можно найти запрос с результатом 88 или 12, и это ничего не доказывает, потому что среди 2 293 запросов такие значения могут встретиться и при случайном порядке.
Доказывает другое: доля запросов, где эффект идёт в одну сторону. У списков у топа значение выше в 58,8% запросов (ниже в 40,4%), у чисел у топа значение ниже в 53,8%, у новых утверждений ниже в 52,4% (запросов 1 629), у доли основного текста ниже в 54,0%. Эти доли отличаются от 50% заметно больше, чем позволяет шум. У списков и доли основного текста запросов 2 293 и 2 291, у новых утверждений 1 629 (в них хватало страниц обеих групп), стандартная ошибка доли 1,0–1,2 пункта. Запросы с результатом ровно 50 остаются в знаменателе.
- Что проверяли
- 84 848 результатов выдачи Google по 2400 запросам в 16 нишах: шесть текстовых признаков, которые можно посчитать по странице. Сравнение внутри запроса: топ-20 против позиций 21–50.
- Что нашли
- Лучший результат у списков, 52,5 из 100. Таблицы, повторы, числа, доля основного текста и новизна утверждений лежат в полосе 48,6–50,4. Длина страницы (54,5) и ссылающиеся домены (54,0) сильнее.
- Что это значит
- Различия малы. Отдельный запрос шумит на ±10 пунктов, поэтому опираться стоит на доли запросов.
- Что делать
- Сравнивать страницу с выдачей своего запроса и своей ниши.
Ориентиры по нишам
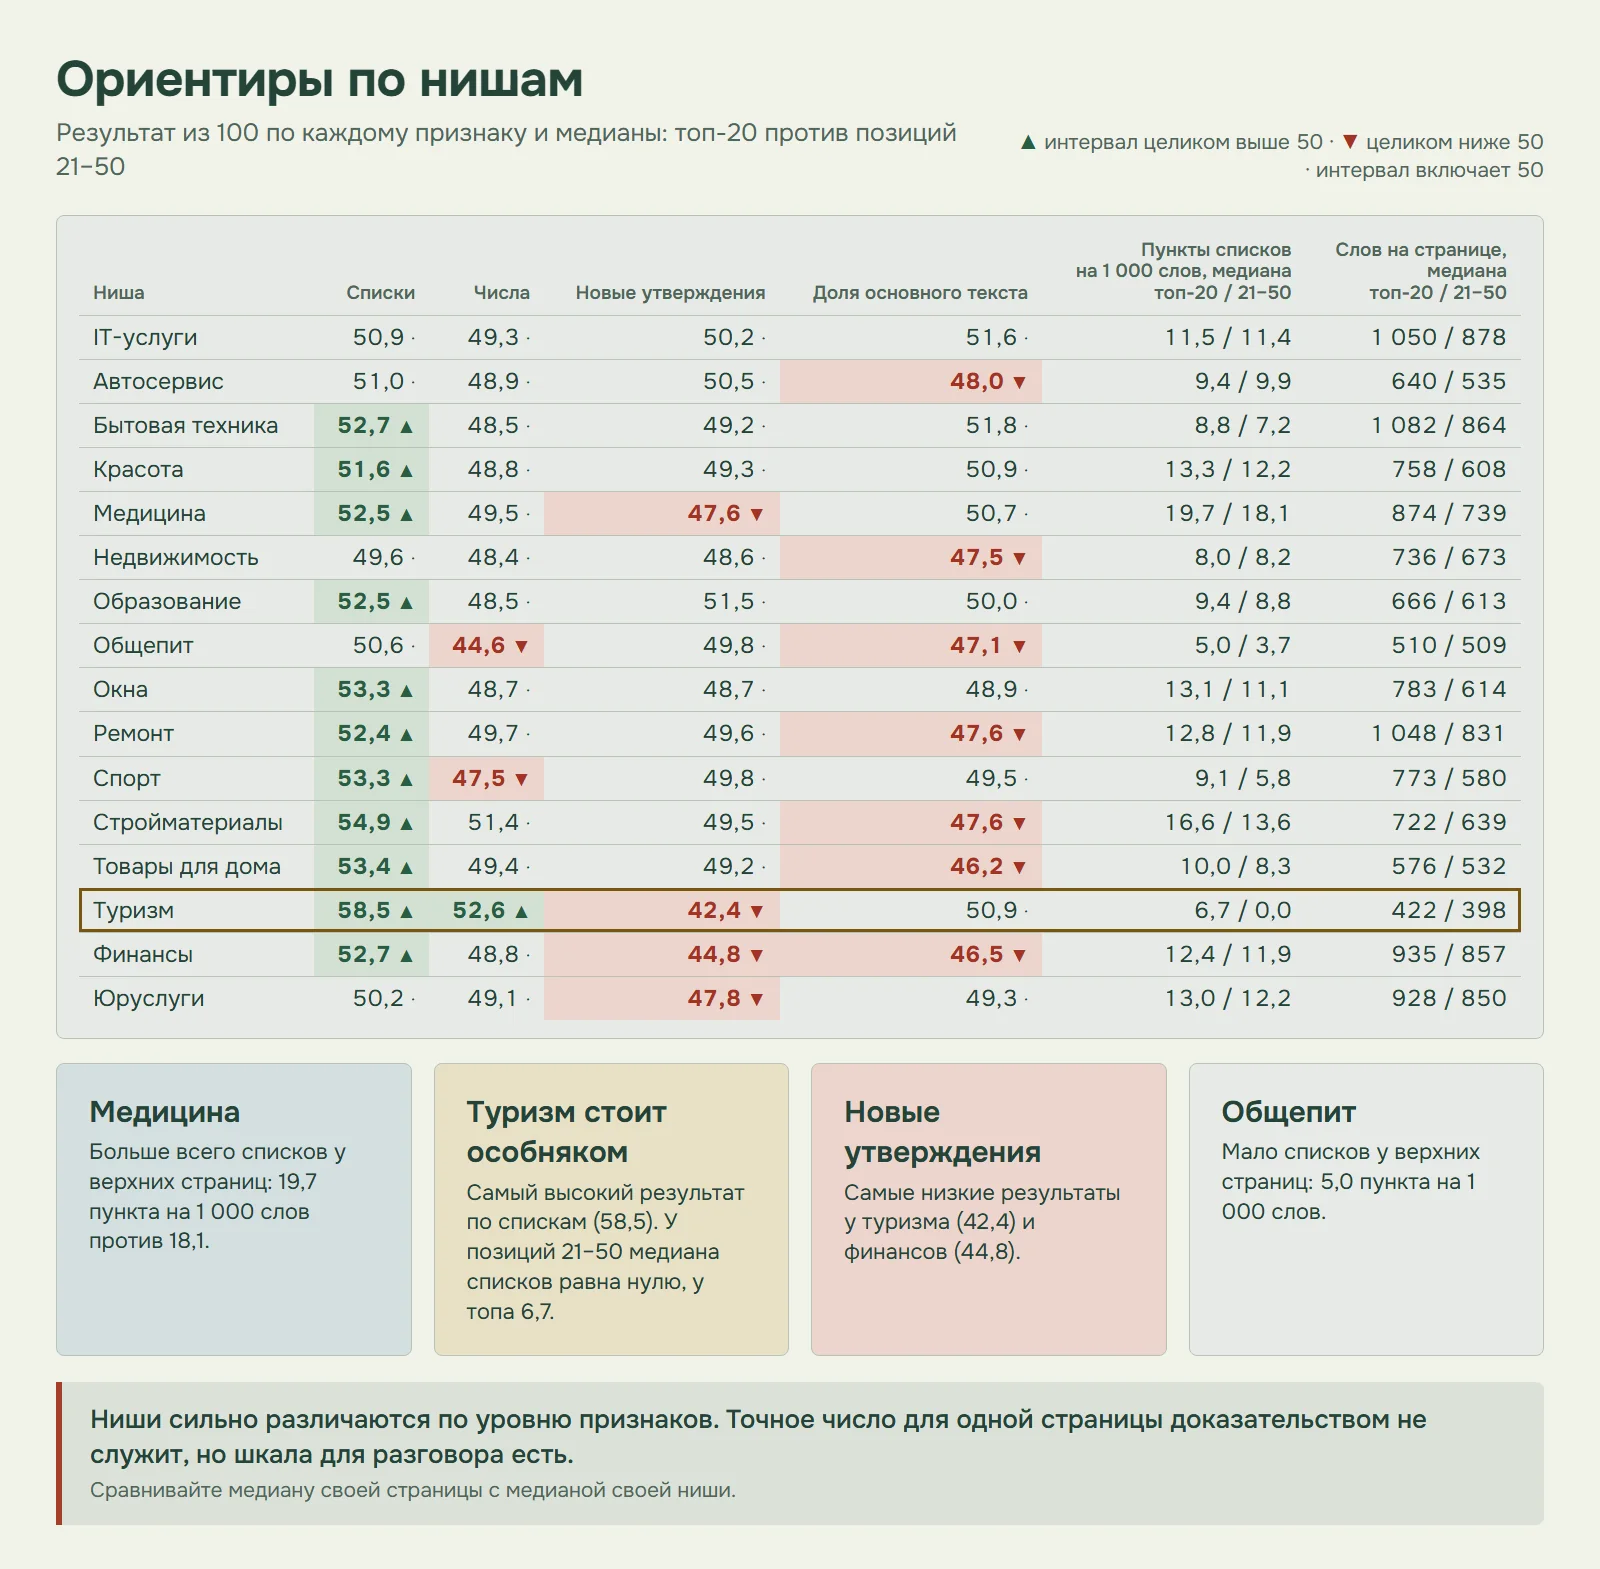
Ниша меняет картину. В таблице результат из 100 по каждому признаку и нише (▲ интервал целиком выше 50, ▼ целиком ниже, · интервал включает 50), плюс медианы списков и длины у топ-20 и позиций 21–50. Ниши сильно различаются и по уровню списков. В общепите у верхних страниц 5,0 пункта на 1 000 слов, в медицине 19,7.
| Ниша | Списки | Числа | Новые утверждения | Доля основного текста | Пункты списков на 1 000 слов, медиана (топ-20 / 21–50) | Слов, медиана (топ-20 / 21–50) |
|---|---|---|---|---|---|---|
| IT-услуги | 50,9 · | 49,3 · | 50,2 · | 51,6 · | 11,5 / 11,4 | 1 050 / 878 |
| Автосервис | 51,0 · | 48,9 · | 50,5 · | 48,0 ▼ | 9,4 / 9,9 | 640 / 535 |
| Бытовая техника | 52,7 ▲ | 48,5 · | 49,2 · | 51,8 · | 8,8 / 7,2 | 1 082 / 864 |
| Красота | 51,6 ▲ | 48,8 · | 49,3 · | 50,9 · | 13,3 / 12,2 | 758 / 608 |
| Медицина | 52,5 ▲ | 49,5 · | 47,6 ▼ | 50,7 · | 19,7 / 18,1 | 874 / 739 |
| Недвижимость | 49,6 · | 48,4 · | 48,6 · | 47,5 ▼ | 8,0 / 8,2 | 736 / 673 |
| Образование | 52,5 ▲ | 48,5 · | 51,5 · | 50,0 · | 9,4 / 8,8 | 666 / 613 |
| Общепит | 50,6 · | 44,6 ▼ | 49,8 · | 47,1 ▼ | 5,0 / 3,7 | 510 / 509 |
| Окна | 53,3 ▲ | 48,7 · | 48,7 · | 48,9 · | 13,1 / 11,1 | 783 / 614 |
| Ремонт | 52,4 ▲ | 49,7 · | 49,6 · | 47,6 ▼ | 12,8 / 11,9 | 1 048 / 831 |
| Спорт | 53,3 ▲ | 47,5 ▼ | 49,8 · | 49,5 · | 9,1 / 5,8 | 773 / 580 |
| Стройматериалы | 54,9 ▲ | 51,4 · | 49,5 · | 47,6 ▼ | 16,6 / 13,6 | 722 / 639 |
| Товары для дома | 53,4 ▲ | 49,4 · | 49,2 · | 46,2 ▼ | 10,0 / 8,3 | 576 / 532 |
| Туризм | 58,5 ▲ | 52,6 ▲ | 42,4 ▼ | 50,9 · | 6,7 / 0,0 | 422 / 398 |
| Финансы | 52,7 ▲ | 48,8 · | 44,8 ▼ | 46,5 ▼ | 12,4 / 11,9 | 935 / 857 |
| Юруслуги | 50,2 · | 49,1 · | 47,8 ▼ | 49,3 · | 13,0 / 12,2 | 928 / 850 |
Как этим пользоваться. Берём свою нишу, смотрим медианное значение у топа и у нижней группы и сравниваем с медианой вашей страницы. Точная цифра для одной страницы доказательством не служит (см. выше про шум), но шкала для разговора есть. Туризм стоит особняком. У позиций 21–50 медиана списков равна нулю, у топа 6,7, и в этой нише результат по спискам самый высокий (58,5). Финансы и туризм дают самые низкие результаты по новым утверждениям (44,8 и 42,4).
Сайты и страницы, на которых это видно
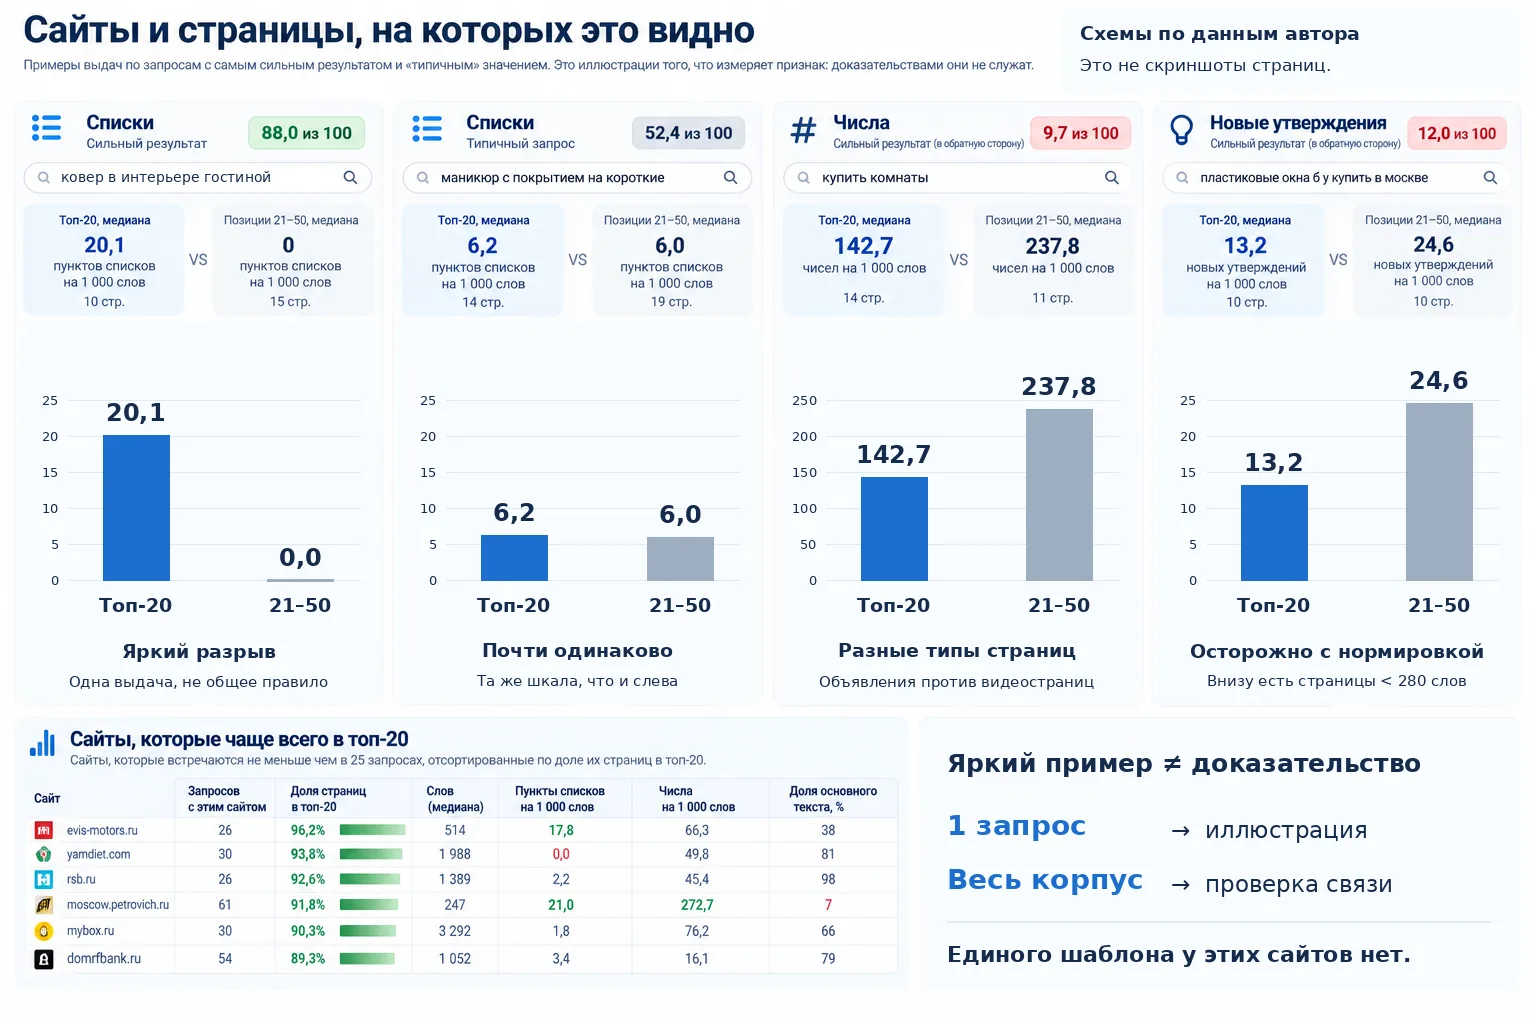
Вот примеры выдач. Правило выбора записано до просмотра: для каждого признака взят запрос с самым сильным результатом среди запросов, где в каждой группе не меньше 10 страниц, и «типичный» запрос с результатом около медианы. Это иллюстрации того, что измеряет признак; доказательствами они не служат (см. оговорку выше).
Списки
«ковер в интерьере гостиной» (товары для дома). Результат запроса 88,0 из 100; медиана признака у страниц топ-20 20,1 (10 стр.), у позиций 21–50 0,0 (15 стр.). Показаны 5 страниц с верхних и 5 с нижних позиций.
пунктов списков на 1000 слов
10 стр.
пунктов списков на 1000 слов
15 стр.
Страницы выдачи по этому запросу: 5 верхних и 5 нижних
| Позиция | Сайт | Слов | Пункты списков на 1 000 слов | В «Обзоре от ИИ» |
|---|---|---|---|---|
| 2 | kover.ru | 172 | 23,3 | да |
| 3 | parklon.ru | 675 | 25,2 | да |
| 6 | mrdoors.ru | 1 669 | 16,8 | да |
| 10 | youtube.com | 440 | 0,0 | |
| 11 | yaroslavl.lemanapro.ru | 337 | 154,3 | |
| 32 | bigfoto.name | 168 | 0,0 | |
| 33 | dekorin.me | 519 | 9,6 | |
| 34 | inmyroom.ru | 1 437 | 4,9 | |
| 36 | mobilicasa.ru | 350 | 0,0 | |
| 37 | stroistyle.com | 162 | 0,0 |
В этом запросе у страниц на позициях 2, 3 и 6 по 17–25 пунктов списков на 1 000 слов, и все три процитированы в «Обзоре от ИИ»; у трёх из пяти показанных страниц нижней группы списков нет совсем. Для сравнения, типичный запрос выглядит иначе:
«маникюр с покрытием на короткие» (красота). Результат запроса 52,4 из 100; медиана признака у страниц топ-20 6,2 (14 стр.), у позиций 21–50 6,0 (19 стр.). Показаны 5 страниц с верхних и 5 с нижних позиций.
пунктов списков на 1000 слов
14 стр.
пунктов списков на 1000 слов
19 стр.
Страницы выдачи по этому запросу: 5 верхних и 5 нижних
| Позиция | Сайт | Слов | Пункты списков на 1 000 слов | В «Обзоре от ИИ» |
|---|---|---|---|---|
| 1 | youtube.com | 383 | 0,0 | |
| 2 | 4hands.ru | 1 568 | 2,6 | да |
| 3 | charme-pro.ru | 791 | 51,8 | да |
| 5 | nouvelle.vip | 1 015 | 19,7 | |
| 6 | unogel.ru | 1 189 | 0,0 | да |
| 40 | liza.ua | 508 | 11,8 | |
| 41 | youtube.com | 220 | 0,0 | |
| 43 | youtube.com | 116 | 8,6 | |
| 45 | mamamozhetvse.ru | 625 | 0,0 | |
| 46 | modnica.club | 295 | 0,0 |
Здесь у топа и у нижней группы медианы почти совпадают (6,2 и 6,0). Типичная разница между группами мала, и яркий пример выше остаётся исключением.
Числа
«купить комнаты» (недвижимость). Результат запроса 9,7 из 100; медиана признака у страниц топ-20 142,7 (14 стр.), у позиций 21–50 237,8 (11 стр.). Показаны 5 страниц с верхних и 5 с нижних позиций.
чисел на 1000 слов
14 стр.
чисел на 1000 слов
11 стр.
Страницы выдачи по этому запросу: 5 верхних и 5 нижних
| Позиция | Сайт | Слов | Числа на 1 000 слов | В «Обзоре от ИИ» |
|---|---|---|---|---|
| 1 | cian.ru | 189 | 5,3 | |
| 3 | avito.ru | 5 944 | 89,7 | |
| 5 | realty.yandex.ru | 833 | 158,5 | |
| 6 | sob.ru | 240 | 120,8 | |
| 8 | mgsn.ru | 296 | 50,7 | |
| 29 | youtube.com | 170 | 200,0 | |
| 30 | youtube.com | 199 | 331,7 | |
| 31 | youtube.com | 457 | 234,1 | |
| 32 | youtube.com | 239 | 221,8 | |
| 33 | youtube.com | 143 | 223,8 |
Это запрос с самым сильным результатом в обратную сторону. У 14 страниц топа медиана 142,7 числа на 1 000 слов, у нижних 237,8. Среди нижних страниц пять страниц YouTube с числами в тексте от 200 до 332 на 1 000 слов. Это показывает, что «число на 1 000 слов» смешивает типы страниц. У топа площадки объявлений и недвижимости (cian.ru, avito.ru, realty.yandex.ru), у низа страницы видеоплатформы.
Новые утверждения
«пластиковые окна б у купить в москве» (окна). Результат запроса 12,0 из 100; медиана признака у страниц топ-20 13,2 (10 стр.), у позиций 21–50 24,6 (10 стр.). Показаны 5 страниц с верхних и 5 с нижних позиций.
новых утверждений на 1000 слов
10 стр.
новых утверждений на 1000 слов
10 стр.
Страницы выдачи по этому запросу: 5 верхних и 5 нижних
| Позиция | Сайт | Слов | Новые утверждения на 1 000 слов | В «Обзоре от ИИ» |
|---|---|---|---|---|
| 4 | avito.ru | 1 866 | 2,7 | да |
| 6 | втораяжизньокна.рф | 606 | 16,5 | |
| 7 | uslugi.yandex.ru | 1 507 | 17,3 | |
| 8 | msk.okna-servise.com | 474 | 21,1 | да |
| 10 | secondokna.com | 444 | 6,8 | |
| 34 | пластиковыеокнабу.рф | 277 | 21,7 | |
| 38 | mosdvery.ru | 405 | 24,7 | |
| 39 | byokoshko.ru | 236 | 21,2 | |
| 41 | окнатранс.москва | 137 | 51,1 | |
| 44 | буокна.рф | 272 | 51,5 |
В этом запросе у топа 13,2 новых утверждения на 1 000 слов, у нижних 24,6. Среди нижних четыре страницы короче 280 слов, у них от 21 до 52 новых утверждений на 1 000 слов, и нормировка на 1 000 слов у коротких страниц завышает показатель.
Сайты, которые чаще всего в топ-20
Ещё один способ увидеть разнообразие: сайты, которые встречаются не меньше чем в 25 запросах, отсортированные по доле их страниц в топ-20.
| Сайт | Запросов с этим сайтом | Доля страниц в топ-20 | Слов, медиана | Пункты списков на 1 000 слов | Числа на 1 000 слов | Доля основного текста, % |
|---|---|---|---|---|---|---|
| moscow.petrovich.ru | 61 | 91,8% | 247 | 21,0 | 272,7 | 7 |
| domrfbank.ru | 54 | 89,3% | 1 052 | 3,4 | 16,1 | 79 |
| mybox.ru | 30 | 90,3% | 3 292 | 1,8 | 76,2 | 66 |
| yamdiet.com | 30 | 93,8% | 1 988 | 0,0 | 49,8 | 81 |
| evis-motors.ru | 26 | 96,2% | 514 | 17,8 | 66,3 | 38 |
| rsb.ru | 26 | 92,6% | 1 389 | 2,2 | 45,4 | 98 |
Видно, что у таких сайтов нет общего шаблона. Медианная страница moscow.petrovich.ru — 247 слов, 273 числа на 1 000 слов (цены в каталоге) и 7% «основного» текста по определению экстрактора. Это страницы-каталоги. У mybox.ru 3 292 слова и 76 чисел, у yamdiet.com 1 988 слов без единого пункта списка. У evis-motors.ru небольшие страницы (514 слов) с заметной долей списков. Доля «страниц в топ-20» зависит от того, по каким запросам сайт попал в корпус, поэтому таблица показывает разнообразие устройства сайтов и рейтингом не является.
Ссылочное и история доменов у сайтов выдачи
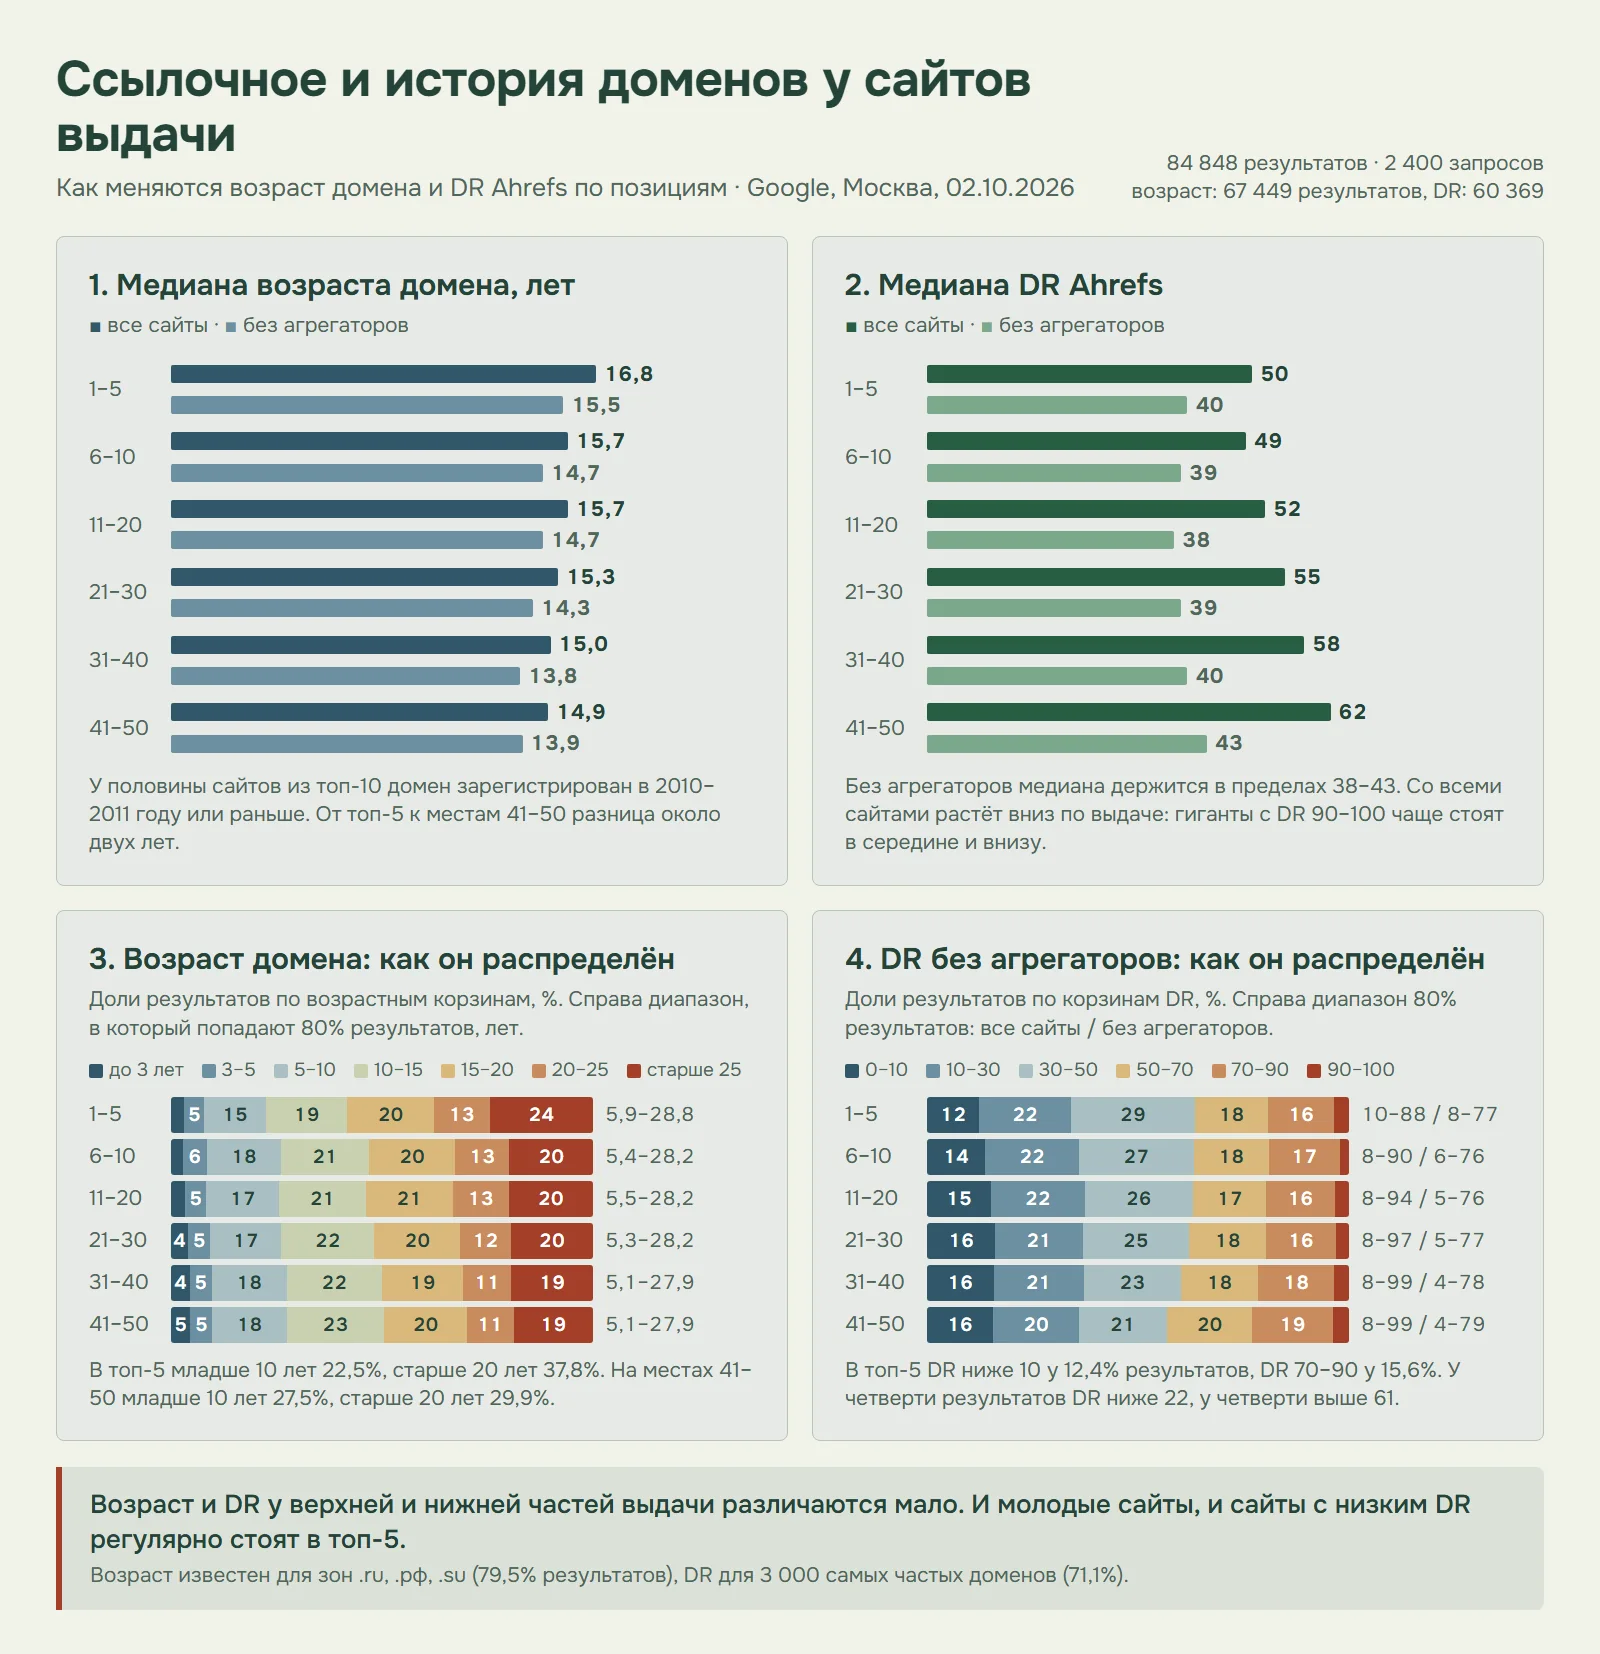
Ссылочное и возраст сайта я смотрю в два захода: сначала на всём корпусе, потом на отдельных сайтах. DR (Domain Rating by Ahrefs) — шкала от 0 до 100, которая оценивает ссылочную силу домена целиком, а не отдельной страницы. Я собрал DR для 3000 корневых доменов, на которые приходится 71,1% результатов выдачи; у поддоменов DR общий с корневым. Возраст — дата регистрации из реестра зоны .ru, .рф или .su (79,5% результатов). Для сравнения те же приёмы, что и для признаков текста: доля пар «страница топ-20 выше страницы позиций 21–50» внутри запроса.
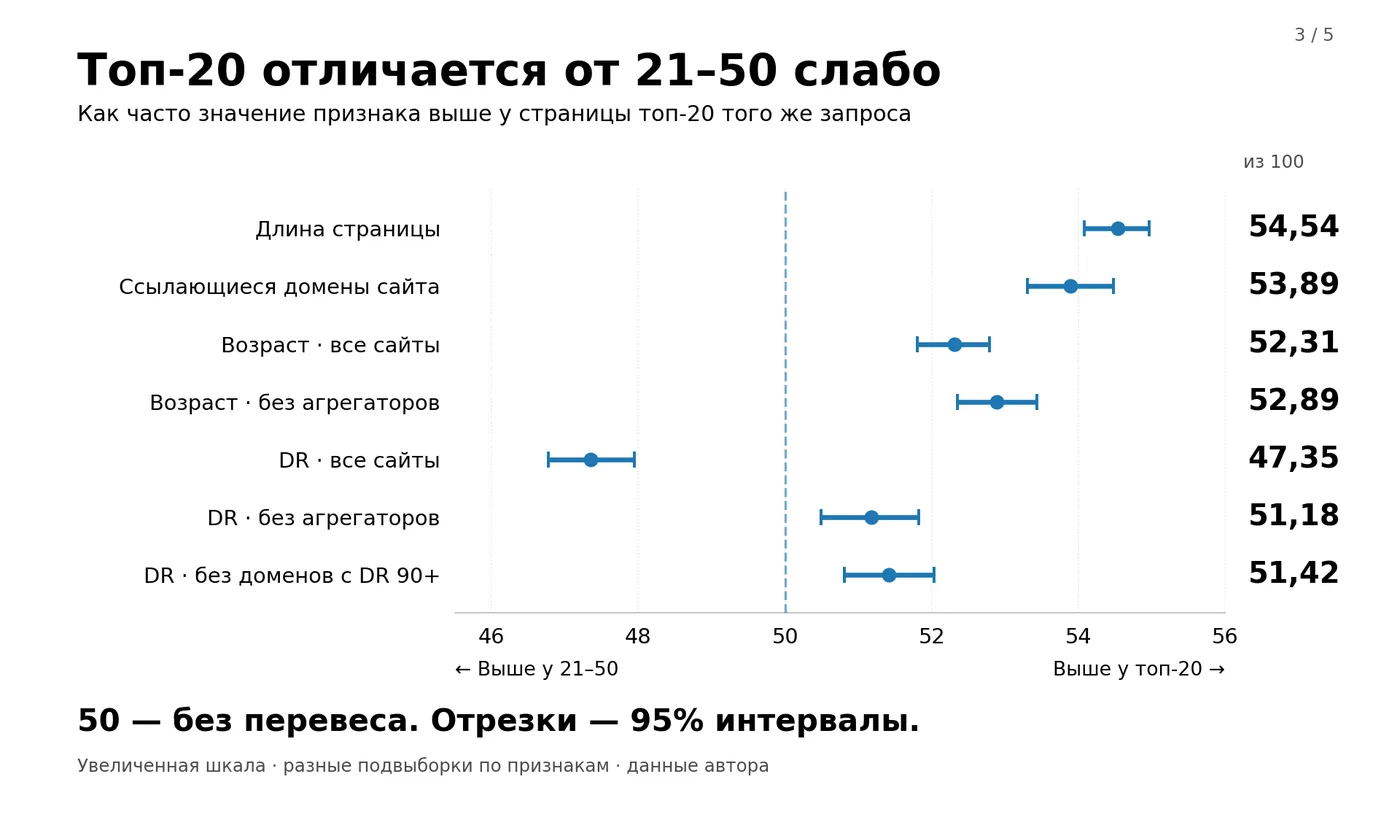
Шкала та же, что в начале статьи. «54,5 из 100» для длины значит: страница из топ-20 длиннее своей пары примерно в 54 случаях из 100 и короче в 46 (монетка дала бы 50). Интервал 54,08–54,97 показывает точность: с вероятностью 95% среднее по выдачам такого рода лежит между этими числами. Он целиком выше 50, поэтому перевес не случаен, но небольшой: 4–5 лишних пар на сотню.
Сколько лет домену и какой у него DR на каждой позиции
Сначала ответ на вопросы, которые таблицы ниже скрывают за «результатом из 100». Я разложил результаты выдачи по позициям и для каждой группы взял медиану: у половины результатов значение ниже, у половины выше. Возраст считаю в годах от даты регистрации домена, DR берётся по шкале Ahrefs от 0 до 100. Колонки «без агрегаторов» убирают домены, которые попадают в выдачу по очень многим запросам во всех нишах (YouTube, Instagram, Ozon, Яндекс, Википедия, Reddit): их DR 80–100 сдвигает общую медиану. Результаты со всеми сайтами и без агрегаторов нужно читать рядом.
| Позиции | Возраст, медиана лет, все | Возраст, медиана лет, без агрегаторов | DR, медиана, все | DR, медиана, без агрегаторов | Домены старше 15 лет, %, все | Домены старше 15 лет, %, без агрегаторов |
|---|---|---|---|---|---|---|
| 1–5 | 16,8 | 15,5 | 50 | 40 | 58,2 | 52,9 |
| 6–10 | 15,7 | 14,7 | 49 | 39 | 53,1 | 48,6 |
| Топ-10 целиком | 16,1 | 15,1 | 49 | 39 | 55,7 | 50,7 |
| 11–20 | 15,7 | 14,7 | 52 | 38 | 53,7 | 48,6 |
| 21–30 | 15,3 | 14,3 | 55 | 39 | 51,8 | 46,4 |
| 31–40 | 15,0 | 13,8 | 58 | 40 | 50,1 | 44,6 |
| 41–50 | 14,9 | 13,9 | 62 | 43 | 49,5 | 44,2 |
Что в таблице видно. Домены в топ-10 в основном старые: медиана 16 лет со всеми сайтами и 15 лет без агрегаторов, то есть у половины результатов топ-10 домен зарегистрирован в 2010–2011 году или раньше. В топ-5 медиана 16,8 года, на местах 41–50 14,9 года. Разница около двух лет на 40 позиций, и это малая величина. Доля доменов старше 15 лет тоже сползает плавно, с 58% в топ-5 до 50% на местах 41–50 (со всеми сайтами).
Медиана DR в топ-5 равна 50 со всеми сайтами и 40 без агрегаторов. В топ-5 у четверти результатов DR ниже 28 (все) или 22 (без агрегаторов), у четверти выше 77 или 61. Дальше по выдаче картина зависит от того, считать ли агрегаторы. Без них медиана DR почти не меняется: 38–43 на всех шести отрезках от топ-5 до 41–50. Со всеми сайтами она растёт сверху вниз, с 50 в топ-5 до 62 на местах 41–50, потому что гиганты с DR 90–100 чаще стоят в середине и в нижней части выдачи. Это та же причина, по которой общий результат для DR в таблице ниже получился 47,4, меньше 50.
Оговорка о данных. Возраст известен для доменов в зонах .ru, .рф и .su (79,5% результатов), DR получен для 3000 самых частых доменов корпуса (71,1% результатов). Зарубежные зоны и редкие сайты в этих медианах представлены неполно. В топ-5 возраст известен у 8 332 результатов из 9 671, DR у 8 036; на местах 41–50 возраст у 7 407 из 9 579, DR у 6 021.
Медиана показывает середину, а не разброс, и «16 лет» не значит, что все сайты старые. Ниже полное распределение: для каждого отрезка выдачи диапазон, в который попадают 80% результатов (так отрезаются 10% самых молодых и 10% самых старых доменов), и доли результатов по возрастным корзинам.
| Позиции | 80% результатов, лет | Младше 3 лет, % | 3–5 лет, % | 5–10 лет, % | 10–15 лет, % | 15–20 лет, % | 20–25 лет, % | Старше 25 лет, % |
|---|---|---|---|---|---|---|---|---|
| 1–5 | 5,9–28,8 | 3,2 | 4,7 | 14,6 | 19,3 | 20,5 | 13,3 | 24,5 |
| 6–10 | 5,4–28,2 | 2,8 | 5,7 | 17,6 | 20,8 | 20,4 | 12,9 | 19,8 |
| 11–20 | 5,5–28,2 | 3,3 | 5,1 | 17,2 | 20,6 | 20,6 | 13,2 | 20,0 |
| 21–30 | 5,3–28,2 | 4,0 | 5,3 | 16,9 | 22,0 | 20,4 | 12,0 | 19,5 |
| 31–40 | 5,1–27,9 | 4,5 | 5,1 | 17,9 | 22,4 | 19,4 | 11,3 | 19,4 |
| 41–50 | 5,1–27,9 | 4,6 | 5,2 | 17,7 | 23,0 | 19,7 | 11,1 | 18,8 |
В топ-5 80% результатов приходятся на домены от 5,9 до 28,8 года. Самые молодые домены в топ-5 зарегистрированы в год сбора данных, самые старые существуют около 30 лет. Младше 5 лет там 7,9% результатов, младше 10 лет 22,5%, старше 20 лет 37,8%. На местах 41–50 диапазон почти тот же, от 5,1 до 27,9 года, младше 10 лет 27,5% результатов, старше 20 лет 29,9%. Вывод из таблицы: возраст у выдачи разный, с первой позиции по пятидесятую в каждой группе есть и пятилетние домены, и двадцатипятилетние. Сдвиг от верха к низу есть, но небольшой: молодых доменов внизу чуть больше, старых чуть меньше.
| Позиции | 80% результатов, DR, все | 80% результатов, DR, без агрегаторов | DR 0–10, %, без агр. | DR 10–30, %, без агр. | DR 30–50, %, без агр. | DR 50–70, %, без агр. | DR 70–90, %, без агр. | DR 90–100, %, без агр. |
|---|---|---|---|---|---|---|---|---|
| 1–5 | 10–88 | 8–77 | 12,4 | 21,7 | 29,3 | 17,5 | 15,6 | 3,5 |
| 6–10 | 8–90 | 6–76 | 13,8 | 22,2 | 27,2 | 17,8 | 16,8 | 2,2 |
| 11–20 | 8–94 | 5–76 | 15,2 | 22,2 | 25,7 | 17,4 | 16,2 | 3,4 |
| 21–30 | 8–97 | 5–77 | 16,2 | 20,7 | 25,2 | 18,3 | 16,5 | 3,1 |
| 31–40 | 8–99 | 4–78 | 15,8 | 21,3 | 23,1 | 18,3 | 18,0 | 3,5 |
| 41–50 | 8–99 | 4–79 | 15,7 | 20,3 | 20,8 | 20,3 | 19,1 | 3,8 |
DR разбросан ещё шире возраста. В топ-5 80% результатов лежат в диапазоне DR от 10 до 88 со всеми сайтами и от 8 до 77 без агрегаторов: у 12,4% результатов без агрегаторов DR ниже 10, у 34,1% ниже 30, у 19,1% выше 70. Сайт с DR от 0 до 10 попадает в топ-5 так же регулярно, как сайт с DR 70–90 (12,4% и 15,6% результатов). Дальше вниз по выдаче без агрегаторов картина почти не меняется, а со всеми сайтами растёт верхний хвост: на местах 41–50 из-за гигантов 44,5% результатов имеют DR 70 и выше (в топ-5 их 36,3%).
Различают ли возраст и DR топ-20 и остальную выдачу
| Признак | Результат из 100 | 95% интервал | Запросов в расчёте | Запросов, где у топа выше, % | Страниц в расчёте |
|---|---|---|---|---|---|
| Длина страницы | 54,54 | 54,08–54,97 | 2 384 | 65,6 | 84 848 |
| Ссылающиеся домены сайта (Keys.so) | 53,89 | 53,31–54,48 | 2 371 | 60,5 | 61 858 |
| Возраст домена, все | 52,31 | 51,80–52,79 | 2 368 | 58,2 | 67 449 |
| Возраст домена, без агрегаторов | 52,89 | 52,35–53,43 | 2 356 | 58,9 | 57 838 |
| DR Ahrefs, все сайты с DR | 47,35 | 46,77–47,95 | 2 373 | 44,1 | 60 369 |
| DR Ahrefs, без агрегаторов | 51,18 | 50,49–51,82 | 2 289 | 53,2 | 44 758 |
| DR Ahrefs, без доменов с DR 90+ | 51,42 | 50,81–52,03 | 2 323 | 53,5 | 50 827 |
Возраст домена различает группы на уровне списков, 52,3 из 100 (без агрегаторов 52,9): домен страницы из топ-20 старше домена страницы с позиций 21–50 примерно в 52 парах из 100 и моложе в 48. Это четыре-пять лишних пар на сотню. DR при первом взгляде идёт против гипотезы и даёт 47,4: DR страницы из топ-20 выше только в 47 парах из 100 и ниже в 53. Причина видна по корзинам DR на графике ниже. 49 доменов с DR 90–100 дают 9 542 результата, и в топ-20 из них попадает 38,4% против 48,7% в среднем по всем сайтам с DR. Это гиганты вроде YouTube и Instagram, их много в выдаче, но стоят они в середине. Без агрегаторов результат поднимается до 51,2 (50,5–51,8), без доменов с DR 90+ до 51,4. Это слабый перевес, того же порядка, что у списков. Доля топ-20 максимальна в корзине DR 30–50 (54,2%), в следующих корзинах она держится около 48–51%, а у DR 90–100 падает.
Это не значит, что DR не нужен. Он собран для самых частых доменов, поэтому сравнение идёт среди уже заметных сайтов. Общий результат по ссылающимся доменам (53,9 из 100; в прошлом исследовании 54,0, здесь пересчёт с минимумом две страницы в группе) складывается, скорее всего, из другой разницы, между сайтом, на который ссылаются, и сайтом, на который почти не ссылаются. На страницах тех же 3000 доменов число ссылающихся доменов даёт всего 50,4. Среди заметных сайтов оно позицию почти не определяет. Это объяснение гипотетическое, потому что хвост выдачи без DR остался за границей замера.
Когда признаки считаются вместе
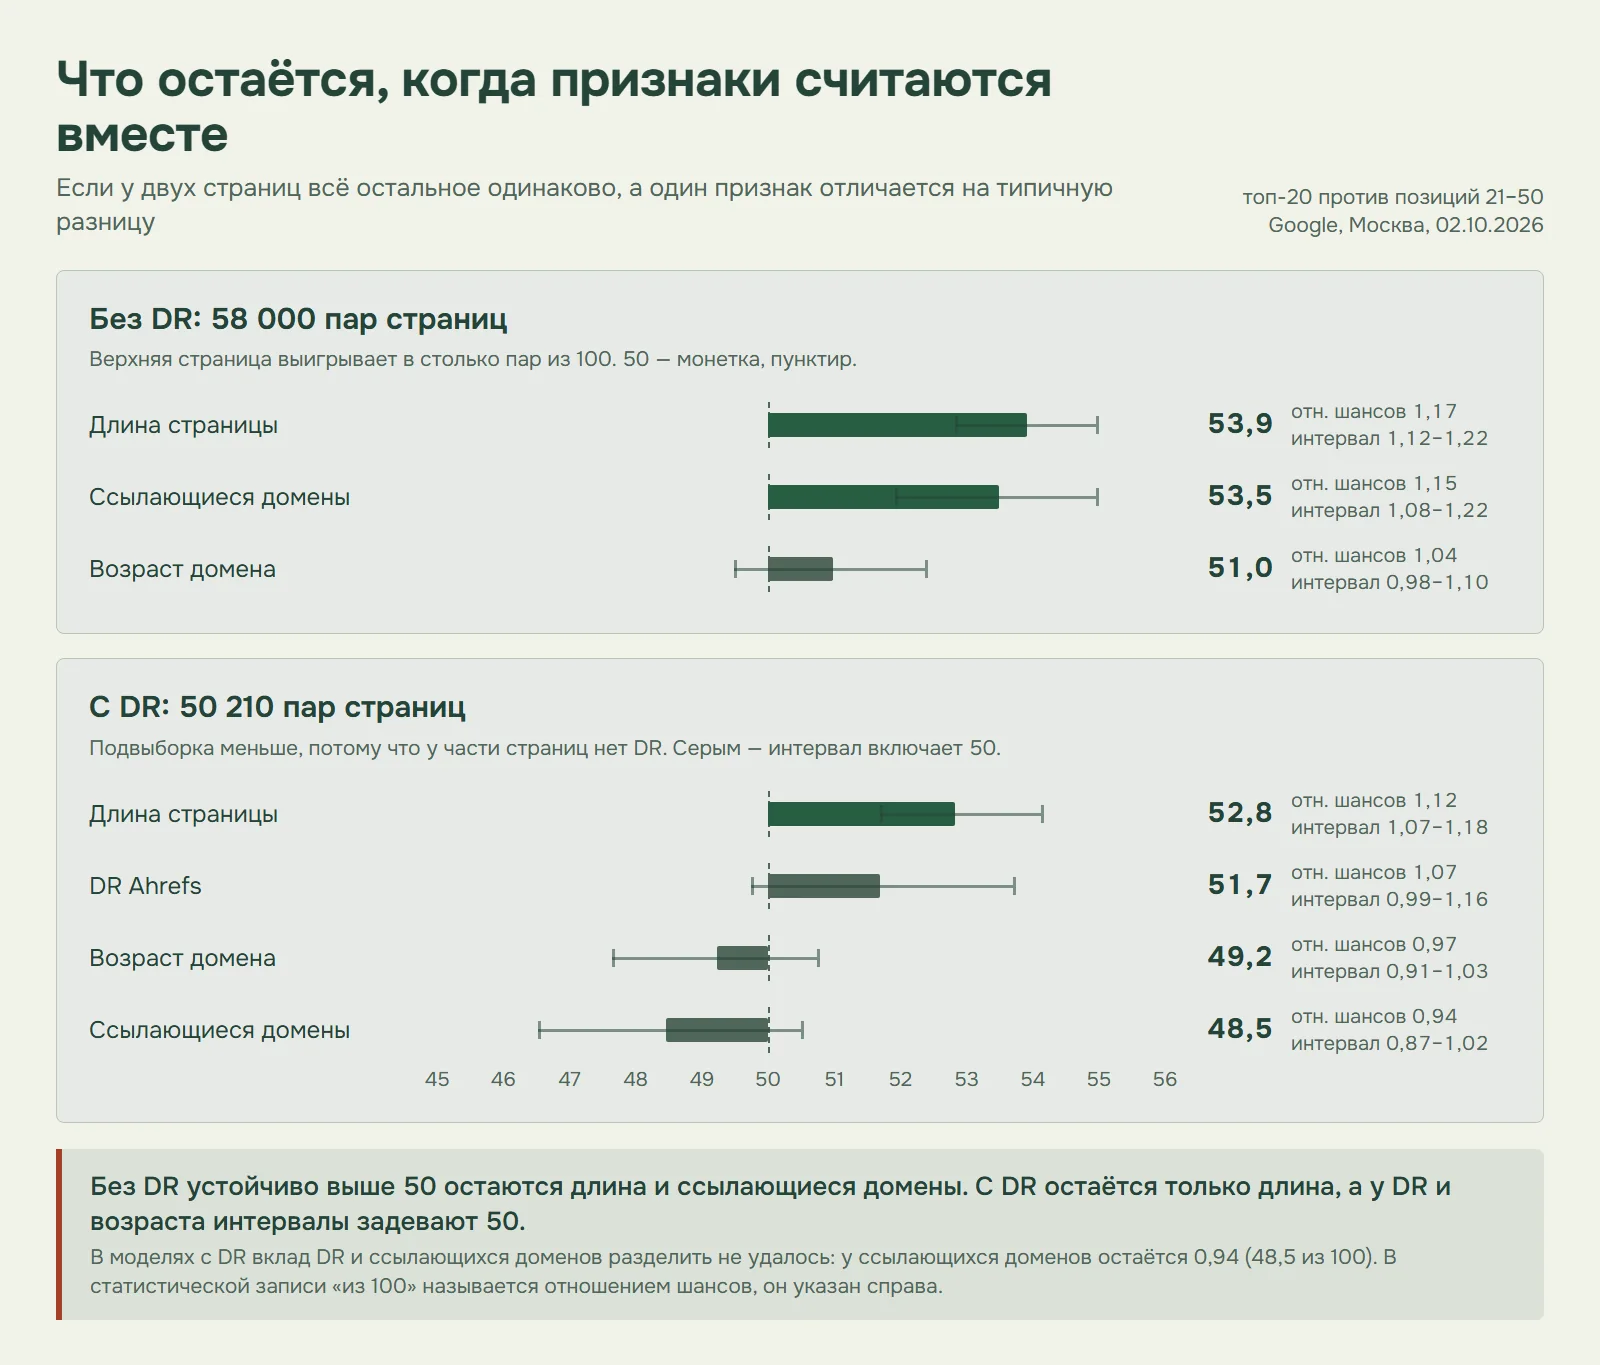
Теперь признаки вместе. Вопрос такой: если у двух страниц уравнять остальное, что из оставшейся разницы всё ещё связано с позицией? Короткий ответ для SEO-специалиста: длина страницы и число ссылающихся доменов сайта связаны с позицией, а DR и возраст домена после них почти ничего не добавляют.
В понятных единицах это выглядит так. Возьмём две страницы одного запроса, одну из топ-20 и одну с позиций 21–50. Типичная разница между ними: по длине одна страница бывает длиннее другой в 3,3 раза, по возрасту домена отличие около 11 лет, по DR около 36 пунктов, по числу ссылающихся доменов в 16–18 раз. Теперь представим, что все остальные признаки у двух страниц одинаковые, а один отличается на такую типичную разницу. Тогда в топ-20 оказывается:
- страница длиннее в 3,3 раза: примерно в 54 случаях из 100;
- страница сайта, на который ссылается в 16–18 раз больше доменов: в 53–54 случаях из 100;
- страница сайта с DR выше на 36 пунктов: примерно в 52 случаях из 100;
- страница сайта старше на 11 лет: примерно в 51 случае из 100.
Монетка даёт 50. У длины и ссылающихся доменов перевес устойчивый. У DR и возраста он в пределах погрешности: интервалы в таблице ниже включают единицу, то есть «связи нет». В статистической записи те же числа называются отношением шансов: 1,17 для длины, 1,15 для ссылающихся доменов, 1,07 для DR, 1,04 для возраста. Единица значит «связи нет», а 1,17 соответствует 54 из 100.
Есть важная оговорка. Модели считались на разных наборах страниц: без DR на 58 000 пар, с DR на 50 210. Когда в модель добавляют DR, у ссылающихся доменов остаётся около единицы (0,94), и у возраста тоже (0,97). Скорее всего, DR и число ссылающихся доменов измеряют одно и то же, силу ссылочного профиля сайта, и разделить их вклады эти данные не позволяют (зависимость между ними я отдельно не проверял). Поэтому вывод осторожный: ссылочный профиль сайта связан с позицией, а что в нём важнее, число доноров или DR, неизвестно.
Возраст домена в этих данных ведёт себя как возможный заместитель ссылок: у старого сайта чаще много ссылающихся доменов. Смотрит ли Google на саму дату регистрации, данные не показывают.
Результат зависит и от способа расчёта. Если учитывать повторы только по запросам, а не по доменам, интервалы возраста (1,00–1,08) и DR (1,02–1,13) сдвигаются от единицы: связь слабая, но не нулевая. Поэтому о возрасте и DR я говорю как о слабом сигнале на границе, а не как об отсутствии связи.
| Модель | Признак | Отношение шансов на 1 SD | 95% интервал | p | Пар / запросов |
|---|---|---|---|---|---|
| DR отдельно | DR Ahrefs | 0,85 | 0,76–0,94 | 0,002 | 58 398 / 2 351 |
| Возраст отдельно | Возраст домена | 1,11 | 1,06–1,16 | меньше 0,001 | 58 915 / 2 358 |
| DR + длина | DR Ahrefs | 0,87 | 0,80–0,95 | 0,002 | 58 398 / 2 351 |
| Длина (логарифм) | 1,20 | 1,14–1,26 | меньше 0,001 | ||
| Возраст + длина + ссылающиеся домены | Возраст домена | 1,04 | 0,98–1,10 | 0,179 | 58 000 / 2 330 |
| Длина (логарифм) | 1,17 | 1,12–1,22 | меньше 0,001 | ||
| Ссылающиеся домены (логарифм) | 1,15 | 1,08–1,22 | меньше 0,001 | ||
| DR + возраст + длина + ссылающиеся домены | DR Ahrefs | 1,07 | 0,99–1,16 | 0,080 | 50 210 / 2 086 |
| Возраст домена | 0,97 | 0,91–1,03 | 0,346 | ||
| Длина (логарифм) | 1,12 | 1,07–1,18 | меньше 0,001 | ||
| Ссылающиеся домены (логарифм) | 0,94 | 0,87–1,02 | 0,162 |
Сайты выдачи: DR, регистрация, история
Через Ahrefs я прогнал 26 доменов. Это 20 сайтов, чаще всего стоящих в топ-20 корпуса, и шесть лидеров по доле попаданий из таблицы выше. Даты регистрации взяты из реестра зоны (.ru) и RDAP (.com, .org); для nalog.gov.ru прочерк, потому что реестровая запись относится ко всей зоне gov.ru. История — первый снимок в Wayback Machine и самый долгий перерыв между снимками. У поддоменов DR общий, поэтому market.yandex.ru и realty.yandex.ru представлены строкой yandex.ru, а ru.wikipedia.org строкой wikipedia.org.
Таблица: 20 самых частых сайтов топ-20
| Сайт | Страниц в топ-20 | DR | Регистрация домена | Первый снимок в архиве | Самый долгий перерыв архива, лет |
|---|---|---|---|---|---|
| youtube.com | 1044 | 99 | 2005-02-15 | — | — |
| profi.ru | 376 | 80 | 1997-10-14 | 1998-05-23 | 5,9 |
| t-j.ru | 281 | 77 | 2024-11-05 | 2014-01-05 | 1,8 |
| sravni.ru | 256 | 76 | 2001-09-10 | 2002-01-25 | 1,9 |
| consultant.ru | 219 | 91 | 1996-12-17 | 1997-02-08 | 0,9 |
| ozon.ru | 204 | 91 | 1998-02-09 | 1998-11-11 | 0,5 |
| yandex.ru | 709 | 94 | 1997-09-23 | 1998-12-06 | 1 |
| lemanapro.ru | 301 | 73 | 2023-07-03 | 2024-06-28 | 0,1 |
| wikipedia.org | 176 | 97 | 2001-01-13 | 2001-07-27 | 1 |
| drive2.ru | 150 | 79 | 2007-01-17 | 2008-06-10 | 0,7 |
| banki.ru | 149 | 78 | 1999-08-30 | 2000-02-01 | 1,5 |
| cian.ru | 148 | 82 | 2001-09-10 | 2001-12-04 | 1 |
| nalog.gov.ru | 140 | 86 | — | 2021-02-09 | 0,1 |
| finuslugi.ru | 133 | 71 | 2006-11-15 | 2004-12-16 | 8,9 |
| kp.ru | 131 | 84 | 1997-10-20 | 1998-12-12 | 0,8 |
| tbank.ru | 177 | 90 | 2019-11-07 | 2021-12-26 | 2,2 |
| habr.com | 124 | 88 | 2003-03-11 | 2001-07-14 | 2,3 |
| zoon.ru | 119 | 82 | 2005-08-24 | 2012-03-01 | 0,3 |
| sberbank.ru | 118 | 86 | 2008-07-25 | 1999-01-25 | 4 |
| okno.ru | 117 | 49 | 1998-09-21 | 2000-09-19 | 1,1 |
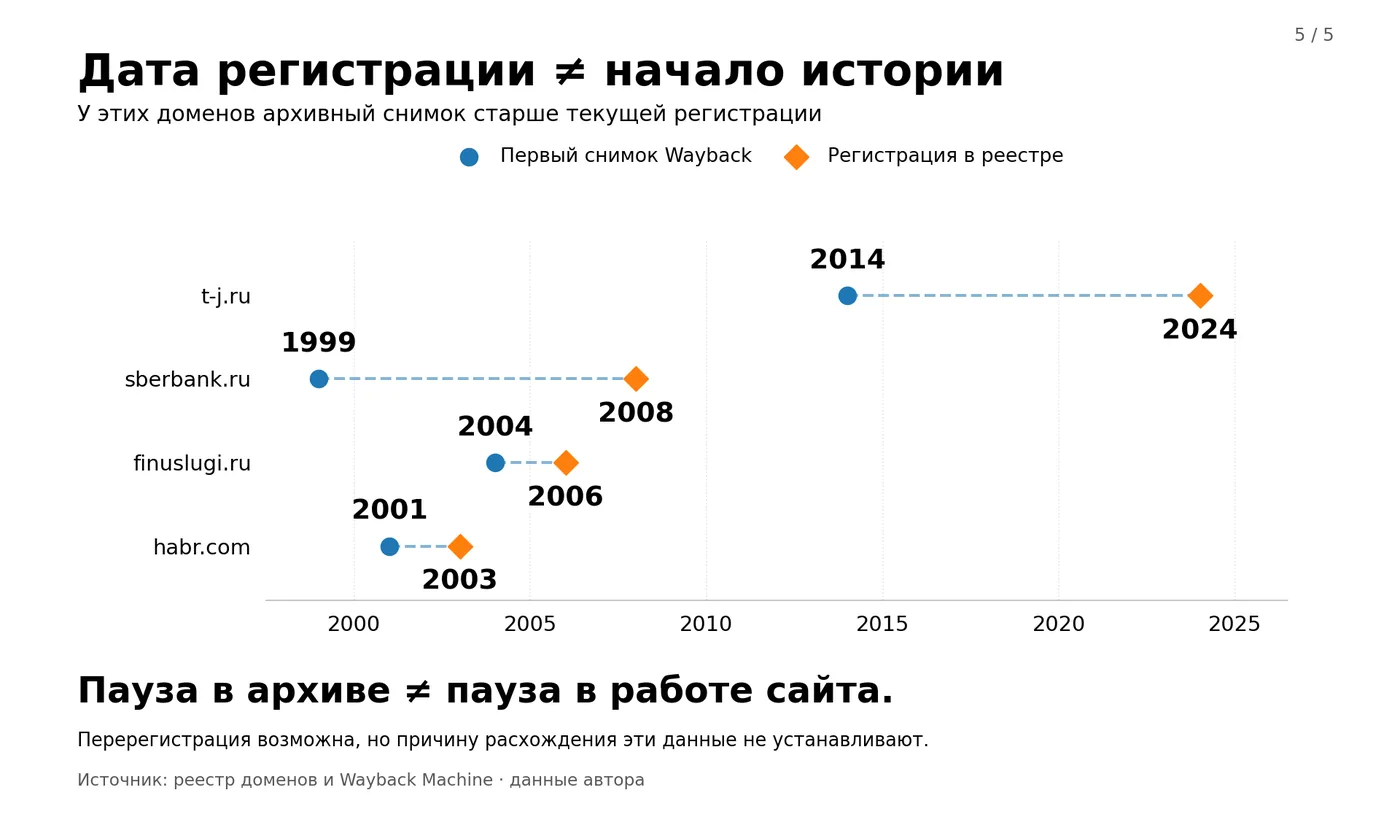
У 20 самых частых сайтов DR лежит в диапазоне от 49 до 99, медиана 83. Из них 16 из 19 сайтов с известной датой регистрации заведены до 2010 года. У четырёх сайтов первый снимок в архиве раньше даты регистрации. Это t-j.ru (регистрация 5 ноября 2024, снимки с 2014 года, самый молодой по реестру), sberbank.ru (2008 против 1999), finuslugi.ru (2006 против 2004) и habr.com (2003 против 2001). Так бывает при перерегистрации домена или его переходе к другому владельцу; причину данные не называют. Три сайта с самыми долгими перерывами в архиве — finuslugi.ru, mybox.ru и profi.ru. Перерыв в архиве не равен перерыву в работе сайта, ведь Wayback мог просто не снимать его в эти годы.
Таблица: шесть сайтов-лидеров по доле попаданий
| Сайт | Страниц в топ-20 | DR | Регистрация домена | Первый снимок в архиве | Самый долгий перерыв архива, лет |
|---|---|---|---|---|---|
| petrovich.ru | 114 | 70 | 1998-04-25 | 1998-12-12 | 0,5 |
| domrfbank.ru | 50 | 72 | 2017-05-11 | 2018-11-14 | 0,3 |
| mybox.ru | 28 | 45 | 2004-10-05 | 2001-03-01 | 7,6 |
| yamdiet.com | 30 | 25 | 2014-04-12 | 2014-10-24 | 0,5 |
| evis-motors.ru | 25 | 3,6 | 2021-04-09 | 2003-06-03 | 1,1 |
| rsb.ru | 25 | 67 | 2005-11-23 | 1999-01-17 | 3,7 |
У шести лидеров по доле страниц в топ-20 общего ссылочного профиля нет. DR от 3,6 у evis-motors.ru и 25 у yamdiet.com до 67–72 у rsb.ru, petrovich.ru и domrfbank.ru. Возраст регистрации тоже разный, от 1998 года у petrovich.ru до 2021 у evis-motors.ru. По таблице выше каждый из них встречается в 26–61 запросах корпуса (считая страницы указанного хоста), поэтому такое лидерство говорит скорее о пересечении сайта с запросами выборки, чем о силе домена.
Domain Rating by Ahrefs, бесплатный API, запрос 13.10.2026. Реестр зоны .ru: данные R01 на 03.10.2026. RDAP: Verisign (.com) и Public Interest Registry (.org). История: Wayback Machine CDX; у youtube.com архив не ответил с пяти попыток (HTTP 502 и 504), поэтому прочерк.
Что можно доказать, а что нет
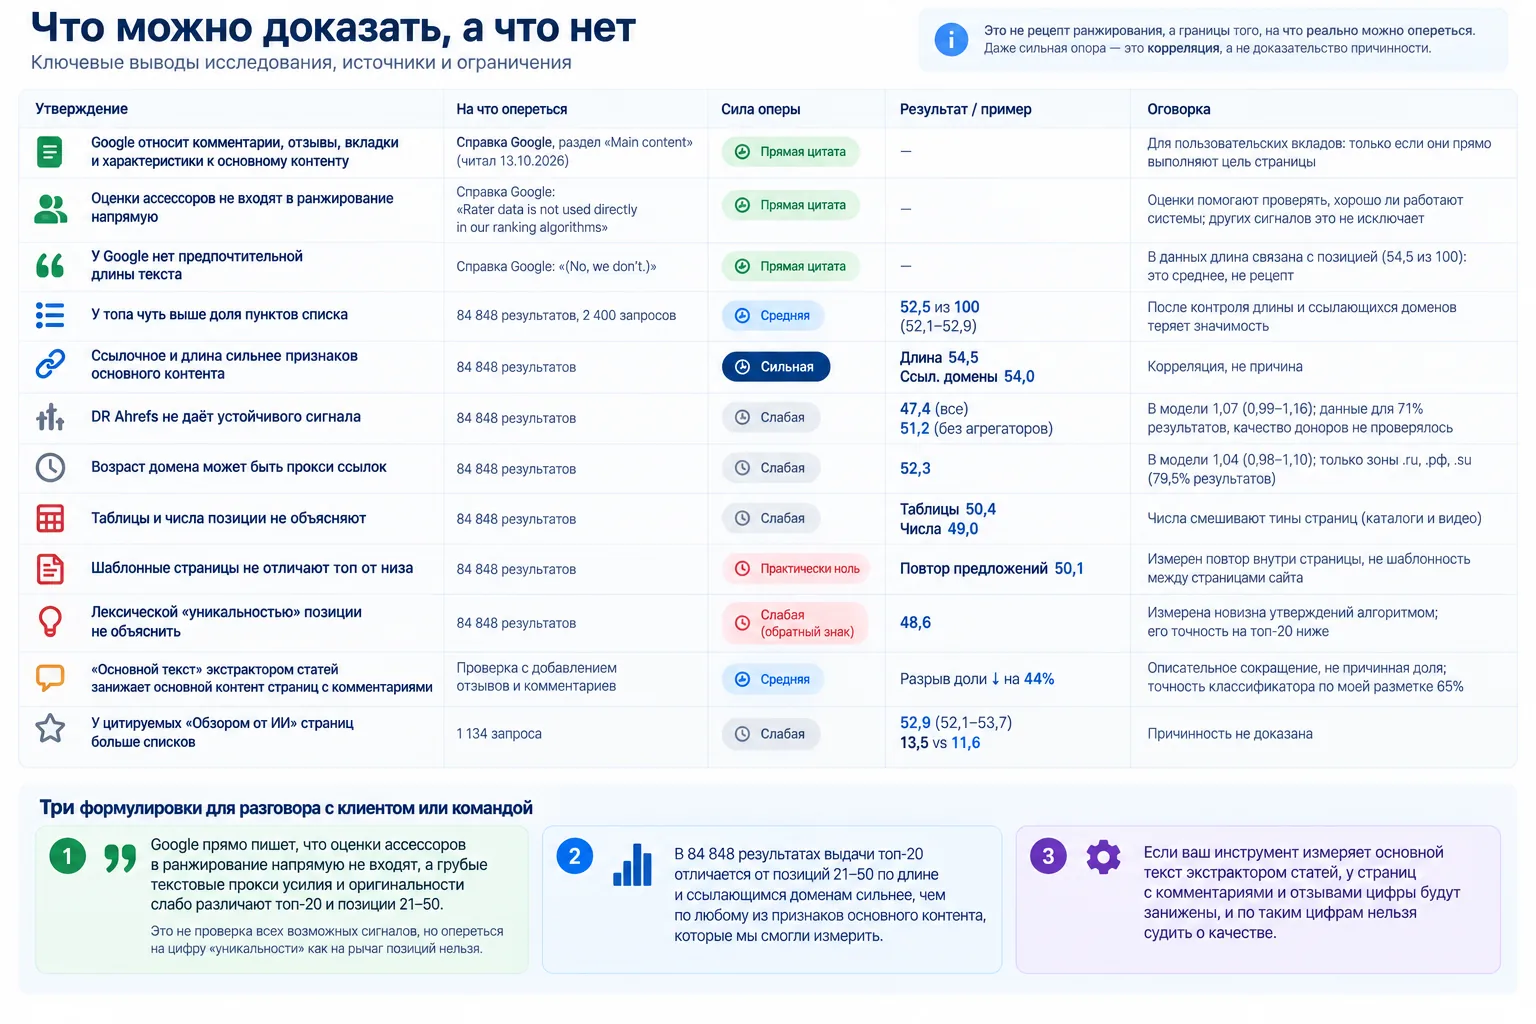
| Утверждение | На что опереться | Сила опоры | Оговорка |
|---|---|---|---|
| Google относит комментарии, отзывы, вкладки и характеристики к основному контенту | Справка Google, раздел «Main content» (читал 13.10.2026) | прямая цитата | Для пользовательских вкладов: только если они прямо выполняют цель страницы |
| Оценки асессоров не входят в ранжирование напрямую | Справка Google: «Rater data is not used directly in our ranking algorithms» | прямая цитата | Оценки помогают Google проверять, хорошо ли работают его системы; других сигналов, связанных с усилием и оригинальностью, это не исключает |
| У Google нет предпочтительной длины текста | Справка Google: «(No, we don't.)» | прямая цитата | В данных длина всё же связана с позицией (54,5 из 100): это среднее, не рецепт |
| У топа чуть выше доля пунктов списка | 52,5 (52,1–52,9) из 100; в 58,8% запросов у топа выше; 84 848 результатов выдачи | средняя | После контроля длины и ссылающихся доменов теряет значимость |
| Ссылочное и длина сильнее признаков основного контента | 54,0 и 54,5 из 100; в совместной модели значимы длина (1,17) и ссылающиеся домены (1,15) | сильная | Корреляция, не причина; данные ссылающихся доменов по Keys.so |
| DR Ahrefs не даёт устойчивого сигнала | 47,4 из 100 со всеми сайтами, 51,2 без агрегаторов; в совместной модели 1,07 (0,99–1,16) | слабая | DR собран для 71% результатов (3000 самых частых доменов), хвост выдачи не охвачен; качество доноров не проверялось |
| Возраст домена может быть прокси ссылок | 52,3 из 100; после контроля длины и ссылающихся доменов 1,04 (0,98–1,10) | слабая | Самостоятельная связь не выявлена, механизм не доказан; возраст только для зон .ru, .рф, .su (79,5% результатов) |
| Таблицы и числа позиций не объясняют | 50,4 и 49,0 из 100; у топа числа в 53,8% запросов ниже | слабая | Числа смешивают типы страниц (каталоги и видео) |
| Шаблонные страницы не отличают топ от низа | повтор предложений 50,1 | практически ноль | Измерен повтор внутри страницы, не шаблонность между страницами сайта |
| Лексической «уникальностью» позиции не объяснить | 48,6 из 100; в 52,4% запросов у топа ниже | слабая, обратного знака | Измерена новизна утверждений, которые находит алгоритм; точность алгоритма на топ-20 ниже |
| «Основной текст» экстрактором статей занижает основной контент страниц с комментариями | при добавлении отзывов и комментариев разрыв доли основного текста сокращается на 44% | средняя | Описательное сокращение, не причинная доля; классификатор по названиям классов, точность по моей разметке 65% |
| У цитируемых «Обзором от ИИ» страниц больше списков | 52,9 (52,1–53,7) из 100; медиана 13,5 против 11,6 по 1 134 запросам | слабая | Причинность не доказана |
Три формулировки для разговора с клиентом или командой, которые держатся на этих данных. Первая: «Google прямо пишет, что оценки асессоров в ранжирование напрямую не входят, а грубые текстовые прокси усилия и оригинальности слабо различают топ-20 и позиции 21–50. Это не проверка всех возможных сигналов, но опереться на цифру „уникальности“ как на рычаг позиций нельзя». Вторая: «В 84 848 результатах выдачи топ-20 отличается от позиций 21–50 по длине и ссылающимся доменам сильнее, чем по любому из признаков основного контента, которые мы смогли измерить». Третья: «Если ваш инструмент измеряет основной текст экстрактором статей, у страниц с комментариями и отзывами цифры будут занижены, и по таким цифрам нельзя судить о качестве».
Почему у верхних страниц меньше «основного» текста
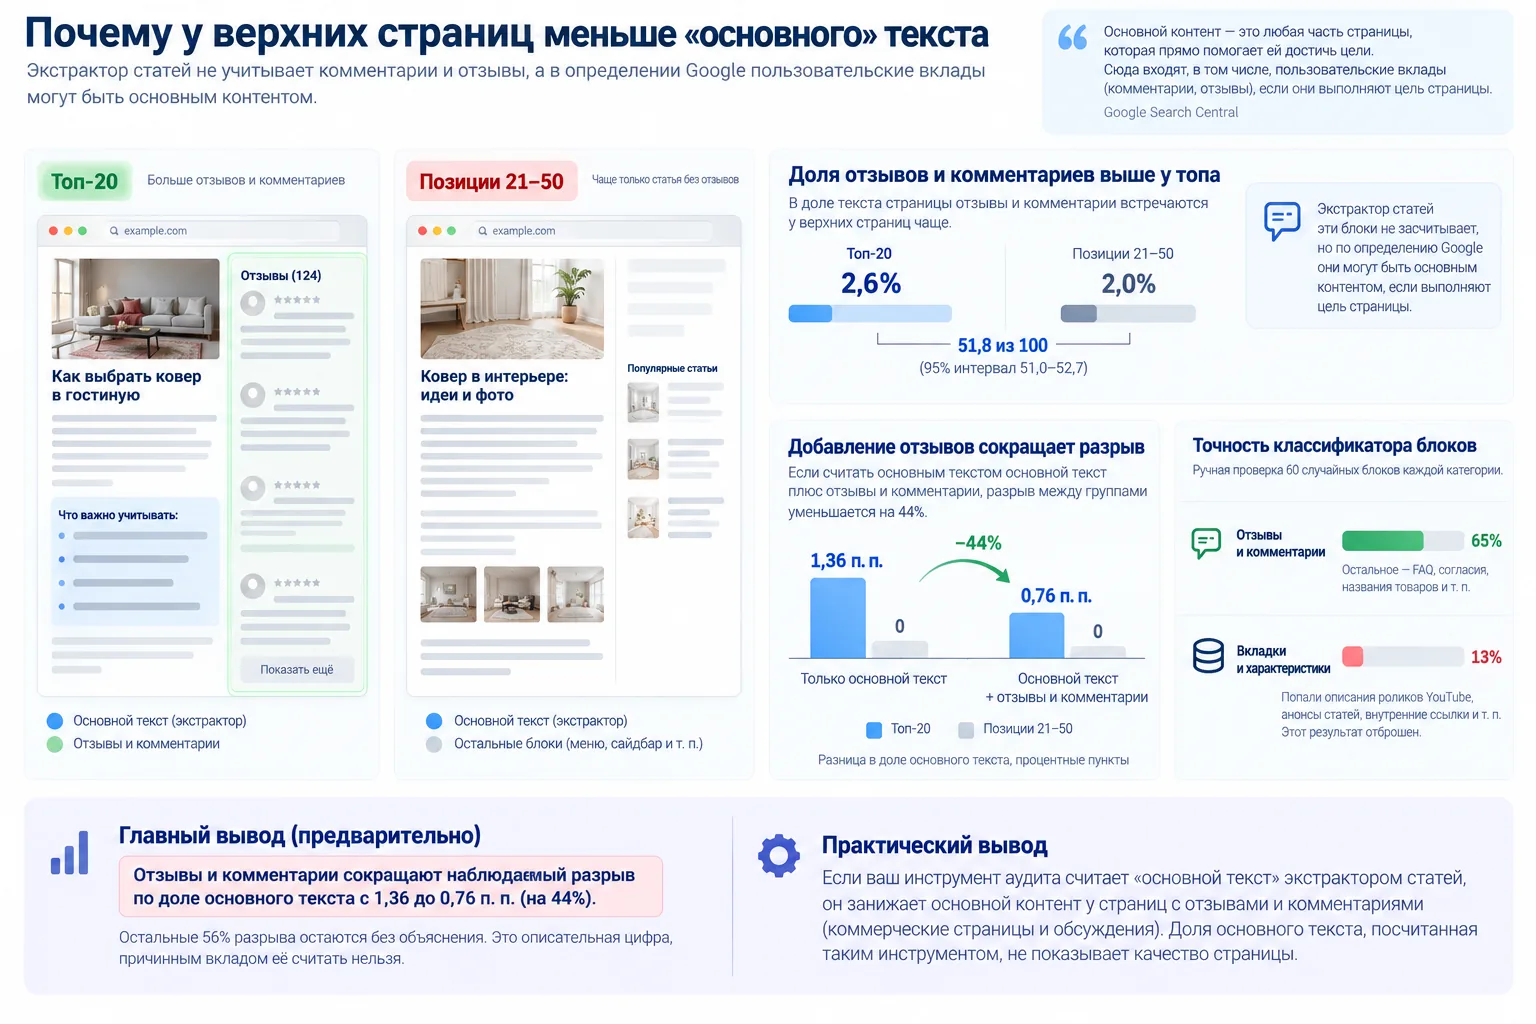
В основном сравнении сильнее всего группы различают списки (52,5), а у доли основного текста 49,0. А на парах страниц близкой длины этот признак даёт 45,2, и это самый заметный результат такой проверки. Выглядело как парадокс, ведь чем выше страница, тем меньше в ней «основного». Подсказку дал разбор выдачи выше. Экстрактор не засчитывает комментарии, а в определении Google пользовательские вклады могут быть основным контентом.
Я проверил это на случайной выборке из 300 запросов (10 666 страниц), заранее записав критерии подтверждения. Остаток страницы, то есть всё, что вошло в её текст, но не в основной, я разложил по типам блоков по разметке HTML. Отзывов и комментариев у верхних страниц оказалось больше, 2,6% текста страницы против 2,0% (51,8 из 100, интервал 51,0–52,7). По записанному заранее правилу первичная проверка дала частичное подтверждение, потому что добавление этих блоков сблизило результат с 50 на 1,18 пункта при пороге 1,5. После аудита классификатора (ниже) вывод остаётся предварительным.
Потом я проверил сам классификатор, потому что на страницах Госуслуг он ошибся. Вручную разметил по 60 случайных блоков двух категорий. Отзывы и комментарии определялись верно в 65% случаев; остальное — вопросы из FAQ самих сайтов, согласия на обработку данных и названия товаров. Категория «вкладки и характеристики» подходила под определение Google в 13% случаев: туда попали описания роликов YouTube, анонсы статей, списки внутренних ссылок и карточки авиарейсов. Результат по этой категории я отбросил.
Что остаётся. Если считать основным текстом основной текст плюс отзывы и комментарии, разрыв между группами по доле основного текста сокращается с 1,36 до 0,76 процентного пункта. Наблюдаемый разрыв при добавлении размеченных отзывов и комментариев сократился на 44%. Это описательная цифра, причинным вкладом её считать нельзя. Классификатор проверял один оценщик, и в какую сторону он ошибается в целом по корпусу, неизвестно. Остальные 56% разрыва остаются без объяснения. Первый вариант проверки показывал 72%, но он включал и вкладки, которые аудит не выдержали.
Практический вывод не про позиции. Если ваш инструмент аудита считает «основной текст» экстрактором статей, он занижает основной контент у страниц с отзывами и комментариями, то есть у коммерческих страниц и обсуждений. Доля основного текста, посчитанная таким инструментом, не показывает качество страницы.
Что цитирует «Обзор от ИИ»
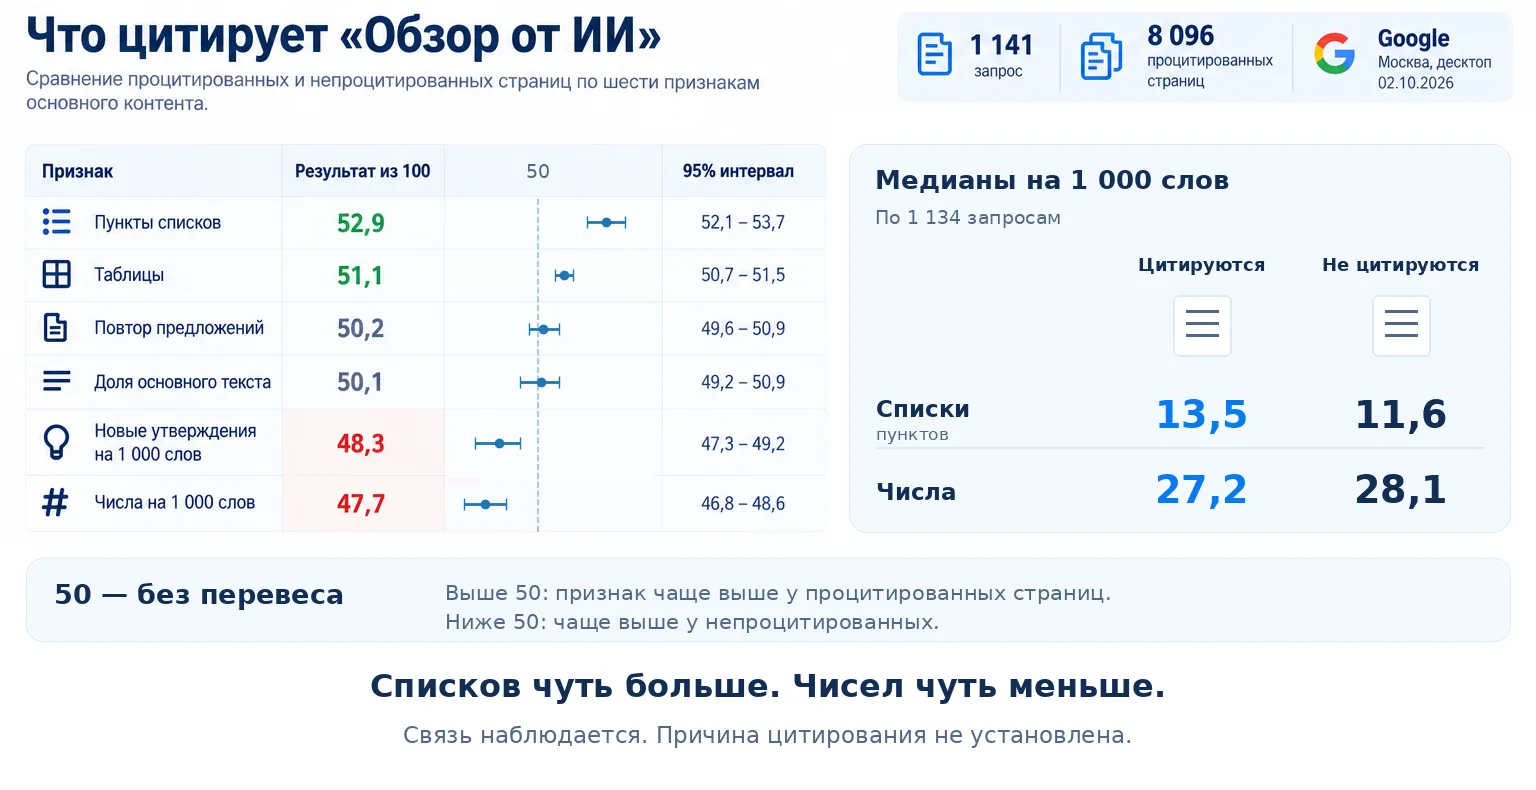
Я прогнал те же шесть признаков по страницам, которые Google цитирует в блоке «Обзор от ИИ»: 1 141 запрос, 8 096 процитированных страниц в корпусе.
| Признак | Результат из 100 | 95% интервал |
|---|---|---|
| Пункты списков | 52,9 | 52,1–53,7 |
| Таблицы | 51,1 | 50,7–51,5 |
| Повтор предложений | 50,2 | 49,6–50,9 |
| Доля основного текста | 50,1 | 49,2–50,9 |
| Новые утверждения на 1 000 слов | 48,3 | 47,3–49,2 |
| Числа на 1 000 слов | 47,7 | 46,8–48,6 |
Процитированные страницы чаще содержат списки и реже насыщены числами на 1 000 слов, чем непроцитированные. В медианах по 1 134 запросам это 13,5 пункта списков против 11,6 у непроцитированных страниц и 27,2 числа против 28,1. Что именно в списках и числах работает для цитирования, этот замер не определяет.
Разбор страницы и маршрут аудита
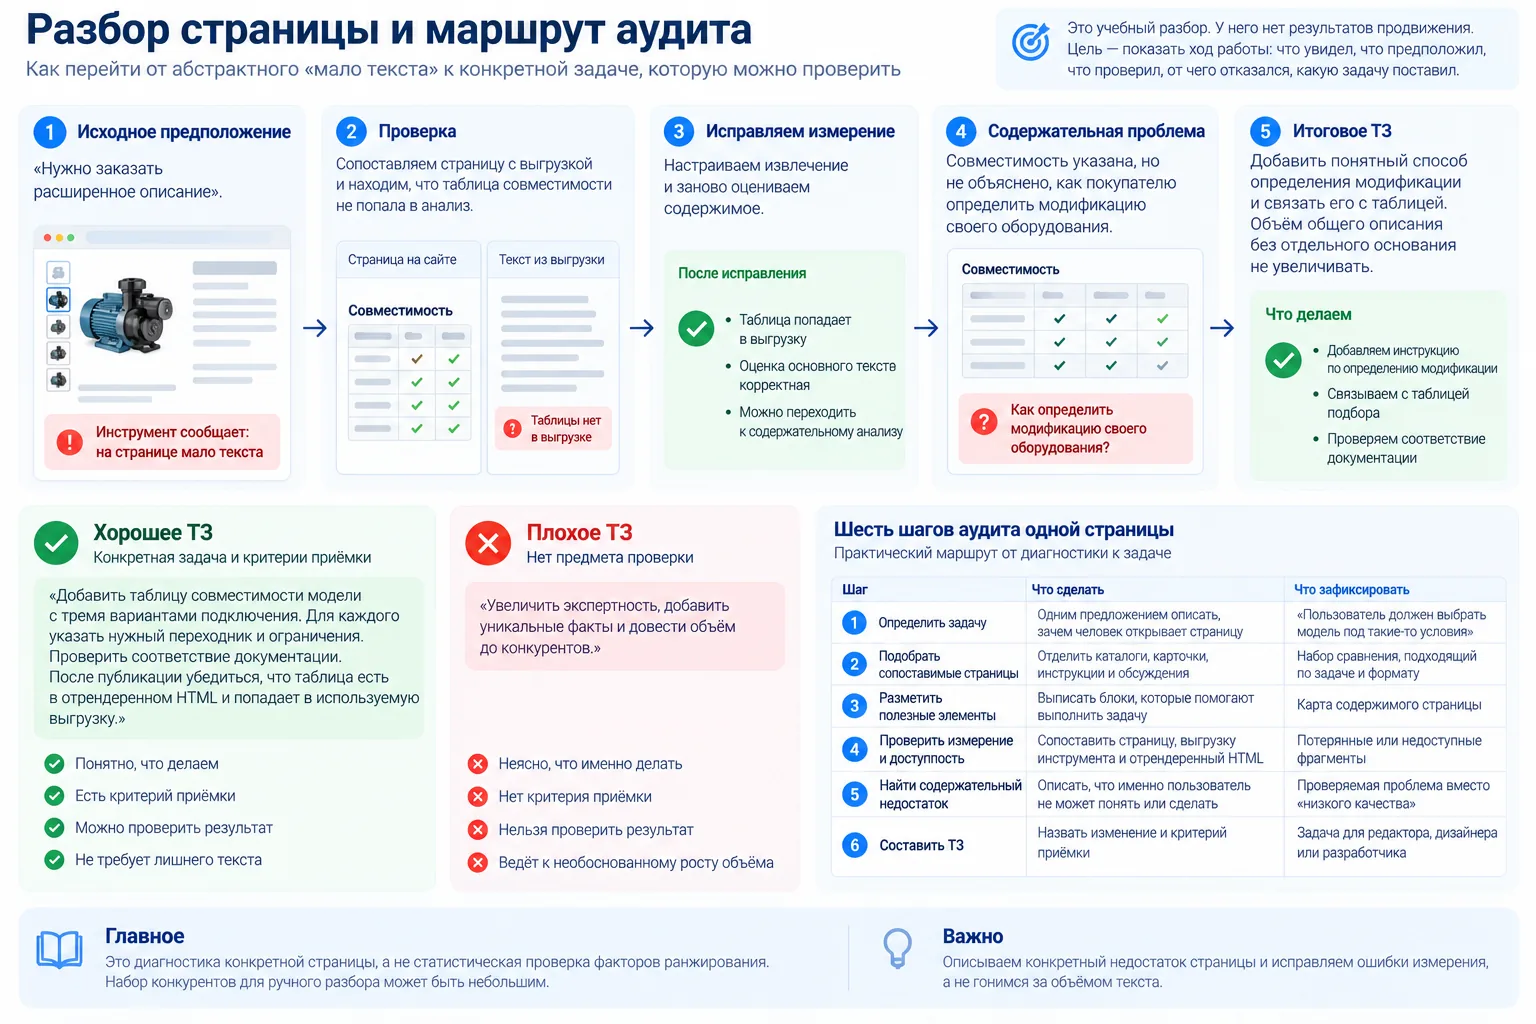
Дальше учебный разбор. Он гипотетический, результатов продвижения у него нет: цель в том, чтобы показать ход работы. Цепочка такая: что увидел, что предположил, что проверил, от чего отказался, какую задачу поставил.
Учебная ситуация: инструмент сообщает, что на карточке мало текста
- Исходное предположение. Нужно заказать расширенное описание.
- Проверка. Специалист сопоставляет страницу с выгрузкой и находит, что таблица совместимости не попала в анализ.
- Следующее действие. Исправляет извлечение и заново оценивает содержимое.
- Содержательная проблема. Совместимость указана, но не объяснено, как покупателю определить модификацию своего оборудования.
- Итоговое ТЗ. Добавить понятный способ определения модификации и связать его с таблицей подбора. Объём общего описания без отдельного основания не увеличивать.
Что установлено в итоге: конкретный недостаток страницы и ошибка измерения, на исправление которой не пришлось тратить новый текст. Что не доказано: что такое изменение поднимет позиции.
Хорошее и плохое ТЗ
Хорошее: добавить таблицу совместимости модели с тремя вариантами подключения. Для каждого указать нужный переходник и ограничения. Проверить соответствие документации. После публикации убедиться, что таблица есть в отрендеренном HTML и попадает в используемую выгрузку.
Плохое: увеличить экспертность, добавить уникальные факты и довести объём до конкурентов. В такой задаче нет предмета проверки, и принять её нельзя.
Основной маршрут: проверяем свою страницу
| Шаг | Что сделать | Что зафиксировать |
|---|---|---|
| 1. Определить задачу | Одним предложением описать, зачем человек открывает страницу | «Пользователь должен выбрать модель под такие-то условия» |
| 2. Подобрать сопоставимые страницы | Отделить каталоги, карточки, инструкции и обсуждения | Набор сравнения, подходящий по задаче и формату |
| 3. Разметить полезные элементы | Выписать блоки, которые помогают выполнить задачу | Карта содержимого страницы |
| 4. Проверить измерение и доступность | Сопоставить страницу, выгрузку инструмента и отрендеренный HTML | Потерянные или недоступные фрагменты |
| 5. Найти содержательный недостаток | Описать, что именно пользователь не может понять или сделать | Проверяемая проблема вместо «низкого качества» |
| 6. Составить ТЗ | Назвать изменение и критерий приёмки | Задача для редактора, дизайнера или разработчика |
Это диагностика конкретной страницы, а не статистическая проверка факторов ранжирования. Набор конкурентов для ручного разбора может быть небольшим.
Как проверить это на своих запросах
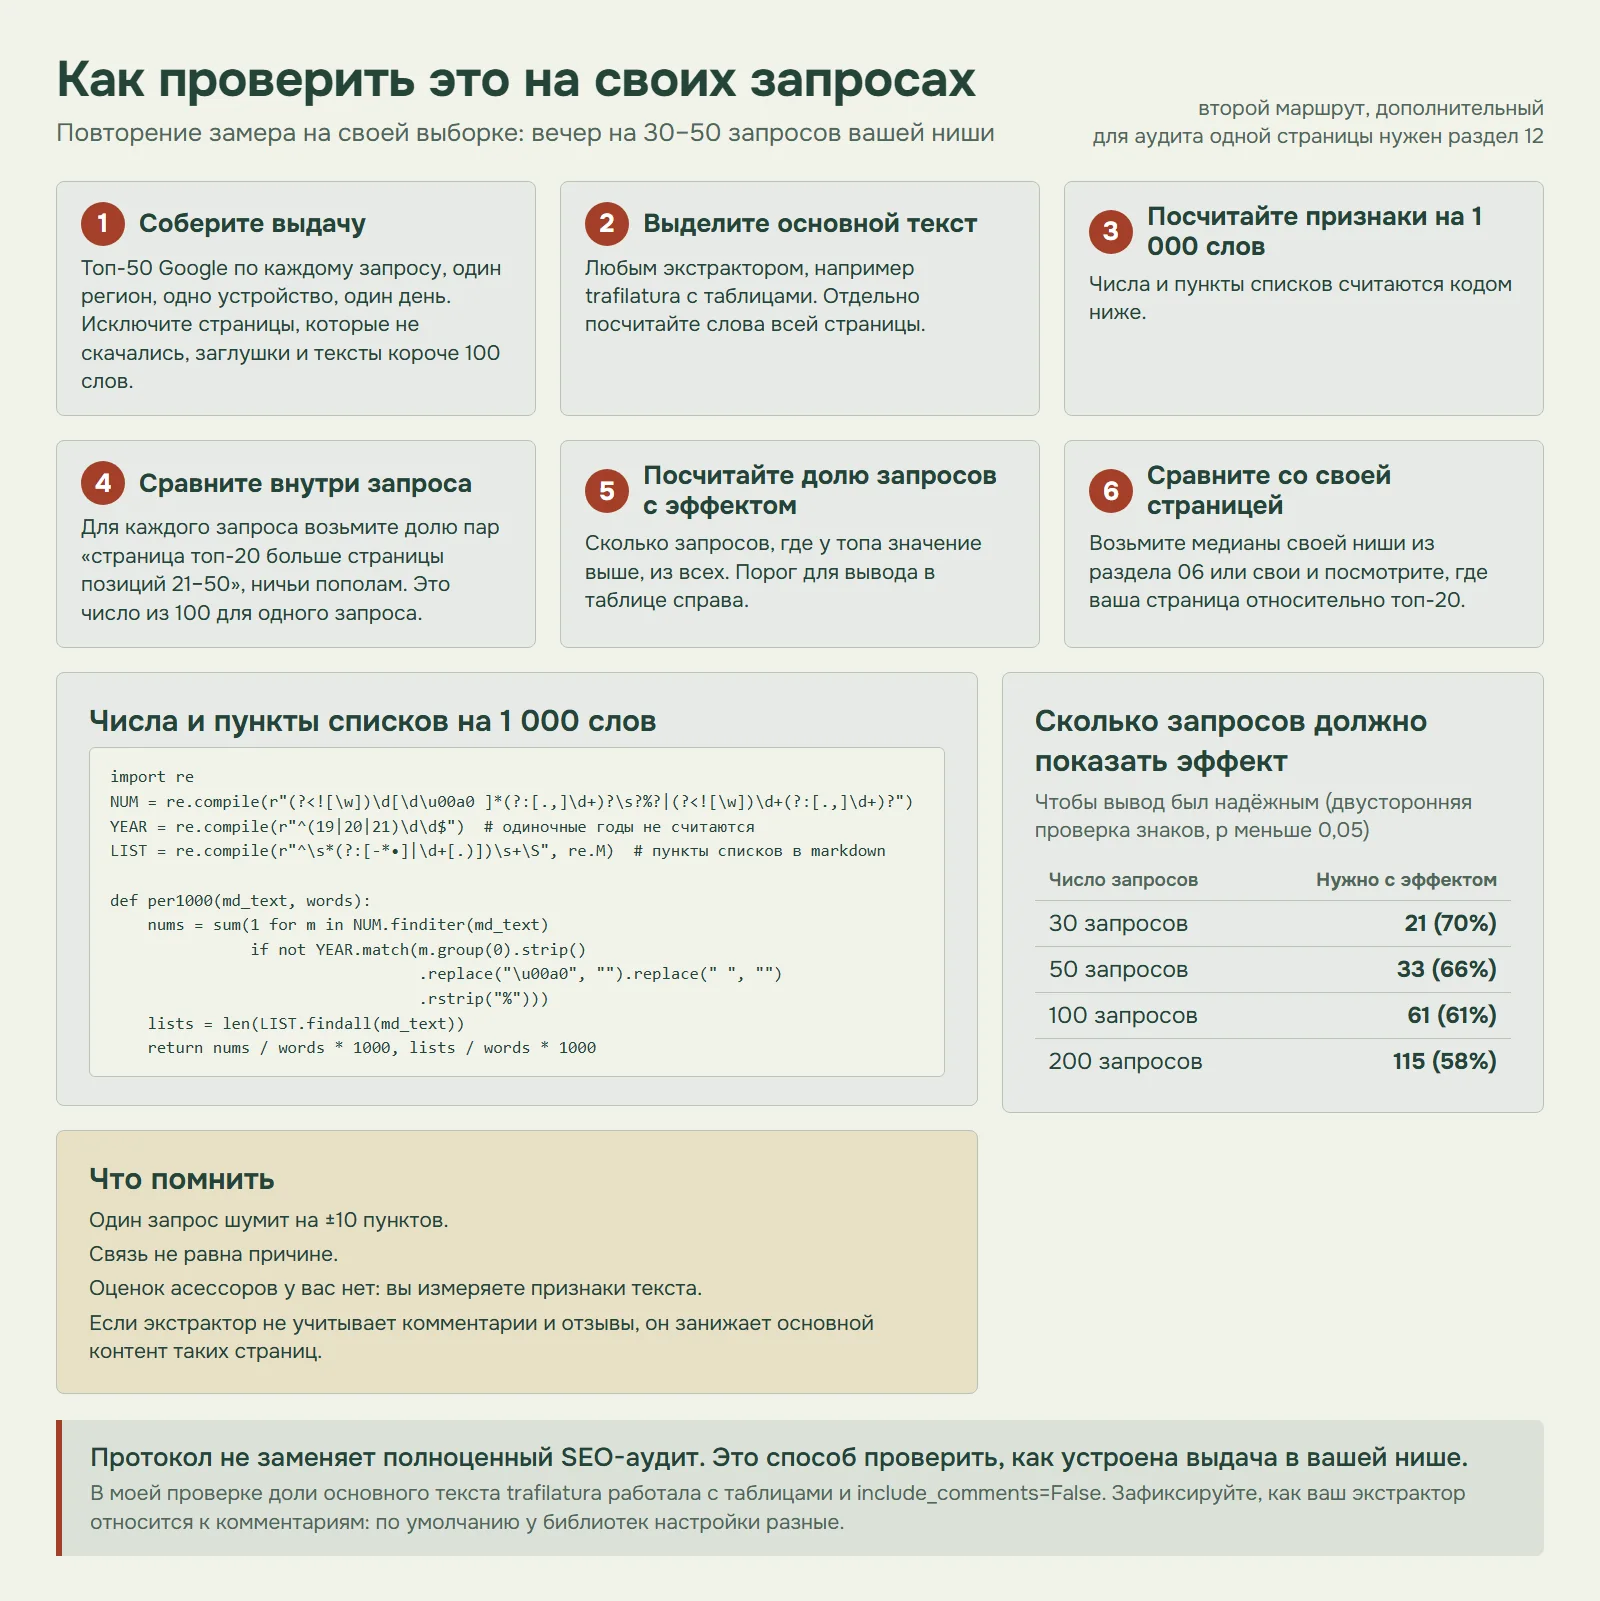
Это второй, дополнительный маршрут: повторение замера на своей выборке. Для аудита одной страницы нужен предыдущий раздел. Правила отбора ниже (например, исключение текстов короче 100 слов) относятся к исследованию, и в ручной проверке полезную короткую страницу отбрасывать не нужно.
Протокол можно повторить без нашего корпуса. Он занимает вечер на 30–50 запросов вашей ниши.
- Соберите выдачу. Топ-50 Google по каждому запросу, один регион и одно устройство, в один день. Страницы, которые не скачались, заглушки и тексты короче 100 слов исключите.
- Выделите основной текст. Любым экстрактором (в проверке доли основного текста я запускал trafilatura с таблицами и
include_comments=False) и отдельно посчитайте слова всей страницы. Зафиксируйте, как ваш экстрактор относится к комментариям и вкладкам: по умолчанию настройки у библиотек разные, и проверять нужно фактический результат на вашем сайте. - Посчитайте признаки на 1 000 слов. Числа и пункты списков считаются так:
import re
NUM = re.compile(r"(?<![\w])\d[\d\u00a0 ]*(?:[.,]\d+)?\s?%?|(?<![\w])\d+(?:[.,]\d+)?")
YEAR = re.compile(r"^(19|20|21)\d\d$")                       # одиночные годы не считаются
LIST = re.compile(r"^\s*(?:[-*•]|\d+[.)])\s+\S", re.M)       # пункты списков в markdown

def per1000(md_text, words):
    nums = sum(1 for m in NUM.finditer(md_text)
               if not YEAR.match(m.group(0).strip().replace("\u00a0", "").replace(" ", "").rstrip("%")))
    lists = len(LIST.findall(md_text))
return nums / words * 1000, lists / words * 1000- Сравните внутри запроса. Для каждого запроса возьмите доли пар «страница топ-20 больше страницы позиций 21–50» (ничьи пополам). Это число из 100 для одного запроса. Не делайте выводов по одному запросу: он шумит на ±10 пунктов.
- Посчитайте долю запросов с эффектом. Сколько запросов, где у топа значение выше, из всех. Порог для вывода (двусторонняя проверка знаков, p меньше 0,05): при 30 запросах нужно 21 (70%), при 50 запросах 33 (66%), при 100 запросах 61 (61%), при 200 запросах 115 (58%).
- Сравните со своей страницей. Возьмите медианы вашей ниши (таблица выше) или свои и посмотрите, где ваша страница относительно топ-20. Это ориентир для разговора, не оценка качества.
- Назовите границу. Скажите, что вы измерили признаки текста (оценок асессоров у вас нет) и что связь не равна причине.
Что это меняет на практике
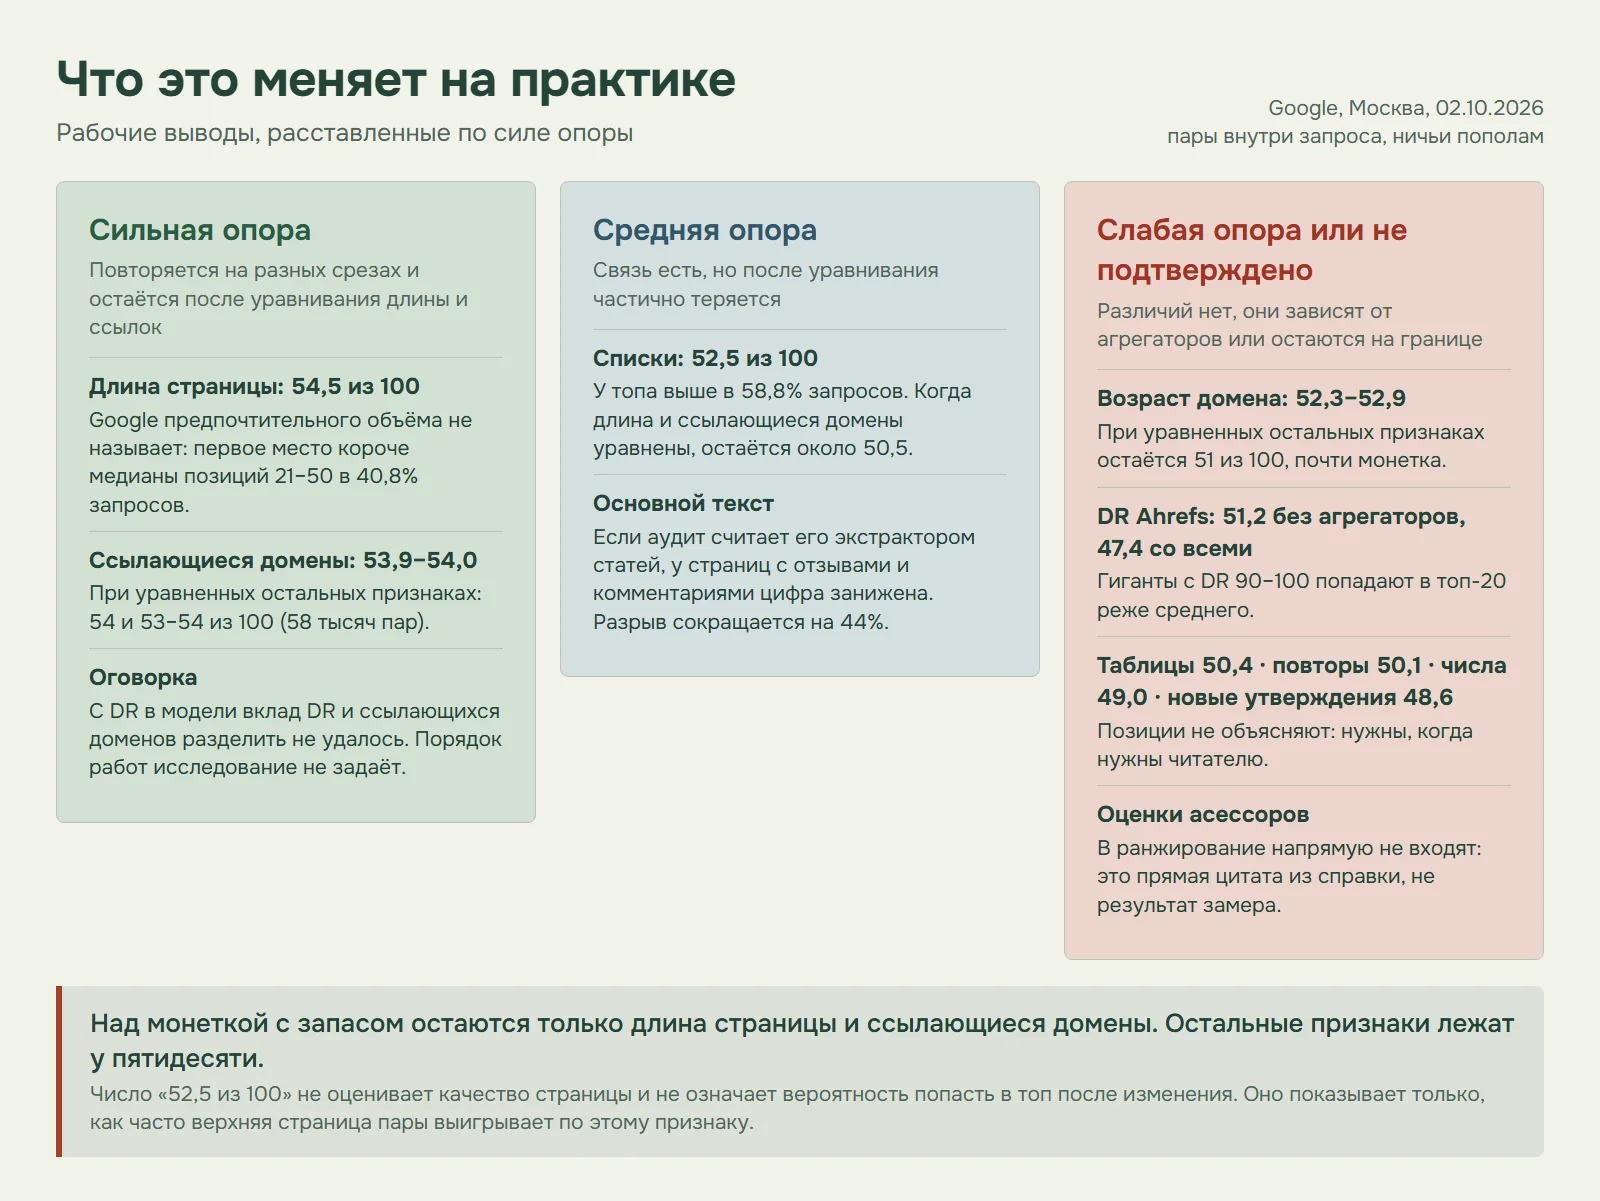
Если свести исследование в рабочие выводы, я бы расставил их по силе опоры. Сильная опора значит, что результат повторяется на разных срезах и остаётся после контроля длины и ссылок. Средняя значит, что связь есть, но после контроля частично теряется. Слабая значит, что различий нет, они зависят от агрегаторов или остаются на границе значимости.
Google, Москва, 02.10.2026, пары внутри запроса, ничьи пополам. Силу опоры определяют повторяемость на срезах и поведение в совместной модели, а не только сам результат: возраст и DR выглядят заметнее, чем держатся после контроля длины и ссылающихся доменов.
Сильная опора.
- Длина и ссылающиеся домены остаются главными из измеренных различий. Длина даёт 54,5 из 100, число ссылающихся доменов 53,9–54,0, а все шесть признаков основного контента лежат в полосе 48,6–52,5. Когда страницы сравнивают при уравненных остальных признаках (58 тысяч пар), длина и ссылающиеся домены остаются заметными: страница длиннее в 3,3 раза оказывается в топ-20 в 54 случаях из 100, страница сайта с в 16–18 раз большим числом ссылающихся доменов в 53–54 (отношение шансов 1,17 и 1,15). Длина при этом не цель, ведь Google предпочтительного объёма не называет, а первое место короче медианы позиций 21–50 в 40,8% запросов. Перед разговором о «качестве контента» полезно сначала сравнить страницу с выдачей по ссылочному и по раскрытию темы. Раскрытие темы в этом замере я не измерял, это рабочая рекомендация по результатам моего прошлого исследования. Оговорка: в модели с DR у ссылающихся доменов остаётся около единицы (0,94), то есть вклад DR и ссылающихся доменов разделить не удалось. Это не повод заниматься ссылками вместо контента: порядок работ исследование не задаёт.
Средняя опора.
- Структура слегка связана с позицией, но не как рычаг. Списки дают 52,5 из 100 и выше у топа в 58,8% запросов. Когда длина и ссылающиеся домены уравнены, связь пропадает: около 50,5 из 100 (отношение шансов 1,02). Списки нужны, когда их ждёт читатель, а не чтобы поднять позицию.
- Проверьте, что ваш инструмент считает основным контентом. Если аудит измеряет «основной текст» экстрактором статей, у страниц с отзывами и комментариями цифра занижена. Добавление размеченных отзывов и комментариев сократило наблюдаемый разрыв по доле основного текста на 44%. Не считайте эти блоки «лишними», ведь по определению Google пользовательские вклады могут быть основным контентом, если прямо выполняют цель страницы.
Слабая опора или не подтверждено.
- Оценки асессоров в ранжирование напрямую не входят. Это прямая цитата из справки, она не результат замера. Цитата закрывает спор «давайте подтянем усилие и оригинальность по методичке», но не закрывает вопрос, влияют ли на ранжирование сами качества. Измеримые текстовые прокси их почти не различают, а настоящие усилие и оригинальность я не измерял.
- Возраст домена может служить прокси ссылок. Сам по себе возраст даёт 52,3–52,9 из 100 (старше домен у страницы из топ-20 примерно в 52–53 парах из 100), но когда длина и ссылающиеся домены уравнены, остаётся 51 из 100, то есть почти монетка (отношение шансов 1,04, интервал 0,98–1,10). Самостоятельная связь возраста с позицией не выявлена, механизм замещения данные не доказывают.
- DR не даёт устойчивого сигнала для позиции страницы. Среди часто встречающихся сайтов DR различает топ-20 и позиции 21–50 на 51,2 из 100 без агрегаторов (почти монетка) и на 47,4 со всеми сайтами (чаще выше у страницы ниже в выдаче): гиганты с DR 90–100 (YouTube, Instagram и подобные) попадают в топ-20 реже среднего. Это сравнение внутри уже заметных сайтов, потому что DR собран для 71% результатов. Качество ссылочных доноров и эффект размещения ссылки исследование не проверяло.
- «Уникальность» как число, числа и таблицы позиций не объясняют. Они нужны, когда они нужны читателю.
Как пользоваться. Сравнивайте страницу с выдачей своего запроса, своей ниши и своего типа страницы, потому что каталоги, статьи, форумы и видео устроены по этим признакам по-разному, а среднее по топу для такого сравнения слишком грубо. Называйте границу. Вы измерили признаки текста и ссылок, оценок асессоров у вас нет, а связь не равна причине.
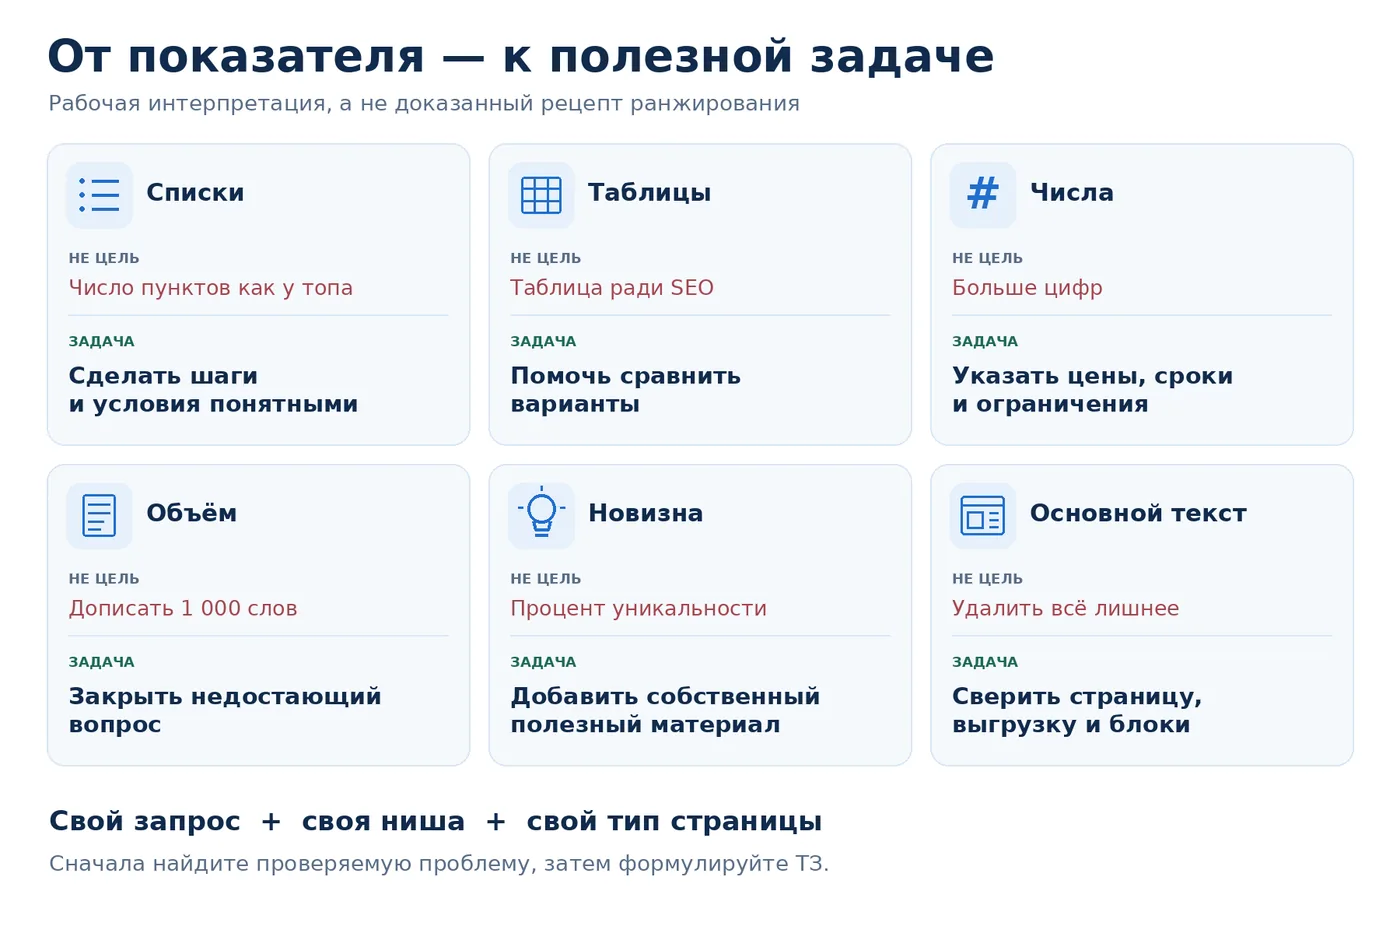
Что делать с измеренными признаками
Это не рекомендации, доказанные исследованием, а моя рабочая интерпретация: как не превратить наблюдаемые показатели в механическое ТЗ.
| Что проверяем | Вывод, который не нужно делать автоматически | Как сформулировать полезную задачу |
|---|---|---|
| Списки | «Довести число пунктов до уровня конкурентов» | Найти перечисления, условия и последовательности, которые трудно воспринимать в сплошном тексте |
| Таблицы | «Добавим таблицу ради SEO» | Выделить характеристики, которые пользователю нужно сравнить между вариантами |
| Числа | «Нужно больше цифр на 1 000 слов» | Добавить недостающие цены, сроки, размеры и ограничения там, где без них нельзя принять решение |
| Объём | «Дописать ещё тысячу слов» | Найти вопрос или действие, которое страница пока не закрывает |
| Новизна утверждений | «Повысить процент уникальных фактов» | Найти собственный полезный материал, которого не хватает для решения задачи |
| Доля основного текста | «Удалить всё лишнее» | Проверить состав выгрузки и назначение блоков до любых изменений страницы |
Число «52,5 из 100» не оценивает качество страницы и не означает вероятность попасть в топ после добавления списка. Оно показывает только, как часто верхняя страница пары выигрывает по этому признаку.
Ещё одно разграничение. «Различие достаточно устойчиво в этом анализе» и «изменение показателя даст заметный рост позиций» — разные утверждения. Даже хорошо подтверждённое наблюдение не становится способом оптимизации автоматически. А отсутствие установленного эффекта на позиции не отменяет пользы таблицы, инструкции или удобного интерфейса для посетителя.
Наш блог по тем же метрикам
Я прогнал по тем же признакам 37 статей этого блога. Корпус состоит из коммерческих и справочных страниц 16 ниш, а наши статьи исследовательские, поэтому сравнение показывает только положение на шкале, качества оно не оценивает.
| Признак | Медиана блога | Медиана корпуса | Процентиль статьи в корпусе |
|---|---|---|---|
| Таблицы на 1 000 слов | 1,30 | 0,00 | 95 |
| Числа на 1 000 слов | 24,6 | 30,6 | 42 |
| Пункты списков на 1 000 слов | 9,7 | 10,6 | 48 |
| Доля основного текста | 0,77 | 0,48 | 85 |
Медианная статья блога: 4 293 слова. По таблицам блог на 95-м процентиле корпуса, по числам и спискам около медианы. Повторы предложений в статьях выглядели выше медианы корпуса, но это оказалось ошибкой моего подсчёта, о ней ниже.
Чего это исследование не показывает
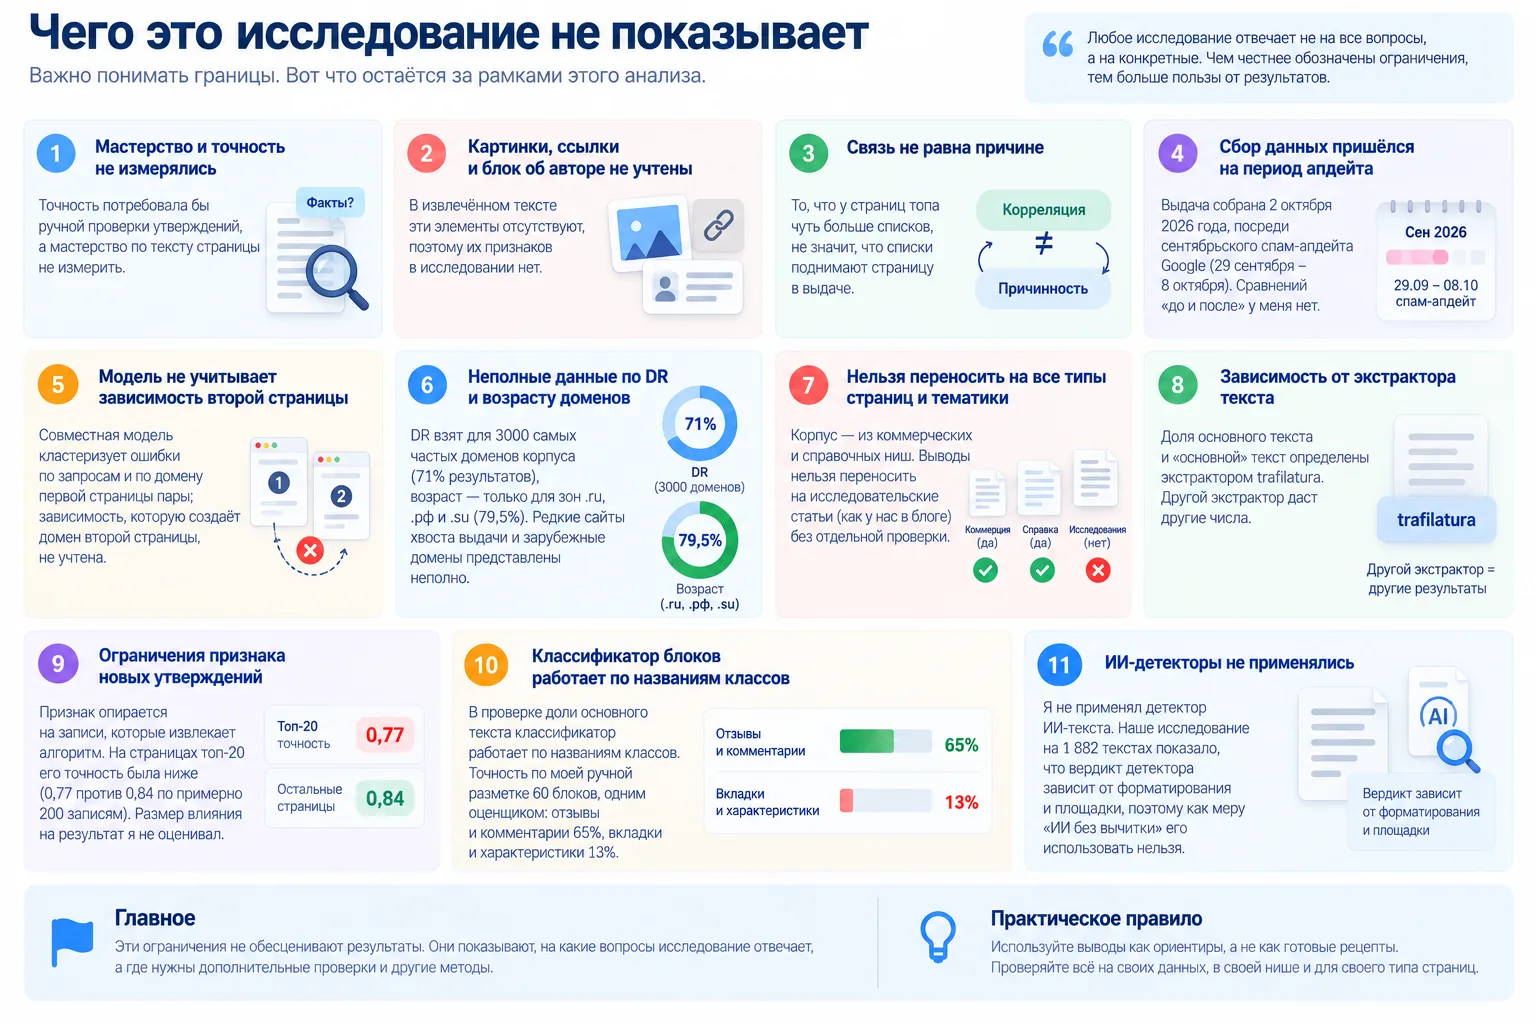
- Мастерство и точность не измерялись. Точность потребовала бы ручной проверки утверждений, мастерство по тексту страницы не измерить.
- Картинки, ссылки и блок об авторе в извлечённом тексте отсутствуют, поэтому их признаков нет.
- Связь не равна причине. То, что у страниц топа чуть больше списков, не значит, что списки поднимают страницу.
- Выдача собрана 2 октября 2026 года, посреди сентябрьского спам-апдейта Google (29 сентября – 8 октября). Сравнения «до и после апдейта» у меня нет.
- Совместная модель кластеризует ошибки по запросам и по домену первой страницы пары; зависимость, которую создаёт домен второй страницы, не учтена. При кластеризации только по запросам интервалы у возраста (1,00–1,08) и DR (1,02–1,13) сдвигаются от единицы, поэтому о них я говорю как о значениях на границе значимости.
- DR взят для 3000 самых частых доменов корпуса (71% результатов), возраст только для зон .ru, .рф и .su (79,5%). Редкие сайты хвоста выдачи и зарубежные домены в этих сравнениях представлены неполно.
- Корпус из коммерческих и справочных ниш. Выводы нельзя переносить на исследовательские статьи, как у нас в блоге, без отдельной проверки.
- Доля основного текста и «основной» текст определены экстрактором trafilatura; другой экстрактор даст другие числа.
- Признак новых утверждений опирается на записи, которые извлекает алгоритм, и на страницах топ-20 его точность была ниже (0,77 против 0,84 по примерно 200 записям). Размер влияния на результат я не оценивал.
- Классификатор блоков в проверке доли основного текста работает по названиям классов. Точность по моей ручной разметке 60 блоков, одним оценщиком: отзывы и комментарии 65%, вкладки и характеристики 13%.
- Я не применял детектор ИИ-текста. Наше исследование на 1 882 текстах показало, что вердикт детектора зависит от форматирования и площадки, поэтому как меру «ИИ без вычитки» его использовать нельзя.
Частые вопросы
Любую часть страницы, которая прямо помогает ей достичь цели: основной текст и медиа, интерактивные функции вроде калькуляторов, пользовательские вклады (обсуждения, отзывы, комментарии), если они прямо выполняют цель страницы, информацию во вкладках и раскрывающихся блоках, а также заголовки страницы и разделов. Список взят из справки Google, страница с отметкой «Last updated 2026-10-05 UTC».
Слабо. На 84 848 результатах выдачи лучший из шести измеримых признаков, пункты списков, дал 52,5 из 100 при монетке в 50. Числа, доля основного текста и новизна утверждений дали 48,6–49,0, таблицы и повторы предложений 50,4 и 50,1. Длина страницы в том же корпусе даёт 54,5, ссылающиеся домены 54,0.
Напрямую нет. Справка Google говорит, что асессоры не управляют ранжированием и их данные не используются напрямую в алгоритмах, а нужны, как карточки отзывов в ресторане, чтобы понять, хорошо ли работают системы. Это не исключает других сигналов, связанных с усилием и оригинальностью: замер проверял только грубые текстовые прокси.
Справка Google отвечает на вопрос «Пишете ли вы под определённое число слов, потому что слышали, что у Google есть предпочтительный объём?» словами «(No, we don't.)». В данных длина всё же связана с позицией: 54,5 из 100. Это среднее по корпусу, и первое место короче медианы позиций 21–50 в 40,8% из 1823 запросов.
Экстрактор статей вырезает статью и не засчитывает ветку комментариев, а по определению Google пользовательские вклады могут быть основным контентом. При добавлении размеченных отзывов и комментариев наблюдаемый разрыв по доле основного текста между топ-20 и позициями 21–50 сократился с 1,36 до 0,76 процентного пункта, на 44%. Цифра описательная, классификатор проверял один оценщик.
В этих данных слабо. Возраст домена даёт 52,3 из 100 (домен страницы из топ-20 старше в 52 парах из 100), но когда длина и ссылающиеся домены уравнены, остаётся 51 из 100 (отношение шансов 1,04, интервал 0,98–1,10): самостоятельная связь не выявлена. DR Ahrefs даёт 47,4 со всеми сайтами и 51,2 без агрегаторов, потому что гиганты с DR 90–100 попадают в топ-20 реже среднего. DR собран для 3000 самых частых доменов (71% результатов), а качество ссылочных доноров исследование не проверяло.
Соберите топ-50 Google по 30–50 запросам вашей ниши в один день, регион и устройство. Выделите основной текст экстрактором, посчитайте признаки на 1000 слов, сравните топ-20 и позиции 21–50 внутри каждого запроса и сосчитайте долю запросов, где у топа значение выше. Для вывода при двусторонней проверке знаков (p меньше 0,05) нужно 21 из 30 запросов, 33 из 50, 61 из 100 или 115 из 200.
Как это считалось
Раздел для тех, кто хочет проверить расчёт.
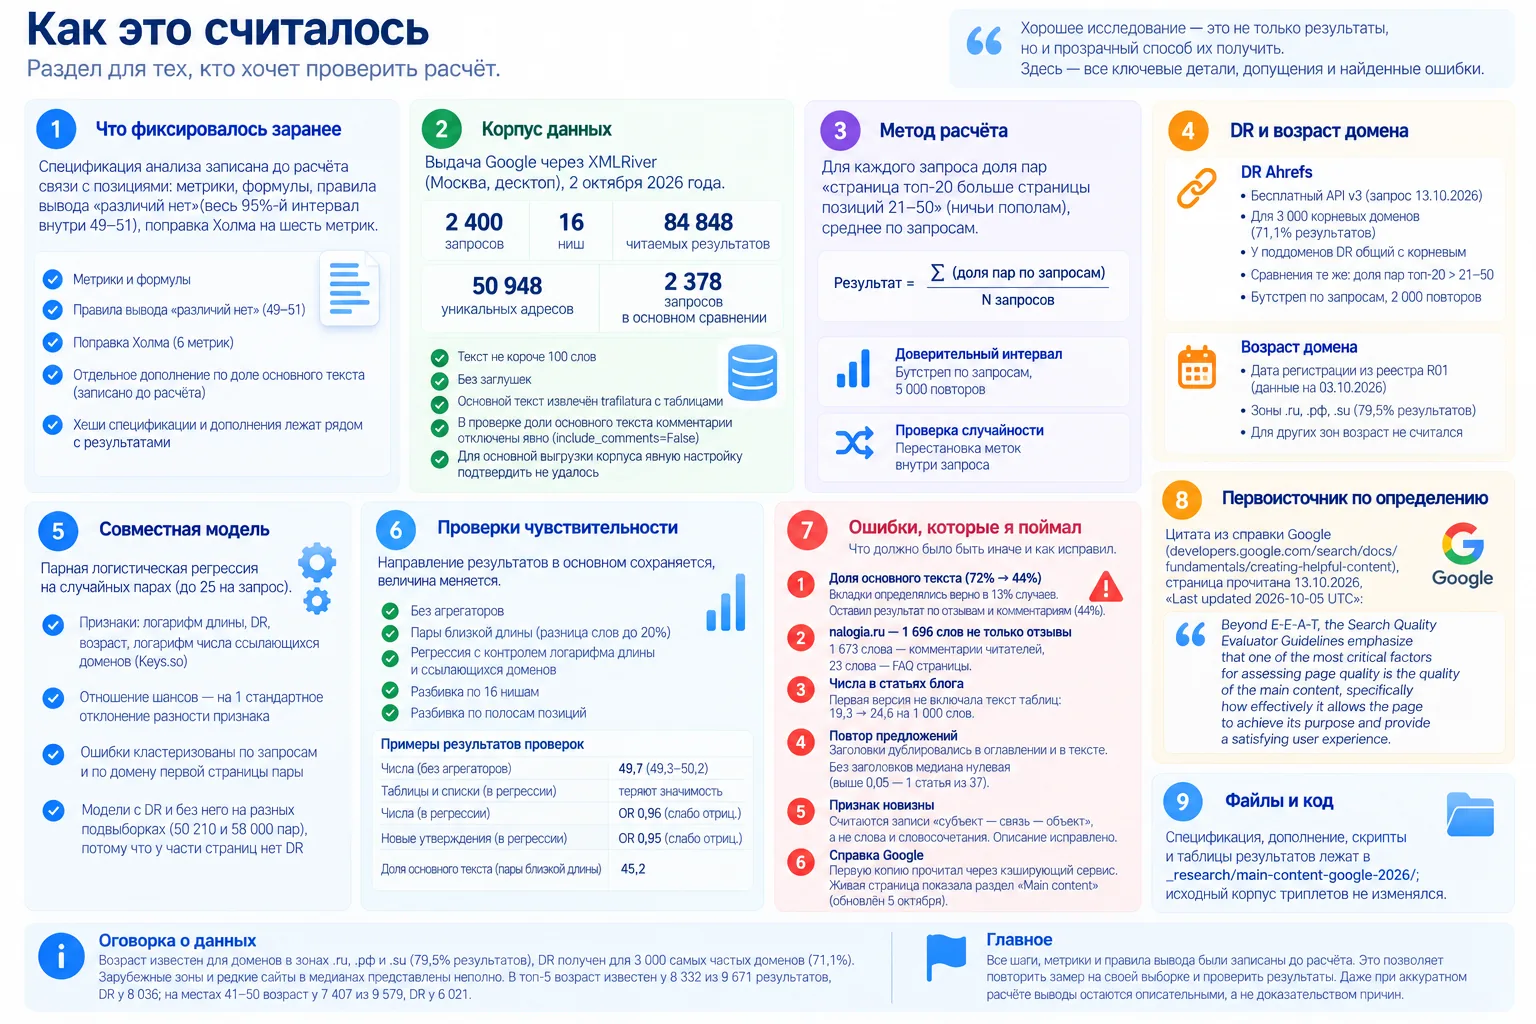
Что фиксировалось заранее. Спецификация анализа записана до расчёта связи с позициями: метрики, формулы, правила вывода «различий нет» (весь 95%-й интервал внутри 49–51), поправка Холма на шесть метрик. Проверка доли основного текста вынесена в отдельное дополнение, записанное до её расчёта, с критериями подтверждения.
Корпус. 2 400 запросов, 16 ниш, выдача Google через XMLRiver (Москва, десктоп), 2 октября 2026 года; 84 848 читаемых результатов выдачи (50 948 уникальных адресов; текст не короче 100 слов, не заглушка), 2 378 запросов в основном сравнении. Основной текст извлечён trafilatura с таблицами. В проверке доли основного текста комментарии отключены явно (include_comments=False); для основной выгрузки корпуса явную настройку по сохранённым скриптам подтвердить не удалось.
Метод. Для каждого запроса доля пар «страница топ-20 больше страницы позиций 21–50» (ничьи пополам), среднее по запросам. Интервал: бутстреп по запросам, 5 000 повторов; проверка случайности перестановкой меток внутри запроса.
DR и возраст домена. DR (Domain Rating by Ahrefs, бесплатный API v3, запрос 13.10.2026) собран для 3000 корневых доменов, на которые приходится 71,1% результатов выдачи; у поддоменов DR общий с корневым. Возраст — дата регистрации из реестра зон R01 (данные на 03.10.2026) для .ru, .рф, .su, 79,5% результатов; для других зон возраст не считался. Сравнения те же, что для признаков текста: доля пар «топ-20 выше позиций 21–50» внутри запроса, бутстреп по запросам, 2000 повторов. Совместная модель: парная логистическая регрессия на случайных парах (до 25 на запрос), логарифм длины, DR, возраст и логарифм числа ссылающихся доменов. Отношение шансов дано на одно стандартное отклонение разности признака между двумя страницами пары. Ошибки кластеризованы по запросам и по домену первой страницы пары. Модели с DR и без него считались на разных подвыборках (50 210 и 58 000 пар), потому что у части страниц нет DR.
Проверки чувствительности. Без агрегаторов, пары близкой длины (разница слов до 20%), парная логистическая регрессия с контролем логарифма длины и логарифма числа ссылающихся доменов (данные Keys.so), разбивка по 16 нишам и по полосам позиций. Направление результатов в основном сохраняется, величина меняется. Без агрегаторов результат по числам уходит к 50 (49,7; интервал 49,3–50,2). В регрессии с контролем длины и ссылающихся доменов таблицы и списки перестают быть значимыми, числа и новые утверждения остаются слабо отрицательными (отношение шансов на 1 SD 0,96 и 0,95). Доля основного текста на парах близкой длины даёт 45,2, то есть эффект сильнее.
Ошибки, которые я поймал.
- Первый вариант проверки доли основного текста показывал, что 72% разрыва объясняют отзывы, вкладки и интерактив. Ручной аудит классификатора (по 60 блоков каждой категории) это изменил: вкладки определялись верно в 13% случаев, и остался результат по отзывам и комментариям, 44%. Это самая важная поправка в исследовании. Я открыл HTML двух страниц Госуслуг, чтобы описать их в разборе, и увидел, что в «раскрывающихся блоках» лежат списки похожих вопросов, а инструкции там нет, хотя сначала я предположил обратное.
- В разборе выдачи я сначала записал, что на nalogia.ru весь блок из 1 696 слов относится к отзывам. Разбор показал: 1 673 слова — комментарии читателей, 23 слова — FAQ страницы.
- Первая версия подсчёта для блога не включала текст таблиц: числа на 1 000 слов у статей получались 19,3 вместо 24,6, а слов выходило меньше. Меня насторожило, что у насыщенных данными статей числа ниже медианы корпуса; причину нашёл в коде и пересчитал.
- Повтор предложений у блога выглядел выше медианы корпуса (78-й процентиль). Причина оказалась в заголовках: они дублировались в оглавлении и в тексте. Без заголовков медиана нулевая, выше 0,05 лишь одна статья из 37 (инструкция по триплетам, где однотипные шаги трёх способов повторяются дословно).
- В описании признака новизны я сначала написал, что он считает «слова и словосочетания». Когда открыл скрипт, оказалось, что считаются записи «субъект — связь — объект». Описание исправлено.
- Первую копию справки Google я прочитал через кэширующий сервис: нового раздела в ней не было. Живая страница, открытая через браузер, показала раздел «Main content» с отметкой 5 октября. Кэшированное чтение доказательством считать нельзя.
Первоисточник по определению. Цитата из справки Google (developers.google.com/search/docs/fundamentals/creating-helpful-content, страница прочитана 13.10.2026, «Last updated 2026-10-05 UTC»): «Beyond E-E-A-T, the Search Quality Evaluator Guidelines emphasize that one of the most critical factors for assessing page quality is the quality of the main content, specifically how effectively it allows the page to achieve its purpose and provide a satisfying user experience.»
Выборка для проверки
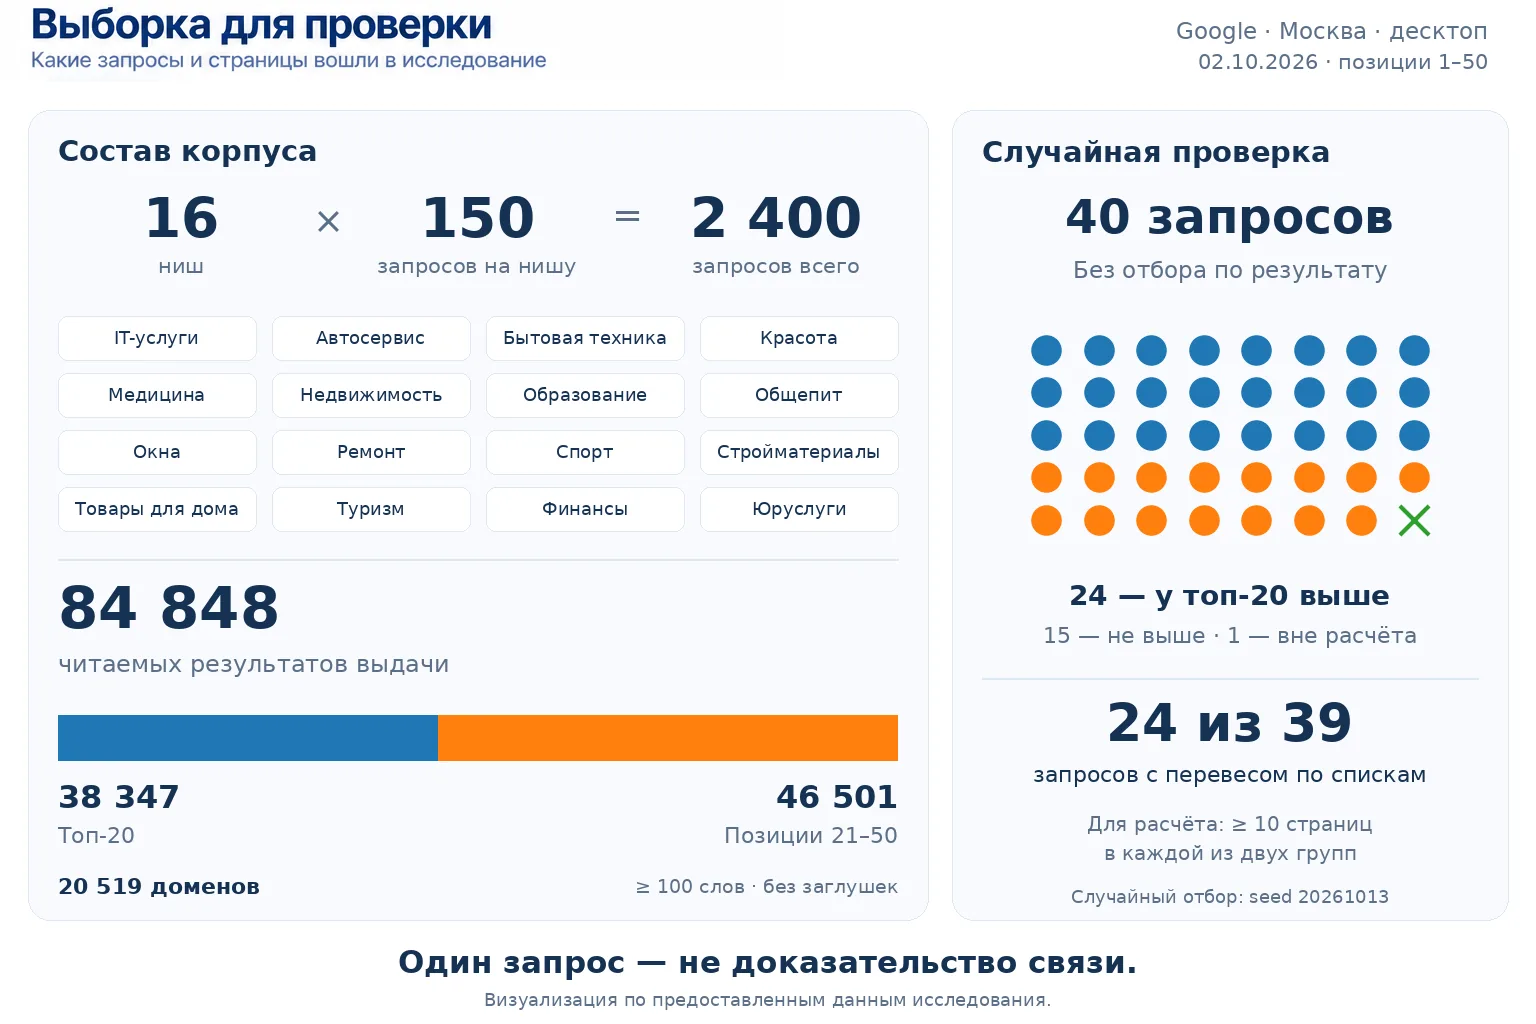
Чтобы выводы можно было проверить, ниже данные выборки: из каких запросов и страниц она состоит и как выглядят результаты на случайных запросах без отбора. Страницы собраны одним снимком выдачи Google (Москва, десктоп, 02.10.2026), позиции с 1 по 50.
Состав выборки по нишам
| Ниша | Запросов | Результатов выдачи | Топ-20 | Позиции 21–50 | Доменов |
|---|---|---|---|---|---|
| IT-услуги | 150 | 5 867 | 2 558 | 3 309 | 1 947 |
| автосервис | 150 | 5 434 | 2 502 | 2 932 | 1 887 |
| бытовая техника | 150 | 4 891 | 2 279 | 2 612 | 1 292 |
| красота | 150 | 5 163 | 2 419 | 2 744 | 2 091 |
| медицина | 150 | 5 942 | 2 626 | 3 316 | 1 974 |
| недвижимость | 150 | 5 099 | 2 189 | 2 910 | 1 802 |
| образование | 150 | 5 352 | 2 450 | 2 902 | 1 576 |
| общепит | 150 | 4 937 | 2 144 | 2 793 | 1 429 |
| окна | 150 | 5 283 | 2 495 | 2 788 | 1 340 |
| ремонт | 150 | 5 588 | 2 476 | 3 112 | 1 381 |
| спорт | 150 | 4 751 | 2 207 | 2 544 | 1 315 |
| стройматериалы | 150 | 5 416 | 2 552 | 2 864 | 1 536 |
| товары для дома | 150 | 4 809 | 2 200 | 2 609 | 1 673 |
| туризм | 150 | 5 021 | 2 273 | 2 748 | 919 |
| финансы | 150 | 5 531 | 2 445 | 3 086 | 802 |
| юруслуги | 150 | 5 764 | 2 532 | 3 232 | 1 672 |
| Всего | 2 400 | 84 848 | 38 347 | 46 501 | 20 519 |
Число результатов — читаемые страницы после исключения заглушек и текстов короче 100 слов, поэтому на запрос приходится меньше 50 строк. Один адрес может стоять в выдачах нескольких запросов, поэтому доменов меньше, чем результатов.
Сорок случайных запросов
Сорок запросов выбраны случайно до просмотра результатов и показаны все, включая те, где результат против гипотезы. Способ воспроизвести выбор: взять 2400 запросов корпуса в алфавитном порядке и вызвать random.Random(20261013).sample(список, 40). Результат по спискам посчитан только там, где в каждой группе не меньше десяти страниц; из 39 таких запросов у топа значение выше в 24. Это та же шкала «из 100», что и в основной таблице, только для одного запроса: отдельный запрос шумит на ±10 пунктов, поэтому по нему одному выводов не делают.
Таблица: сорок случайных запросов
| Запрос | Ниша | Топ-20, стр. | 21–50, стр. | Списки, медиана (топ-20 / 21–50) | Результат по спискам из 100 |
|---|---|---|---|---|---|
| интернет проекта | IT-услуги | 13 | 19 | 6,8 / 4,5 | 59,9 |
| ошибки приложений | IT-услуги | 16 | 21 | 6,6 / 0,0 | 55,4 |
| создание дизайна приложения | IT-услуги | 19 | 23 | 11,6 / 14,2 | 43,0 |
| создание своего приложения | IT-услуги | 15 | 25 | 11,8 / 11,5 | 57,3 |
| создание фирменного стиля | IT-услуги | 17 | 25 | 15,1 / 8,3 | 56,2 |
| лучшая стиральная машина 2026 | бытовая техника | 15 | 19 | 4,3 / 14,2 | 27,2 |
| чем закрыть вытяжку на кухне | бытовая техника | 16 | 14 | 8,4 / 0,0 | 71,9 |
| какой можно сделать макияж | красота | 15 | 10 | 6,3 / 0,0 | 62,0 |
| косметология лица процедуры | красота | 17 | 23 | 26,3 / 11,4 | 66,8 |
| лазерная эпиляция цена за зону | красота | 18 | 23 | 11,8 / 8,2 | 55,2 |
| окрашивание с начесом | красота | 17 | 14 | 8,3 / 12,9 | 43,3 |
| процедуры по лицу | красота | 20 | 20 | 16,1 / 18,5 | 48,0 |
| салон красоты 15 | красота | 9 | 11 | 0,0 / 0,0 | — |
| шрам убрать | красота | 18 | 21 | 22,8 / 18,6 | 52,6 |
| анализы на гипотиреоз | медицина | 18 | 23 | 10,4 / 27,9 | 23,4 |
| гормоны щитовидной железы мужчины | медицина | 19 | 15 | 36,9 / 29,7 | 63,2 |
| купить квартиру новую от застройщика | недвижимость | 17 | 16 | 0,0 / 1,6 | 46,3 |
| м2 новостройки | недвижимость | 11 | 11 | 2,7 / 1,9 | 61,6 |
| школа языков | образование | 13 | 15 | 8,1 / 0,0 | 74,6 |
| язык программирования для начинающих с нуля | образование | 17 | 21 | 9,7 / 9,8 | 53,2 |
| доставка еды пиццы | общепит | 16 | 22 | 0,0 / 22,4 | 32,4 |
| пицца сеть | общепит | 12 | 22 | 0,0 / 4,6 | 42,6 |
| замена стеклопакета двери | окна | 17 | 19 | 15,0 / 13,9 | 51,5 |
| купить пластиковые окна в москве от производителя | окна | 10 | 17 | 21,9 / 0,0 | 80,0 |
| пвх окна инструкция | окна | 19 | 12 | 18,1 / 16,8 | 55,7 |
| процесс ремонта | ремонт | 18 | 23 | 28,9 / 16,9 | 64,6 |
| ремонт в ванной комнате совмещенной с туалетом | ремонт | 15 | 18 | 18,0 / 5,3 | 69,1 |
| ремонт жилых помещений | ремонт | 17 | 20 | 11,2 / 8,1 | 57,1 |
| стоимость капитального ремонта квартиры | ремонт | 17 | 21 | 10,9 / 12,7 | 44,1 |
| черновая отделка квартиры в новостройке что это | ремонт | 19 | 28 | 23,5 / 19,1 | 55,1 |
| септик на дачу для сезонного проживания | стройматериалы | 18 | 27 | 15,5 / 23,8 | 46,0 |
| сколько стоит утеплитель для стен | стройматериалы | 18 | 23 | 9,8 / 28,4 | 38,2 |
| ковер в гостиную на пол | товары для дома | 15 | 18 | 15,6 / 6,7 | 62,2 |
| банк с самым высоким процентом по вкладам | финансы | 18 | 21 | 12,0 / 6,6 | 57,1 |
| вклад на 5 месяцев | финансы | 18 | 21 | 15,9 / 4,8 | 50,0 |
| сколько можно получить налогового вычета | финансы | 16 | 22 | 8,1 / 13,4 | 45,7 |
| сколько сейчас процент по вкладам | финансы | 15 | 26 | 6,2 / 8,4 | 41,8 |
| возмещение имущественного ущерба | юруслуги | 18 | 18 | 16,8 / 7,9 | 65,7 |
| договор поставки основное | юруслуги | 14 | 19 | 12,5 / 9,3 | 53,4 |
| как написать претензию образец | юруслуги | 18 | 26 | 7,5 / 15,7 | 33,8 |
Где смотреть продолжение
Новые замеры и разборы выдачи я публикую в Telegram-канале. Если у вас есть запрос или ниша, где стоит повторить эту проверку, напишите туда или в личные сообщения, и я посмотрю, можно ли это сделать на тех же данных. Разобрать страницу против выдачи её запроса можно в рамках SEO-аудита сайта.